gRPC 拦截器:鉴权、日志与指标埋点
更新时间:2026-09-18。拦截器(Interceptor)是 gRPC 的中间件机制:把鉴权、日志、指标、链路追踪、限流、panic 恢复这些与业务无关的横切关注点从每个方法里抽出来,统一在调用前后织入。理解拦截器链的执行顺序、Unary 与 Stream 两类写法、以及 Metadata 透传,是写好 gRPC 工程化代码的前提。模式基础见 gRPC 四种流模式。
本文要回答的问题
- Unary 和 Stream 拦截器、客户端和服务端拦截器分别长什么样?
- 多条拦截器组成的链按什么顺序执行(洋葱模型)?
- token / traceId 怎么通过 Metadata 透传?鉴权放哪一层?
- 日志、Prometheus 指标、panic 恢复、deadline 传播怎么统一做?
- 为什么不要在业务方法里散落鉴权和 try/catch?
一、两类两侧:四种拦截器
bash
                 Unary 调用              Stream 调用
服务端端   ServerInterceptor       包装 ServerCallStreamObserver
客户端端 ClientInterceptor 包装 ClientCall/Listener- 客户端拦截器:在请求发出前后做事(注入 token、记录耗时、客户端重试、附加 deadline)。
- 服务端拦截器:在真正业务方法前后做事(校验 token、打日志、埋点、恢复 panic)。
- Unary 拦截器拦截普通一元调用;Stream 拦截器要包装双向流的 observer,在 onNext/onComplete 上加逻辑。
二、Unary 拦截器与洋葱顺序
java
// 服务端:鉴权 + 日志 + 恢复 的组合
public class AuthInterceptor implements ServerInterceptor {
  public <Q,S> ServerCall.Listener<Q> interceptCall(
      ServerCall<Q,S> call, Metadata headers, ServerCallHandler<Q,S> next) {
    String token = headers.get(Metadata.Key.of("authorization", ASCII_STRING_MARSHALLER));
    if (!jwt.verify(token)) {
      call.close(Status.UNAUTHENTICATED.withDescription("bad token"), new Metadata());
      return new ServerCall.Listener<>(){};          // 拒绝,不进入业务
    }
    // 透传 traceId 到 Context,下游可取出
    Context ctx = Context.current().withValue(TRACE_KEY, headers.get(TRACE_META_KEY));
    return Contexts.interceptCall(ctx, call, headers, next);
  }
}
go
// Go:Unary 拦截器统一日志/指标/recover/deadline
func unaryInterceptor(ctx context.Context, req any,
    info *grpc.UnaryServerInfo, handler grpc.UnaryHandler) (any, error) {
    start := time.Now()
    defer func() { // panic 恢复,避免一个请求拖垮整个进程
        if r := recover(); r != nil {
            metrics.PanicCounter.Inc()
        }
    }()
    resp, err := handler(ctx, req) // 放行到下一个拦截器/业务
    code := status.Code(err)
    metrics.RequestCounter.WithLabelValues(info.FullMethod, code.String()).Inc()
    log.Info(info.FullMethod, "code=", code, "cost=", time.Since(start))
    return resp, err
}
s := grpc.NewServer(grpc.UnaryInterceptor(grpc_middleware.ChainUnaryServer(
    recoveryInterceptor, authInterceptor, metricInterceptor, logInterceptor,
)))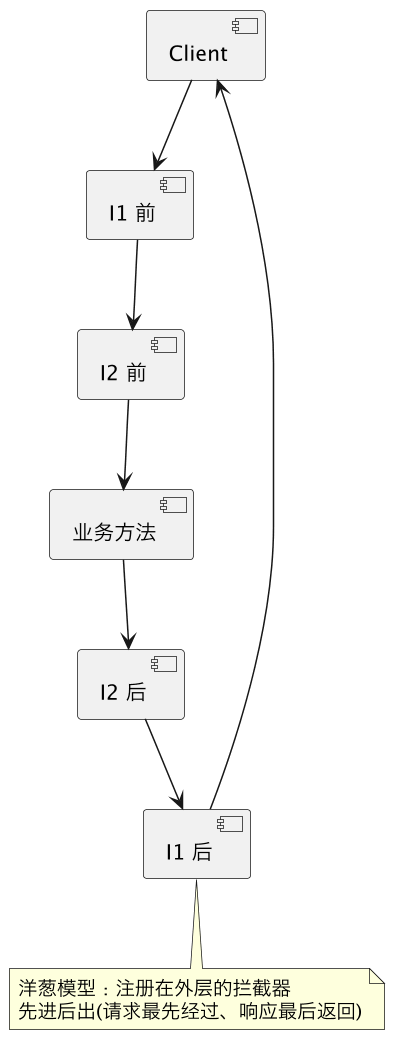
多条拦截器按注册顺序嵌套,请求时从外到内、响应时从内到外。鉴权/限流这类「可提前拒绝」的放外层,避免无谓执行;日志/指标要包住全过程。
三、Metadata:透传 token 与 traceId
gRPC 的元数据等价于 HTTP/2 的头部(小写、键不区分大小写)。客户端在 stub 上附加:
java
// 客户端拦截器:每次调用自动注入 token
ClientInterceptor auth = (method, opts, next) -> {
    Metadata h = new Metadata();
    h.put(Metadata.Key.of("authorization", ASCII_STRING_MARSHALLER), "Bearer "+token());
    return next.newCall(method, CallOptions.DEFAULT)
               .withInterceptors(); // 实际用 Headers 附着
};
go
// Go 客户端附加,服务端从 md 取
ctx = metadata.AppendToOutgoingContext(ctx, "authorization", "Bearer "+t, "x-trace-id", tr)
md, _ := metadata.FromIncomingContext(ctx)
注意元数据随调用传播,但 Context 里的值不会自动跨 RPC 传——要跨服务传 traceId/租户号,必须显式放进 metadata,下游再取出放进自己的 Context(链路追踪库自动做这件事)。
四、日志、指标、错误码与 deadline
- 结构化日志:记录 method、gRPC status code、耗时、traceId、调用方;不要打印整个请求体(含隐私且可能很大)。
- 指标:每个 method 的 QPS、错误率(按 status code 维度)、延迟直方图(Prometheus histogram 才能算 P99),用拦截器统一埋,业务零侵入。
- 错误码:业务错误统一映射为
status.Status+ code(INVALID_ARGUMENT/NOT_FOUND/PERMISSION_DENIED/INTERNAL...),在拦截器边界把内部异常转成对外 code,避免泄露堆栈。 - deadline 传播:客户端设置的 deadline 随 HTTP/2
grpc-timeout头传到服务端,服务端应尊重ctx截止时间并继续向下游传播,形成全链路超时;拦截器可设置默认 deadline 兜底。 - Stream 拦截器:包装发送/接收观察者,在
onNext(消息计数/校验)、onClose(状态码/耗时)上织入同样的逻辑,与 Unary 保持口径一致。
五、坑与对照
- 鉴权散落在每个方法。 漏一个方法就越权;统一放服务端拦截器,公开方法用白名单。
- 拦截器顺序错乱。 把重逻辑放最外层、鉴权放内层,会让未授权请求也吃满开销。
- 以为 Context 自动跨服务。 只有 metadata 会随 RPC 传播,业务上下文要显式塞 header。
- 不恢复 panic。 流式/普通调用里 panic 若不兜,可能断掉连接甚至影响进程稳定。
- 拦截器里做重业务或阻塞。 它跑在请求路径上,重活要异步;埋点标签基数别用 user_id/order_id,否则指标爆炸。
- 只拦 Unary 忘了 Stream。 双向流方法需要专门的 stream 拦截器,否则这些接口「裸奔」。
超时与连接保活见 gRPC keepalive 与多路复用;流本身的语义见 四种流模式。
总结
gRPC 拦截器:分 Unary/Stream 两类、客户端/服务端两侧,按洋葱模型从外到内进、从内到外出,应把鉴权限流等可提前拒绝的放外层、把统一日志和 Prometheus 指标(method+code+延迟直方图)及 panic 恢复包住全程;token 与 traceId 经 Metadata(HTTP/2 头)显式透传,Context 业务值不会自动跨 RPC;错误在边界统一映射为 gRPC status code、deadline 沿 grpc-timeout 全链路传播,且务必同时为 Unary 和 Stream 两类方法配齐拦截器,埋点标签避免高基数。