WebSocket 心跳保活与断线重连设计
更新时间:2026-09-18。WebSocket「连上了但老断」「断了不知道」是实时功能最常见的两类故障。根因是:TCP 不会在对端突然消失时立刻通知你(拔网线、杀进程、NAT 回收),形成半开连接,要靠应用层心跳才能发现;而移动网络切后台、弱网又让断线成为常态,必须设计自动重连与断线期间的消息补偿。基础见 WebSocket 与 SSE,选型见 SSE 与 WebSocket 怎么选。
本文要回答的问题
- 为什么连接「断了」双方却不知道?TCP keepalive 为什么不够?
- 应用层心跳怎么设计(间隔、超时、几次失败判死)?
- 前端自动重连怎么做指数退避、抖动和上限?切回前台如何立即尝试?
- 断线期间的消息怎么不丢?ACK + 序列号重放如何实现?
- onclose 的 code(1000/1001/1006/1008/1011)分别怎么处理?
一、半开连接:为什么必须应用层心跳
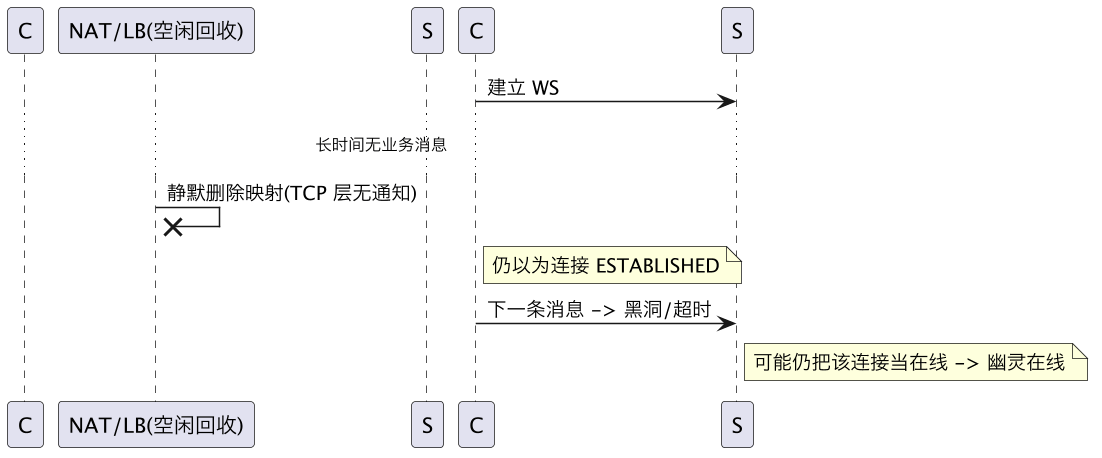
TCP 有 keepalive,但默认两小时才探测、且各层可配性差,远不能满足实时需求。所以用 WebSocket 协议自带的 ping/pong 控制帧(服务端发起最常见)或应用层心跳消息(如 {"type":"ping"})主动探测:在约定时间内没收到任何数据(含 pong/业务消息)就判定失活。
二、心跳设计
参数经验值(按业务实时性/电量取舍):
  ping 间隔        25~30s(短于多数 NAT/LB 的 60s 空闲回收)
  pong 超时        10s
  连续失败次数     2~3 次 -> 判定连接死亡,主动关闭重连
服务端空闲超时 60~90s 无任何帧 -> 清理连接// 客户端心跳(浏览器无主动 ping API 时用应用层消息)
class KeepAliveWS {
constructor(url) { this.url=url; this.seq=0; this.ackSeq=0; this.pending=new Map(); }
connect() {
this.ws = new WebSocket(this.url);
this.ws.onopen = () => { this.resetBackoff(); this.startHeartbeat(); this.resend(); };
this.ws.onmessage = (e) => {
const m = JSON.parse(e.data);
if (m.type === 'pong') { this.lastRecv = Date.now(); return; }
if (m.type === 'ack') { this.pending.delete(m.seq); return; } // 服务端确认
this.onMessage(m);
};
this.ws.onclose = (e) => { this.stopHeartbeat(); this.scheduleReconnect(e.code); };
this.ws.onerror = () => { this.ws.close(); };
this.lastRecv = Date.now();
}
startHeartbeat() {
this.timer = setInterval(() => {
if (Date.now()-this.lastRecv > 60000) { this.ws.close(); return; } // 超时判死
this.send({type:'ping'});
}, 25000);
}
stopHeartbeat(){ clearInterval(this.timer); }
}要点:心跳要「收到任何数据都续命」,不必死等 pong,业务消息也说明连接活着;客户端与服务端任一方都可发起,但要明确谁主导避免双倍 ping;服务端据此清理幽灵连接、释放订阅资源。
三、自动重连:指数退避 + 抖动 + 上限
scheduleReconnect(code) {
  // 鉴权失败(1008) 等不可恢复错误,不要无脑重连
  if (code === 1008 || code === 1007) { this.redirectLogin(); return; }
  if (this.attempts >= 8) { this.onDead(); return; }              // 上限,避免无限耗电
  const base = Math.min(1000 * 2 ** this.attempts, 30000);       // 1s,2s,...封顶30s
  const delay = base + Math.random() * 1000;                     // 抖动,避免群体重连风暴
  this.attempts++;
  setTimeout(() => this.connect(), delay);
}- 退避:1→2→4→8s…封顶,避免服务故障时重连风暴把它彻底压垮。
- 抖动(jitter):大量客户端在同一时刻断线,若无随机偏移会整秒齐刷重连,造成「重连惊群」。
- 页面可见性:移动端切后台 WS 常被系统挂起,监听
visibilitychange,回到前台立即检测并尝试一次重连,而不是等下一个退避周期。 - 网络状态:
online事件触发立即重连。 - 重连成功后
attempts归零。
四、断线期间消息不丢:ACK + 序列号
发送:每条消息带递增 seq,写入 pending 队列
服务端:处理后回 {type:'ack', seq};客户端收到才从 pending 删除
重连:带上「最后已收服务端消息序号 lastServerSeq」
     1) pending 中未 ack 的消息重发(resend)
     2) 服务端据 lastServerSeq 推送离线期间漏掉的消息(补发)
这套机制把 WebSocket 从「尽力而为」提升到至少一次投递,服务端需按 seq 幂等去重(重复 ack/重复投递无害)。注意区分:连接状态可靠 ≠ 消息可靠,光重连只能保证通道恢复,离线那几分钟的消息必须靠序列号补发,否则会「重连成功但丢了消息」。可靠性要求更高的消息应走持久化通道(IM 消息常由服务端存漫游)。
五、关闭码与坑
| code | 含义 | 处理 |
|---|---|---|
| 1000 | 正常关闭 | 按需重连 |
| 1001 | 端点离开(页面跳转/服务下线) | 可重连 |
| 1006 | 异常断开(无 close 帧) | 最常见,网络/服务崩,退避重连 |
| 1007/1008 | 数据格式/策略(鉴权)失败 | 不要盲目重连,先重新登录 |
| 1011 | 服务端内部错误 | 退避重连 |
| 1012/1013 | 服务重启/过载 | 退避后重试 |
常见坑:① 只靠 TCP/不发心跳导致幽灵在线;② 固定 1s 无上限重连引发惊群和耗电;③ 心跳发了却不用任何响应刷新判活;④ 重连后不补发,以为通道恢复=没丢消息;⑤ 鉴权过期仍无限重连刷错误日志;⑥ 多标签页/组件重复 new 连接,未做单例与清理。
服务端大规模连接的水平扩展(连接网关、消息路由)配合 Redis 发布订阅/Cluster 等做跨节点路由;SSE 单向推送场景见 SSE vs WebSocket。
总结
WebSocket 心跳与重连:对端突然消失时 TCP 不会及时通知,必须用应用层 ping/pong(间隔 25~30s 短于 NAT 回收、pong 超时 10s、连续 2~3 次无任何数据即判死,服务端同步清理空闲连接)发现半开连接;前端重连用指数退避(1→30s 封顶)+随机抖动防惊群+次数上限,并在 visibilitychange/online 时立即尝试,鉴权类关闭码(1007/1008)先登录不盲目重连;仅恢复通道不等于不丢消息,要加「客户端 seq+ACK 重发、重连带 lastServerSeq 由服务端幂等补发」才能保证离线消息不丢。