Prometheus exporter 与服务发现:指标怎么采上来
更新时间:2026-09-19。前置:Prometheus 数据模型。Prometheus 本身不生产指标,它周期性地去各目标的 HTTP 端点「拉」指标,负责把已有系统指标翻译成 Prometheus 格式的组件就是 exporter。这篇讲清指标从哪来、目标怎么被自动发现。
一、Pull 模式:Prometheus 主动来抓
目标暴露文本格式指标(GET /metrics)
  node_exporter(:9100) / mysqld_exporter / 应用自身 /metrics
        ↑ Prometheus server 每隔 scrape_interval 主动 GET
        ↑ 目标清单从何而来 → 服务发现(static / file / kubernetes)
为什么主流用 pull 而非推:目标列表集中可见、Prometheus 主动控制抓取频率、目标下线后指标自动停更(还能据此做 up 告警);缺点是 Prometheus 必须能网络直达所有目标,短生命周期任务(如批处理 Job)则用 Pushgateway 中转。pull/push 的取舍见FAQ。
一次抓取返回的是纯文本 exposition 格式:
# HELP http_requests_total ...
# TYPE http_requests_total counter
http_requests_total{code="200",route="/api/order"} 12837
二、指标的三大来源
1)机器/OS 指标:node_exporter
每台主机以 DaemonSet/系统服务方式部署,暴露 CPU、内存、磁盘、网络、文件系统等 node_* 指标,是容量与主机告警的基础。
# CPU 使用率(1 - 空闲)
1 - avg(rate(node_cpu_seconds_total{mode="idle"}[5m]))
# 内存可用比例
node_memory_MemAvailable_bytes / node_memory_MemTotal_bytes
# 根分区用量
1 - node_filesystem_avail_bytes{mountpoint="/"} / node_filesystem_size_bytes{mountpoint="/"}
这些指标怎么和 vmstat、free、iostat 的输出对应,是排障时在「看板语言」和「命令行语言」间切换的关键。
2)中间件 exporter:mysqld_exporter、redis_exporter、postgres_exporter、kafka_exporter、blackbox-exporter 等,把各自系统的状态表/命令输出翻译成指标。Redis 指标对应延迟与大键诊断见 redis-cli。
3)应用自身埋点 /metrics:用 micrometer(JVM)、prom-client(Node)、client_golang 等库暴露 RED 指标,这是 SLO 的主数据,见 gRPC 拦截器埋点。
三、scrape_config:目标从哪来
scrape_configs:
  - job_name: node
    scrape_interval: 15s
    static_configs:                    # 写死目标(小规模)
      - targets: ['10.0.0.1:9100', '10.0.0.2:9100']

  - job_name: app
    file_sd_configs:                  # 文件服务发现(中规模,常由 CMDB 生成)
      - files: ['/etc/prometheus/tg/apps.json']

  - job_name: kubernetes-pods        # Kubernetes 自动发现 Pod
    kubernetes_sd_configs:
      - role: pod
    relabel_configs:
      # 只抓带 prometheus.io/scrape=true 注解的 Pod
      - source_labels: [__meta_kubernetes_pod_annotation_prometheus_io_scrape]
        action: keep
regex: "true"static_configs:简单直接,目标变动要改配置 reload。file_sd_configs:目标写在 JSON 里,外部系统更新文件即可,Prometheus 自动热加载。kubernetes_sd:直接从 API Server 发现 node/service/pod/ingress,配合 relabel 决定抓哪些、怎么重写标签。
relabel_configs(抓取前改写目标/标签)和 metric_relabel_configs(抓到后丢弃高基数指标)是控制基数和成本的关键闸口。
四、黑盒探测:blackbox-exporter
前面都是「白盒」——应用内部自报指标。但服务活着不等于用户能访问。blackbox-exporter 从外部对目标做 HTTP/HTTPS、TCP、ICMP、DNS 探测,产出 probe_success、probe_duration_seconds、SSL 证书有效期等,是可用性 SLO 和「我自己都不知道挂了」的最后兜底。配置思路见黑盒探测 FAQ。
  - job_name: blackbox
    metrics_path: /probe
    params: { module: [http_2xx] }
    static_configs:
      - targets: ['https://example.com/health']
    relabel_configs:
      - source_labels: [__address__]
        target_label: __param_target
      - target_label: __address__
        replacement: blackbox-exporter:9115
五、ServiceMonitor:K8s 里声明式管理抓取
裸 Prometheus 用一堆 scrape_config,在 Kubernetes 大规模下难维护。Prometheus Operator 引入 ServiceMonitor(CRD),让应用团队用一份 YAML 声明「怎么抓我的服务」,Operator 负责汇总生成抓取配置:
apiVersion: monitoring.coreos.com/v1
kind: ServiceMonitor
metadata:
  name: order-api
  labels: { release: kube-prometheus-stack }   # 必须被 Prometheus 的 selector 选中
spec:
  selector:
    matchLabels: { app: order-api }            # 选中带该 label 的 Service
  endpoints:
    - port: web
      interval: 15s
      path: /metrics
最常见故障是 ServiceMonitor 的 labels 没被 Prometheus 的 serviceMonitorSelector 选中,或 selector 找不到对应 Service——表现是配了但 targets 里压根没有。排查顺序:Service/Endpoints 是否 ready → label 是否匹配 → ServiceMonitor 自身 label 是否被 Operator 选中。
坑
- 目标不可达仍硬上 pull:跨网络/防火墙不通,target 全 down;要确保 Prometheus 到目标的网络与放通。
- 短命任务直接 pull:还没等到抓取 Pod 已消失,指标丢失,用 Pushgateway 或日志。
- 高基数不拦:不在 metric_relabel 丢弃 user_id 类标签,序列爆炸拖垮 Prometheus。
- 只做白盒不做黑盒:应用自报健康但入口挂了也发现不了,blackbox 从外部视角兜底。
- ServiceMonitor 不生效:labels 未被 selector 选中或没匹配到 Service,targets 里缺失,按 selector 链路逐级排查。
总结
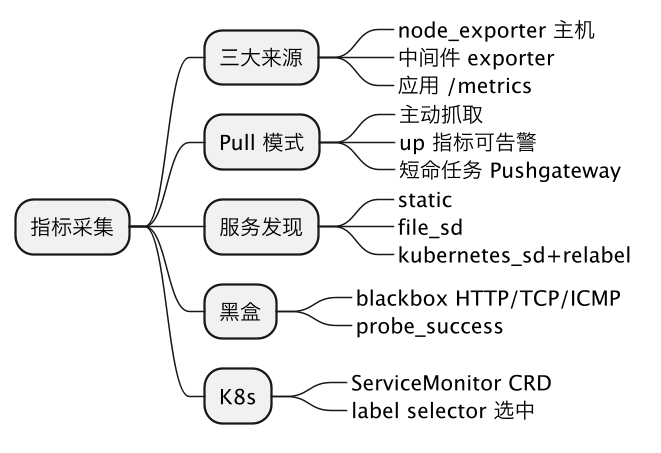
Prometheus 以 pull 模式周期性抓取目标暴露的 /metrics 文本,主机用 node_exporter、中间件用各自 exporter、应用用客户端库自报 RED 指标,外部可用性再由 blackbox-exporter 做 HTTP/TCP/ICMP 黑盒探测;目标清单通过 static、file_sd 或 kubernetes_sd 配合 relabel 自动发现并控制基数,在 Kubernetes 中则用声明式 ServiceMonitor 描述抓取方式并靠 label selector 被 Operator 纳管;接入时最常见的问题是网络不通、短任务漏采、标签高基数以及 ServiceMonitor 未被选中。