混沌工程原则:稳态假设、爆炸半径与渐进式实验
更新时间:2026-09-19。冗余、熔断、降级这些防护写得再好,没在真实故障下验证过就只是假设。混沌工程(Chaos Engineering)由 Netflix 系统化,核心是主动给生产系统注入故障,去检验系统的实际韧性,并暴露隐藏弱点。工具怎么用见 Chaos Mesh/Litmus 实战,事后如何复盘见无指责复盘。
一、混沌实验和普通测试的区别
| 维度 | 单元/集成/压测 | 混沌工程 |
|---|---|---|
| 问题 | 功能对不对、能扛多少 QPS | 系统在意外故障下表现如何 |
| 输入 | 已知用例、正常/边界流量 | 随机杀实例、断网、延迟、丢包、满盘 |
| 目标 | 验证代码逻辑/容量 | 验证韧性假设(能否自愈、告警响不响) |
| 环境 | 测试环境为主 | 最终要在生产、真实流量下做 |
一句话:测试回答「我写的对不对」,混沌回答「我以为系统能扛住,它真的能吗」。很多故障不是单个组件坏,而是组件之间的交互和假设错了(超时没配、重试风暴、级联雪崩),这类只有在注入故障时才暴露。概念辨析见FAQ。
二、第一原则:先定义「稳态」
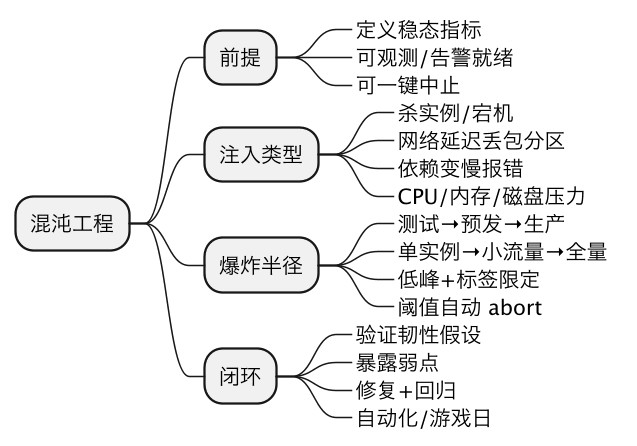
不能为了搞破坏而搞破坏。实验前必须有一个可测量的稳态(steady state),通常用业务/系统指标描述,例如:
- 成功率 ≥ 99.9%、P99 < 300ms(对应你的 SLO);
- 下单量保持稳定、支付成功率不下降;
- 消费者 lag 不持续增长。
实验假设写成:「当我们注入 X 故障时,稳态指标仍保持在 Y 范围内(因为有故障转移/熔断/降级兜底)」。实验结束对照实际结果:
- 假设成立 → 韧性得到验证,增强信心;
- 假设被打破(成功率掉了、没告警、没自动恢复)→ 这就是一次低成本发现的弱点,修复它,而不是等它在凌晨三点自然爆发。
三、常见故障注入类型
| 类别 | 注入手段 | 验证的假设 |
|---|---|---|
| 主机/实例 | kill 进程/容器/Pod、宕机、驱逐 | 故障转移、重新调度、N+1 冗余够不够 |
| 网络 | 延迟、丢包、抖动、分区、DNS 失败、带宽限制 | 超时/重试/熔断配置、脑裂防护、跨 AZ 通信 |
| 依赖 | 让下游返回错误、变慢、超时 | 熔断与降级是否真的生效 |
| 资源压力 | CPU 打满、内存泄漏、磁盘写满、IO 压力、文件描述符耗尽 | 容量水位、限流、资源隔离、监控告警 |
bash
经典实验:在工作时间随机杀掉生产环境一个无状态实例
预期:LB 健康检查摘除 → 流量分到其余实例 → 成功率几乎不变 → 告警触发 → Pod 被重新拉起
若成功率明显下降:说明冗余不足或摘除太慢(健康检查阈值/预热问题)
四、爆炸半径(blast radius):安全的核心
爆炸半径 = 一次实验可能影响的用户/流量/实例范围。混沌上生产的安全前提是把半径控制到「即使最坏情况,也只伤一小部分、且能立刻中止」:
- 从最小半径开始:先在测试环境 → 预发 → 生产单个实例 → 小比例流量/一个 AZ,逐级放大,绝不一上来全量。
- 选低峰、限定范围:用标签只选中「演练专用」或一小批实例;核心支付链路初期用影子流量或灰度环境。
- 明确中止条件(abort/rollback):设定稳态阈值(如成功率跌破 99.5%)自动停止实验并回滚,人工也能一键叫停。
- 可观测先行:没有监控、告警、看板就不要做混沌——你无法判断稳态是否被破坏,等于盲飞。
- 提前周知 + 权限控制:生产演练要有审批、时间窗、责任人,避免与真实事故混淆(演练常打
chaos=true标签区分)。
五、从手动实验到自动化与游戏日
- 成熟度阶梯:手动在测试环境做 → 脚本化、纳入 CI(韧性测试)→ 生产半自动、有审批 → 常态化自动随机注入(类似 Netflix 的全自动化思路,但绝大多数团队不必走到这一步)。
- Game Day(游戏日/故障演练日):给团队一个预设的故障场景,让 on-call、开发、运维按真实流程一起响应,既练技术(自动转移、回滚),也练协作和预案(谁决策、怎么沟通、runbook 好不好用)。这同时验证了告警链路和容灾 RTO/RPO。
- 频率:关键链路每季度至少演练一次常见场景;大促/上线前做针对性演练(如单 AZ 故障、缓存全失效、核心依赖超时)。
坑
- 没有稳态指标就注入:无法判断影响,混沌变成单纯搞破坏。
- 一上来大范围/生产核心链路:爆炸半径失控,演练直接变成真实事故。
- 没有中止与回滚机制:注入后无法快速撤销,损失扩大。
- 只在测试环境自我感动:测试环境负载和依赖都不真实,许多生产韧性问题验不出来。
- 实验失败被当成追责:发现弱点应奖励而非追责,否则团队会把实验做「浅」、回避真问题(与无指责文化一致)。
总结
混沌工程是通过主动注入杀实例、网络分区延迟、依赖报错变慢、资源打满等故障,来检验系统在意外下能否自愈的有纪律实验,它区别于功能测试之处在于验证韧性假设而非代码正确性;开展前必须用 SLO 类指标定义稳态、保证可观测并设置自动中止条件,再按从测试到生产、单实例到小流量的顺序严格控制爆炸半径,把每一次假设被推翻都当作低成本发现的弱点去修复,最终通过脚本化和 Game Day 常态化,同时验证技术兜底、告警响应与团队协作,且全程对事不对人。