无指责复盘 blameless:时间线、5Whys 与改进闭环
更新时间:2026-09-19。故障处理完只是结束了一半,另一半是复盘:从这次事故里学到什么、怎么让同类问题不再发生。SRE 用「无指责复盘(blameless postmortem)」作为核心学习机制。复盘该在什么时候触发、和错误预算的关系、演练中的问题如何纳入,本篇一并讲清。
一、为什么必须 blameless
人在可能被惩罚时,会本能地隐瞒、甩锅、避谈细节。如果复盘结论是「小王误操作导致」,那么:
- 下次别人犯同样的错会尽量藏住,事故在暗处变大;
- 大家学到的是「别被抓到」,而不是「系统为什么允许这个错误造成事故」;
- 关键细节(当时看到什么、为什么那样判断)再也问不出来。
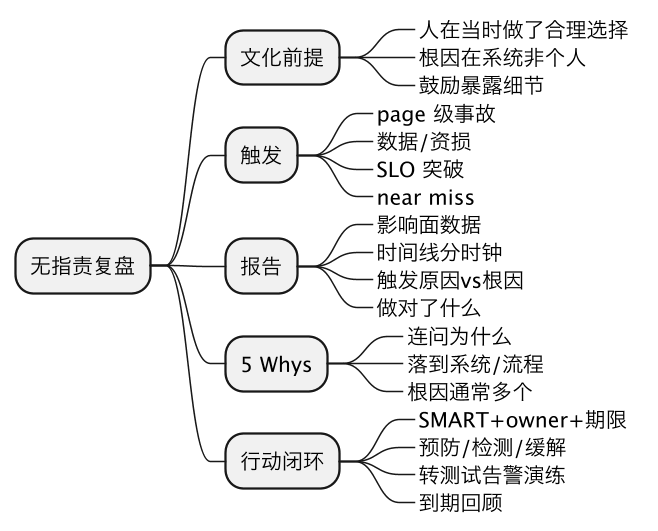
blameless 的核心前提是一句著名假设:「假设在当时掌握的信息、所处的环境和压力下,每个人都做出了合理的选择。」 事故的根因几乎从来不是「某人笨/粗心」,而是系统让一个正常的人为失误变成了用户可见的故障——没有灰度、没有回滚开关、没有告警、危险操作没有二次确认。
追责关注「谁错了」,blameless 关注「为什么这个错误能一路变成事故」。这和混沌工程「发现弱点是好事」的文化一致。
二、什么情况要写复盘
不是所有抖动都要写,常见触发条件(可按团队调整):
- 用户可感知的宕机/功能不可用、触发了 page 级 on-call;
- 数据丢失/损坏、资损、安全事件;
- SLO 被显著突破、错误预算被一次大量消耗;
- 差点出事(near miss,被一道防线侥幸挡住)——尤其值得复盘,因为零成本拿到教训。
复盘应在事件收尾后尽快(记忆新鲜,通常 1~3 个工作日内)开第一次会,报告可以后补;拖久了时间线和动机都模糊。
三、复盘报告结构
一份好的 postmortem 通常包含:
1. 摘要:一句话说清什么时间、什么影响、持续多久、严重等级
2. 影响面:受影响用户/业务量、SLO 损耗、资损(用数据,如错误率、订单下降%)
3. 时间线 timeline:
     故障发生 → 监控告警 → 人介入(ack) → 定位 → 缓解 → 恢复
   每个关键动作带时间戳和操作人/系统
4. 根因分析:触发原因(proximate cause) + 根本原因(root cause)
5. 做对了什么(别只写问题,正向强化有效动作)
6. 哪里响应可以更快(检测、定位、缓解、沟通各环节 MTTR 拆解)
7. 行动项 action items:具体、可验收、有 owner、有期限
8. 附录:相关图表、日志、trace、看板链接时间线要分清三个时钟:问题实际开始(T0)、告警触发(检测延迟)、人开始处理(响应延迟)、服务恢复(缓解耗时)。这直接对应 MTTR 的拆分,能指出「是发现得慢还是修得慢」。
四、5 Whys:从触发原因挖到根因
连续追问「为什么」,直到落到系统/流程层面可修复的原因,而不是停在「人犯错了」。示例:
现象:下单服务 20 分钟 500 错误升高
为什么错?     → 数据库连接池耗尽
为什么耗尽?   → 一条慢 SQL 占住连接很久
为什么有慢 SQL?→ 新上线的查询没走索引
为什么没发现? → 该改动没做执行计划评审,预发数据量小没暴露
为什么没评审也能上线?→ 发布流程没有 DB 变更卡点,全靠个人经验

行动项方向(系统层,而非「让大家小心」):
  - 发布流水线增加 SQL EXPLAIN/慢查询静态检查(卡点)
  - 关键查询加慢查询告警与连接池饱和度告警
- 大表变更强制评审 checklist注意根因往往是多个(技术 + 流程 + 监控),别强求唯一答案;也要区分:触发原因(那条 SQL)是导火索,根因(缺卡点、缺告警、缺容量保护)才是复发的土壤。只处理触发原因(回滚 SQL),下次换条 SQL 还会炸。
五、行动项必须闭环,否则复盘白做
复盘最常见的失败是「写了一堆改进,然后没人做」。行动项要工程化管理:
- SMART:具体、可衡量、有明确 owner 和截止时间;「优化系统」不是有效项,「10/01 前在 CI 接入 SQL 计划检查,owner=张三」才是。
- 分级:防止同类事故复发的项最高优先(进近期迭代),锦上添花的降级为 ticket。
- 可验收:每个项最好能转化为一个测试/告警/演练——例如加了告警,就用混沌实验验证它真的会响。
- 跟踪闭环:在下一次复盘/例会上回顾上次 action items 完成率;未完成的要解释,不能静默消失。
- 控制数量:聚焦 3~5 个高价值项,十几条行动项等于没有重点。
改进项可以来自三类:预防(让故障难发生,如灰度、卡点)、检测(让故障更快被发现,如告警、黑盒探测)、缓解(发生后影响更小/恢复更快,如降级开关、自动回滚、容灾)。三类都要覆盖,别只盯着预防。
六、复盘与错误预算、组织机制
- 复盘不是处罚工具,结论不进绩效(否则 blameless 立刻失效);它和错误预算配套:烧预算是系统信号不是个人过错。
- 报告默认团队内公开(脱敏后可更大范围共享),让没值班的人也学到;维护一个复盘库,新人和跨团队都能检索历史教训。
- 定期(月度/季度)跨事故归纳:若多个复盘都指向同一类问题(如反复的连接池、发布回滚慢),说明需要专项治理而非逐个打补丁。
- 沟通也是复盘对象:事故中对用户/内部的通告是否及时、口径是否一致,常和技术问题同等重要。
坑
- 复盘变追责:结论停在「某人误操作」,团队随后隐瞒问题,根因永不修复。
- 只回滚不挖根因:处理了触发原因就收工,换个形式必然复发。
- 行动项空泛无 owner:「加强监控、注意规范」无法验收、无人负责,下次照旧。
- 时间线只记技术不记决策:忽略「当时为什么那样判断」,错失流程与人因层面的改进。
- 复盘报告写完即归档:不跟踪完成率、不验证效果,复盘沦为形式。
- 只写做错的:不总结有效的检测/缓解动作,团队无法强化正确实践。
总结
无指责复盘基于「每个人在当时的信息和压力下都做了合理选择」的前提,把目光从「谁的错」转向「系统为什么让一个正常失误演变成用户故障」;报告用数据写清影响面、按检测/响应/缓解拆分带时间戳的时间线,并用 5 Whys 把触发原因一直追问到可修复的系统与流程根因(通常不止一个);最重要的是产出少量 SMART、带 owner 和期限、覆盖预防检测缓解三类且能转成告警/测试/演练来验收的行动项并到期跟踪,结论不与绩效挂钩、报告公开沉淀、定期跨事故归纳,才能让每一次故障真正变成组织能力的增量。