混沌工具实战:Chaos Mesh / Litmus 注入故障
更新时间:2026-09-19。前置:混沌工程原则与爆炸半径。原则清楚后,这篇落到工具:在 Kubernetes 环境,Chaos Mesh(CNCF,PingCAP 出品)和 LitmusChaos(CNCF,Harness 主导)是两个主流开源选择,都用 CRD 声明式注入故障。
一、主流工具怎么选
| 工具 | 形态 | 强项 | 适用 |
|---|---|---|---|
| Chaos Mesh | K8s CRD + Web UI | 故障类型全、CRD 直观、K8s 原生、支持 Workflow 编排 | K8s 环境首选,落地快 |
| LitmusChaos | CRD + ChaosCenter | 强调「实验即代码」、探针(probe)做稳态断言、实验市场(Hub) | 需要 CI/CD 集成、可复用实验 |
| Gremlin | 商业 SaaS | 成熟、有「安全护栏」、报告与权限完善 | 企业付费、需要支持 |
| Chaos Monkey | Netflix 早期工具 | 随机杀实例的鼻祖 | 思想源头,现多被 K8s 方案取代 |
| tc / stress-ng / iptables | 原生命令 | 无需额外系统、非容器环境可用 | 裸机/VM、脚本化演练 |
两者能力高度重叠:Chaos Mesh 的 CRD 更直白、上手快;Litmus 的探针和实验编排更体系化。下面以 Chaos Mesh 为主给可直接套用的样例,思想在 Litmus 里一一对应(Pod Delete、Network Delay、CPU Hog 等)。
二、PodChaos:杀容器/Pod(验证故障转移)
apiVersion: chaos-mesh.org/v1alpha1
kind: PodChaos
metadata:
  name: kill-one-order-pod
  namespace: chaos-testing
spec:
  action: pod-kill
  mode: one                 # 只杀选中范围里的一个(控制爆炸半径)
  selector:
    namespaces: [prod]
    labelSelectors:
      app: order-api
  duration: "30s"
mode 控制影响比例:one(一个)、fixed+value、percentage(百分比)、all(全部,危险)。这是控制爆炸半径的关键字段——初次演练务必用 one,且用 labelSelectors 精确限定。预期现象:健康检查摘除、Service 把流量分到其余 Pod、Deployment 重新拉起、成功率抖动很小;若成功率大跌说明冗余/摘除有问题。
三、NetworkChaos:延迟、丢包、分区、带宽
apiVersion: chaos-mesh.org/v1alpha1
kind: NetworkChaos
metadata: { name: delay-to-pay, namespace: chaos-testing }
spec:
  action: delay              # 注入 200ms±50ms 延迟
  mode: all
  selector:
    namespaces: [prod]
    labelSelectors: { app: order-api }
  delay: { latency: "200ms", jitter: "50ms" }
  direction: to
  target:                    # 只影响调用支付服务的流量
    selector:
      namespaces: [prod]
      labelSelectors: { app: pay-api }
    mode: all
  duration: "2m"
把 action: delay 换成 loss(丢包,loss: { loss: "20%" })、duplicate、corrupt、partition(完全隔离)即可模拟弱网、网络分区。这个实验直接检验:
底层就是 tc netem,Chaos Mesh 帮你在 Pod 的 network namespace 里自动配置,无需登录节点。
四、StressChaos:CPU / 内存压力
apiVersion: chaos-mesh.org/v1alpha1
kind: StressChaos
metadata: { name: cpu-hog-order, namespace: chaos-testing }
spec:
  mode: one
  selector:
    namespaces: [prod]
    labelSelectors: { app: order-api }
  stressors:
    cpu: { workers: 2, load: 80 }        # 2 个 worker 打 80% 负载
    # memory: { workers: 1, size: "512MB" }  # 内存压力(可触发 OOM/GC)
  duration: "3m"
验证 CPU 饱和时的调度延迟、run queue、限流是否触发、GIL/JVM GC 是否恶化、监控的饱和度告警响不响(对应 USE 方法的 Saturation)。内存压力可验证容器 limit 下 OOMKill 行为和容器内存限制。
五、其它常用实验
- DNSChaos:注入 DNS 解析错误/延迟(
action: error/random),验证服务发现失败、缓存兜底。 - IOChaos:给容器内某路径的读写加延迟/错误(
action: latency/io-error,volumePath指向挂载点),验证慢盘、只读文件系统场景,配合 iostat、fio 观察。 - TimeChaos:偏移容器时间,测试时钟回拨、时间敏感逻辑(如Snowflake 时钟回拨)。
- HTTPChaos:在应用层直接篡改请求/响应(改状态码、body、延迟),不依赖下游真实故障,最适合演练降级兜底。
六、编排、稳态断言与自动回滚
单次注入只是「点射」,进阶用 Workflow(Chaos Mesh)或 Litmus Probe 编排成完整实验:
1. 实验前:记录稳态基线(成功率/P99/订单量)
2. 并行/串行注入若干故障(Chaos Workflow 支持串行、并行、条件分支)
3. 稳态探针:实验期间持续查询 Prometheus,成功率 < 阈值 即判失败并中止
4. duration 到期 → CRD 删除 → 故障自动恢复(Chaos Mesh 的注入是可逆的)
5. 输出结果 → 失败项转成改进 ticket,进入复盘
Litmus 的 probe(cmd/http/prometheus/k8s)专门干第 3 步;Chaos Mesh Workflow 可内嵌检查任务。无论用哪个,都要落实原则篇的安全护栏:label 精确限定、mode: one 起步、低峰执行、一键删除 CRD 即回滚、实验打标签便于告警静默与区分。
非 K8s 环境:用 tc qdisc/netem(网络)、stress-ng(CPU/内存)、iptables -A DROP(分区)、kill -STOP(暂停进程)、systemctl 停服务等命令脚本化,配合混沌原则同样能演练。
坑
- mode: all 开局:把某服务 Pod 全杀/全网隔离,演练直接变事故;务必从 one/小百分比起步。
- selector 写太宽:漏写 namespace/label,误伤无关服务。
- 只注入不设稳态断言:不知道有没有真的影响用户,实验结果无法判断成败。
- 忘了 duration/不清理:故障长期残留;CRD 要能一键删除恢复,实验后确认网络规则已还原。
- 在高峰对核心链路做未演练过的实验:先在测试/预发和非核心服务跑顺,再按爆炸半径分级推进。
总结
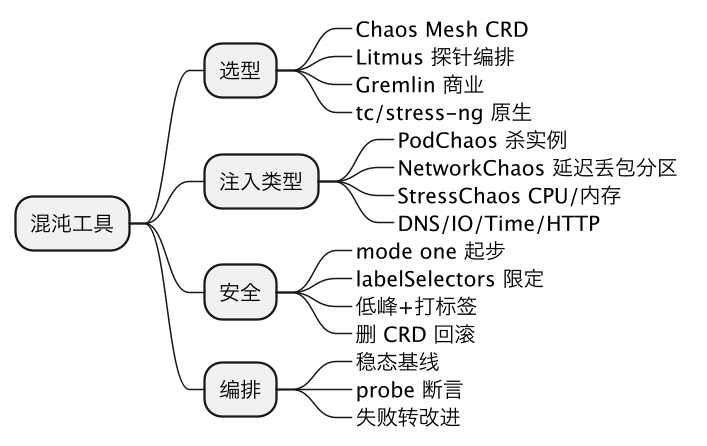
在 Kubernetes 上做混沌优先选 CRD 直观、故障类型齐全的 Chaos Mesh 或强调探针和实验即代码的 Litmus:用 PodChaos 杀实例验证故障转移、NetworkChaos 注入延迟丢包分区检验超时熔断与脑裂、StressChaos 打 CPU/内存观察饱和度与 OOM,另有 DNS、IO、时间和 HTTP 层故障;所有实验都靠 selector 与 mode 精确控制爆炸半径、从小范围起步,用 Workflow/Probe 在实验期间持续校验稳态阈值,到期或删除 CRD 即自动回滚,失败项转入无指责复盘,非容器环境则用 tc、stress-ng、iptables 等原生命令达到同样目的。