服务熔断、降级与隔离(雪崩防护)
更新时间:2026-09-18。微服务可靠性主题。单个依赖变慢,为什么能拖垮整条调用链、乃至整个集群?本文把「雪崩」和它的四件套——超时重试、熔断、降级、隔离——一次讲清,并对比三个主流框架。
一、雪崩是怎么形成的:一个慢依赖 → 整条链
雪崩不是「服务挂了」,而是被慢调用一点点拖死的级联过程:
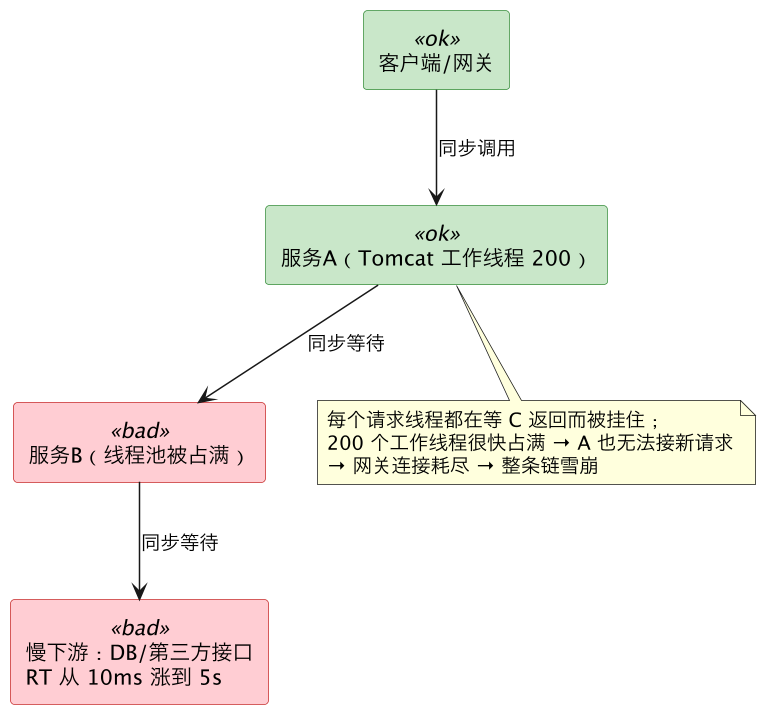
关键机制:同步调用下,上游的线程会被慢下游占住不释放。下游 RT 涨 500 倍,等价于上游有效容量掉到 1/500;线程/连接一旦耗尽,健康的接口也因为抢不到线程而一起不可用——这就是「级联故障(cascading failure)」。
二、四件套:先分清它们各管什么
很多人把这几个词混用,它们其实是四道独立的防线,要组合使用:
| 手段 | 解决什么 | 典型做法 | 不做会怎样 |
|---|---|---|---|
| 超时 timeout | 请求无期限等待 | 对每次远程调用设超时(连接/读分别设) | 线程被永久挂住,直接等死 |
| 重试 retry | 偶发抖动 | 限次数(1~2 次)+ 退避 + 仅幂等接口 | 偶发失败变失败;但无脑重试会放大流量 |
| 熔断 circuit breaker | 下游持续故障时还猛打 | 错误率/慢调用超阈值则「跳闸」,直接快速失败 | 持续打一个已死的下游,浪费线程、拖慢恢复 |
| 降级 fallback | 跳闸/失败后给个兜底结果 | 返回缓存/默认值/精简数据/友好提示 | 用户直接看到 500,体验崩塌 |
| 隔离 isolation | 一个依赖占光全部资源 | 线程池/信号量按依赖分舱(bulkhead) | 一个慢接口拖垮整个进程所有接口 |
2.1 熔断器的三态状态机
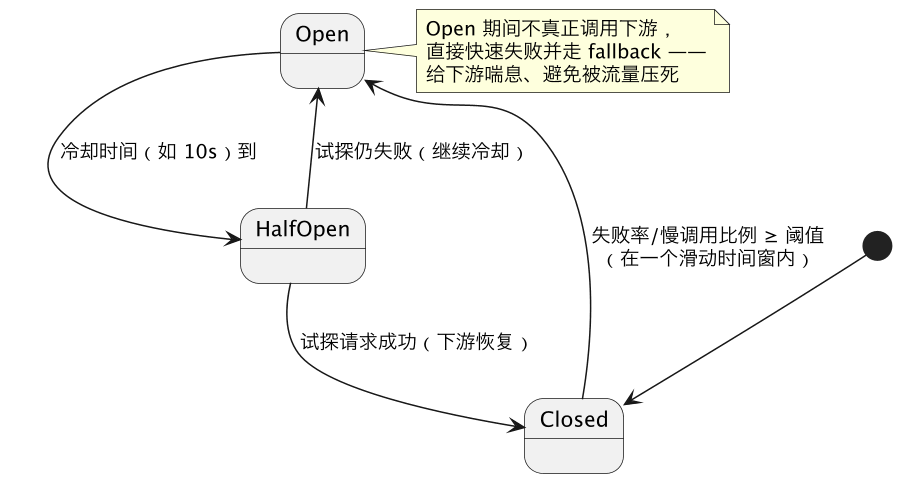
- Closed(闭合):正常放行,同时统计近一个时间窗的失败率/慢调用比例。
- Open(断开):阈值触发后跳闸,窗口期内直接失败、不发请求,让下游和自身线程池都喘口气。
- HalfOpen(半开):冷却结束后放少量探测请求,成功则闭合恢复,失败则重新断开。半开机制避免了「下游刚恢复就被全量流量再次压垮」。
2.2 隔离:线程池舱壁 vs 信号量
「舱壁(bulkhead)」借喻船舱隔板:把对不同依赖的调用放进不同资源池,一个进水不沉全船。
| 隔离方式 | 原理 | 优点 | 缺点 | 适用 |
|---|---|---|---|---|
| 线程池隔离 | 每个依赖独立线程池 + 队列 | 异步、可超时、彻底隔离,慢调用占不满主池 | 线程切换开销、需排队/线程数 | 跨网络、可能慢的依赖(默认选它) |
| 信号量隔离 | 计数器限制并发数,调用在当前线程执行 | 轻量、无线程切换 | 不能主动超时、不适合慢调用 | 本地方法/极快的依赖、超高 QPS |
三、三个框架怎么选
| 维度 | Hystrix(已停更) | Resilience4j | Sentinel |
|---|---|---|---|
| 状态 | Netflix 已停止维护 | 活跃,函数式、轻量 | 阿里活跃维护 |
| 依赖 | 重(Archaius/RxJava) | 仅需 Vavr 等少量库,模块化 | 核心库轻,控制台/dashboard 完善 |
| 熔断 | 有(线程池隔离强) | CircuitBreaker 基于计数/时间窗 | 慢调用比例/异常比例/异常数多规则 |
| 限流 | 弱 | RateLimiter | 强项:QPS/线程数/关联/热点参数限流 |
| 隔离 | 线程池/信号量 | Bulkkhead(信号量/线程池) | 主要信号量(并发线程数) |
| 规则动态化 | 配置文件 | 配置/代码 | 控制台热推送、开箱即用 |
| 选型 | 老系统存量 | Spring Cloud 新系统、要轻量 | 需要成熟流控+控制台、国内生态 |
Resilience4j 最小示例(熔断 + 降级 + 舱壁):
java
CircuitBreakerConfig cbConfig = CircuitBreakerConfig.custom()
    .failureRateThreshold(50)                 // 失败率 ≥50% 跳闸
    .slowCallRateThreshold(50)                // 或慢调用比例 ≥50%
    .slowCallDurationThreshold(Duration.ofSeconds(2))
    .waitDurationInOpenState(Duration.ofSeconds(10)) // 冷却 10s 后半开
    .slidingWindowType(SlidingWindowType.COUNT_BASED)
    .slidingWindowSize(20)                    // 近 20 次调用统计
    .minimumNumberOfCalls(10)                 // 至少 10 次才计算
    .permittedNumberOfCallsInHalfOpenState(5) // 半开放 5 个探测
    .build();
CircuitBreaker cb = CircuitBreaker.of("orderSvc", cbConfig);

Supplier<Order> supplier = CircuitBreaker
    .decorateSupplier(cb, this::queryOrderFromRemote);
// 跳闸或异常时走降级:返回缓存/默认值
Order order = Try.ofSupplier(supplier)
    .recover(throwable -> orderFromCacheOrDefault()).get();
四、落地要点与坑
- 超时必须设,且要分层、上游比下游略长。 只在最外层设超时没用——中间每次远程调用都要设;上游超时应略大于下游超时 + 重试预算,避免上游先断、下游白做。
- 重试一定要配退避且只对幂等读接口。 对非幂等写接口重试会造成重复下单/重复扣款(幂等设计见 接口幂等设计);无退避的并发重试会在故障期形成「重试风暴」,流量放大数倍。
- fallback 本身不能再依赖慢资源。 降级逻辑里再去查一个可能挂的库/调另一个远程服务,等于没降级;兜底数据应来自本地缓存、静态默认值或预先准备的精简数据。
- 阈值别拍脑袋,按基线设。 错误率阈值要高于正常抖动(否则频繁误跳闸),但要在资源耗尽前触发;配合最小调用数(
minimumNumberOfCalls),避免低 QPS 下一次失败就跳闸。 - 半开放行数量要小。 下游刚恢复时容量有限,半开只放几个探测请求,确认稳定再全量,否则会「恢复—压垮—跳闸」反复震荡。
- 不要只熔断不隔离,也不要只隔离不超时。 熔断按「错误比例」触发,遇到「不报错但极慢」的下游可能迟迟不跳,这时慢调用比例阈值和线程池隔离是兜底;四者缺一不可。
- 降级要分级,保核心。 电商大促时可降级评价、推荐、广告等非核心链路,保下单、支付;降级开关要能动态下发,而不是重启生效。
雪崩的另一面是「容量与高并发设计」:从源头做容量评估、缓存、异步削峰,见 高并发系统设计:从容量评估到缓存异步;分布式下一致性取舍见 CAP 与 BASE 理论;事件循环/线程池被慢调用拖垮的单机视角见 async/await 与事件循环阻塞排查。
总结
服务雪崩的根因是同步等待下慢下游占满上游线程/连接,引发级联耗尽;防护靠四件套组合——超时(且上游略宽于下游)+ 幂等接口的有限退避重试止血、熔断器按失败率/慢调用比例在 closed/open/half-open 间切换给下游喘息、fallback 返回不依赖慢资源的兜底结果、线程池或信号量舱壁把不同依赖的故障隔离开;框架上新系统选轻量的 Resilience4j、要成熟流控控制台选 Sentinel、Hystrix 仅维护存量,阈值按基线设、半开小流量探测、降级分级保核心,才能既不误杀也不漏防。