高并发系统设计:从容量评估到缓存异步
更新时间:2026-09-18。「高并发」不是某一个技术点,而是一套「先算账、再分层承接」的方法论。本文给出从容量评估到缓存、异步、扩容、兜底的完整框架,并用秒杀场景串起来。
一、第一步永远是算账:容量评估
不谈数字就谈不上高并发设计。先把几个核心指标理清:
| 指标 | 含义 | 说明 |
|---|---|---|
| QPS | 每秒查询/请求数 | 读接口常用 |
| TPS | 每秒事务数 | 写/下单等事务接口 |
| RT | 单次请求响应时间 | 决定单线程吞吐 |
| 并发数 | 同时在处理的请求数 | 与 QPS、RT 满足 Little 定律 |
Little 定律:并发数 = QPS × 平均 RT。 例如一个接口 QPS=1000、平均 RT=50ms,则同时在处理的请求约 1000 × 0.05 = 50 个。RT 从 50ms 涨到 500ms,同样 QPS 下并发数涨到 500——这正是慢调用能拖垮系统的量化原因(与 服务雪崩防护 呼应)。
容量评估要回答:
- 峰值是多少? 用「日均 × 集中系数」估峰值,再留 2~3 倍 buffer(大促还要考虑脉冲)。
- 单机承载多少? 压测得到单机极限 QPS(
wrk/ghz),而不是拍脑袋。 - 需要几个节点?
节点数 = 峰值 QPS ÷ 单机安全 QPS,安全水位取极限的 60%~70%,留余量给故障机摘除。 - 瓶颈在哪一层? CPU、内存、连接数、DB、下游接口——逐层算,短板决定全局。
二、分层应对框架:从低成本到高成本
优化遵循「能单机不集群、能缓存不落库、能异步不同步」,按成本从低到高分层:
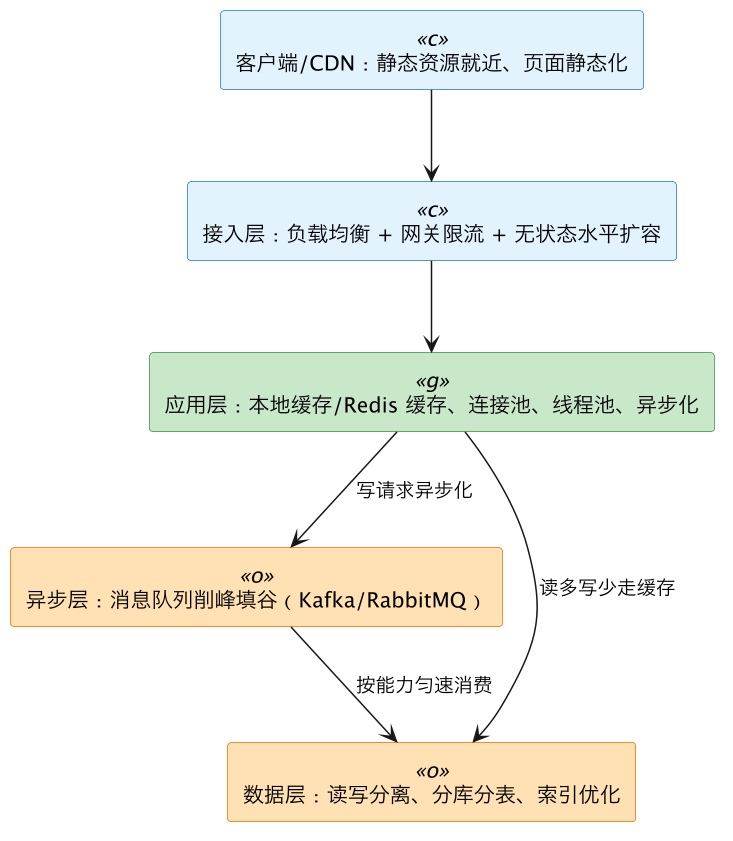
| 层次 | 手段 | 解决 | 代价/注意 |
|---|---|---|---|
| 纵向扩展 | 加 CPU/内存/SSD | 简单直接 | 有硬件上限、单点 |
| CDN/静态化 | 热点页/资源边缘缓存 | 把流量挡在源站前 | 适合读多、变更少 |
| 缓存 | 本地缓存 + Redis 分布式缓存 | 挡住绝大多数读,保护 DB | 一致性、穿透/击穿/雪崩 |
| 异步削峰 | 写请求进 MQ,后端匀速消费 | 把瞬时洪峰拉平 | 引入延迟、积压、幂等问题 |
| 横向扩展 | 应用无状态 + 多实例 + 负载均衡 | 线性提吞吐 | 有状态部分要外置(session→Redis) |
| 读写分离 | 主库写、从库读 | 分摊读压力 | 主从延迟、读到旧数据 |
| 分库分表 | 按分片键水平拆 | 突破单库容量/写瓶颈 | 跨片查询、事务、扩容复杂 |
| 池化 | 连接池/线程池/对象池 | 复用昂贵资源、控并发 | 参数不当反而成瓶颈 |
| 限流降级兜底 | 网关/应用限流、熔断降级 | 超过容量时保核心、不被打死 | 牺牲部分请求 |
三、缓存:性价比最高,但要防三个坑
读多写少场景,缓存是第一手段。多级缓存(本地 Caffeine + 分布式 Redis)命中率高时,DB 压力可降一两个数量级。但必须处理好:
- 缓存穿透:查不存在的数据,缓存永远没有、直达 DB。用缓存空值或布隆过滤器。
- 缓存击穿:某个热点 key 过期瞬间,大量并发同时打到 DB。用互斥锁重建或热点 key 逻辑不过期。
- 缓存雪崩:大量 key 同时过期或 Redis 宕机,请求全落 DB。用过期时间加随机抖动、Redis 高可用、多级缓存。
- 一致性:先更新 DB 再删缓存(Cache Aside),强一致要求结合延迟双删或 binlog 订阅。
三者区别与防护细节见 缓存穿透/击穿/雪崩,一致性见 缓存与数据库一致性。
四、异步削峰:把洪峰拉平
秒杀下单这类写洪峰,DB 根本扛不住瞬时几万 TPS。做法是请求先入队、后端按 DB 能承受的速率匀速消费:
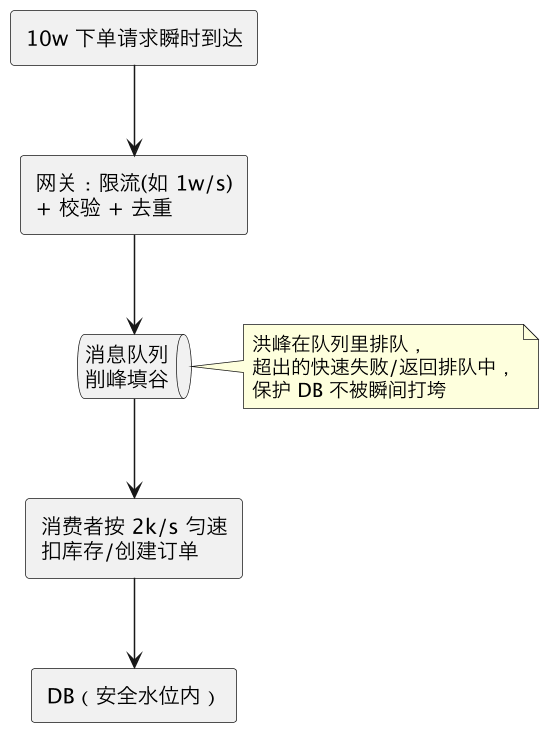
异步化的代价必须接住:用户侧要改成「排队中→轮询/推送结果」的最终一致体验;消费端必须幂等(重复消息见后文 FAQ);要监控消息积压并能临时扩消费者。
五、秒杀场景的分层落地顺序
把上面的手段按「流量从外到内」排一遍,就是一个完整的高并发方案:
- 前端/CDN:静态化商品页,按钮置灰防重复点。
- 网关限流:按 UID/IP 限流,提前挡掉超额流量(令牌桶/漏桶)。
- 缓存预热 + 库存预热:商品、库存放入 Redis,读全走缓存。
- 校验前置:登录、风控、活动时间、黑名单在入队前快速失败。
- 请求去重:同一用户同商品只允许一个有效请求(幂等设计)。
- 异步下单:合法请求入 MQ,立即返回「排队中」。
- 缓存扣库存:Redis Lua 原子预扣库存,避免超卖;DB 最终落库。
- 匀速消费:消费者按 DB 能力拉取,幂等创建订单。
- 兜底:熔断降级、限流排队、失败友好提示,保核心链路。
六、典型坑
- 只盯 QPS 不算并发数和 RT。 RT 恶化会让同样的 QPS 需要成倍资源,容量评估必须三者一起看(Little 定律)。
- 把缓存当银弹却不防三大问题。 一次热点 key 过期或 Redis 抖动就能让没做防护的 DB 瞬间被打穿。
- 同步调用链太长。 高并发下每多一次同步等待,线程占用就放大一级;能异步/并行的就异步。
- 有状态应用无法水平扩容。 session、本地缓存的「主」身份都要外置或做一致性路由,否则加机器不解决问题。
- 队列只进不管积压。 不监控 lag、不设计消费扩容与超时关单,削峰就变成「延迟堆积直至雪崩」;MQ 选型见 Kafka 与 RabbitMQ。
- 数据库最后才想分库分表。 先做好索引、缓存、读写分离,确是单库瓶颈再分片;过早分片徒增跨片事务与扩容成本。
- 没有兜底预案。 超过设计容量时,靠限流/熔断/降级「丢卒保车」,比整体被打死后完全不可用要好。
单机线程/事件循环被阻塞的微观机制见 async/await 与事件循环阻塞排查;数据层扩展见 分库分表:分片键/扩容/全局 ID;连接数容量见 连接池调优:HikariCP 参数与连接数公式。
总结
高并发设计先用 Little 定律(并发数=QPS×RT)算清峰值、单机极限、节点数和短板,再按「CDN 静态化 → 网关限流与无状态水平扩容 → 多级缓存挡读 → 消息队列把写洪峰削成匀速消费 → 读写分离/分库分表扩数据层 → 池化与限流降级兜底」的成本从低到高分层承接;缓存要防穿透/击穿/雪崩和一致性、异步要接住延迟体验与幂等积压、扩容要求应用无状态,秒杀场景就是这套顺序的组合,核心思想是让流量层层衰减、让 DB 始终运行在安全水位内。