Kafka 与 RabbitMQ 架构差异与选型
更新时间:2026-09-18。Kafka 和 RabbitMQ 都能「发消息、解耦、削峰」,但它们是两种哲学:Kafka 是可重复读的分布式提交日志(log),RabbitMQ 是投递后即删的智能消息代理(broker)。模型不同决定了吞吐、顺序、重试、回溯、运维方式的差异。本文做工程向深入对比;入门对照见 后端工程:消息中间件,可靠投递与幂等见 接口幂等设计。
本文要回答的问题
- Kafka 的「分区日志 + 消费者位点」和 RabbitMQ 的「交换机/队列 + ACK」本质差在哪?
- 为什么 Kafka 吞吐高、还能回放,RabbitMQ 延迟低、路由灵活?
- 两边分别怎么保证顺序、怎么做重试和死信?
- 消费积压(lag)在两种系统里怎么处理?
- 什么业务选哪个?RocketMQ/Pulsar 又处在什么位置?
一、两种数据模型
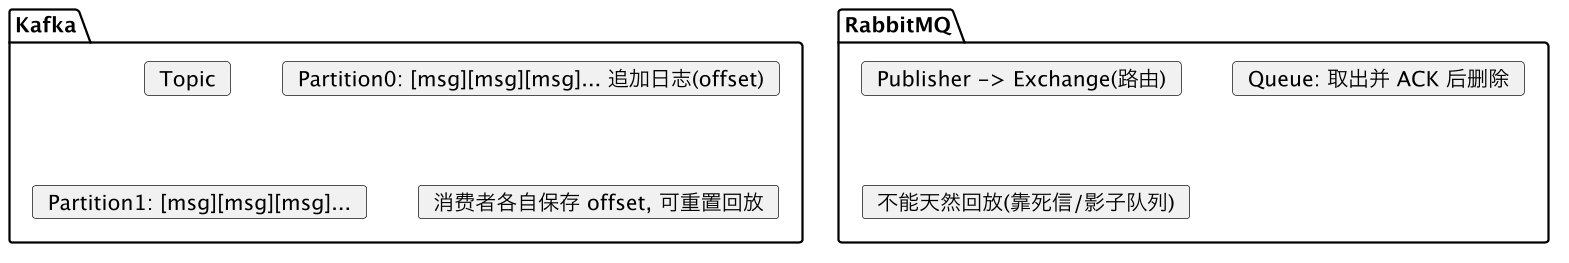
Kafka:消息按分区顺序追加到不可变日志,保留一段时间(按大小/时间),不因为被消费而删除。消费者组里每个分区只被组内一个消费者消费,消费进度 offset 由消费者提交(可存于 __consumer_offsets)。把 offset 拨回去就能重新消费历史消息——这是日志模型最大的特性。
RabbitMQ:生产者把消息发到 Exchange,Exchange 按路由键/规则投到一个或多个 Queue;消费者取走并 ACK 后消息即删除。它是「投递」语义,路由(direct/topic/fanout/headers)和投递保证(confirm、mandatory、TTL、优先级、延迟)非常丰富,但默认不保留历史,不能像 Kafka 那样随意回放。
二、关键维度对比
| 维度 | Kafka | RabbitMQ |
|---|---|---|
| 模型 | 分布式追加日志,消息保留 | 智能代理,ACK 后删除 |
| 量级 | 极高吞吐(顺序磁盘+零拷贝),延迟 ms 级 | 万级~十几万/秒,延迟低(内存优先,可达亚毫秒) |
| 顺序 | 分区内严格有序 | 单队列有序(多消费者需注意) |
| 消费方式 | 消费者拉取(poll) | 默认 broker 推送,可拉 |
| 多订阅 | 不同消费者组各自独立全量消费(天然发布订阅) | 需多队列/交换机绑定 |
| 回放/回溯 | 改 offset 即可重放 | 默认不行,需额外设计 |
| 路由 | topic+分区键,较简单 | 非常灵活的 Exchange/路由键 |
| 重试/死信 | 需自建重试 topic/应用层处理 | 原生 DLX、TTL、延迟队列成熟 |
| 事务/恰好一次 | 事务+幂等 producer+EOS | 发布确认+消费确认+业务幂等 |
| 运维心智 | 分区/ISR/重平衡/磁盘 | 队列堆积/内存水位/镜像/quorum |
三、顺序、重试与积压
顺序:Kafka 用业务主键作 partition key,同一 key 恒定落同一分区、由同一消费者顺序处理;扩分区会影响 key 分布但旧分区内顺序不变。RabbitMQ 单队列单消费者天然有序,要提高并发就得按 key 做一致性交换分到多个队列(多队列才能多消费者并行)。
重试与死信:
- RabbitMQ 原生:消费失败
nack(requeue=false)→ 进死信交换机(DLX)/死信队列;可用 TTL + DLX 做延迟重试队列。 - Kafka 没有内置死信队列:常见做法是失败消息发到独立的
retry-topic/DLQ-topic,或在应用里按次数退避重试,避免在原分区里原地阻塞(阻塞会卡住该分区后续消息)。
消费积压 lag:
- Kafka:
ConsumerLag= 分区最新 offset(LEO)− 消费者已提交 offset。处理:增加同组消费者实例直到等于分区数(再多无效,受分区数限制)、临时扩分区、让消费逻辑批量化/异步化;必要时先落盘快速消费、离线补算。 - RabbitMQ:队列 Ready 消息堆积:增加消费者、调大 prefetch(避免一条一确认的往返),但 unacked 太多会占内存;内存水位超限会触发流控/磁盘告警。
四、Exactly-once 与幂等
Kafka 通过「幂等 producer(pid+seq 去重)+ 事务(跨分区原子写)+ 消费者 read-process-write 提交 offset」实现 EOS,但端到端恰好一次仍依赖下游写入与 offset 提交在同一事务(Kafka Streams/事务性 sink)。RabbitMQ 提供 publisher confirm 与消费手动 ACK,保证不丢,但重复投递仍需业务幂等。无论哪个 MQ,消费端都应幂等(唯一键、去重表、状态机),见 接口幂等设计。
五、选型决策
选 Kafka:
  - 海量日志/埋点/指标、流处理、实时数仓、事件溯源、CDC 同步
  - 需要高吞吐、长时间保留、可回放、多套独立消费(不同消费组)
  - 能接受「路由简单、自己实现重试死信、关注分区与重平衡」

选 RabbitMQ:
  - 业务任务/订单/通知、工作队列、需要复杂路由与低延迟
  - 需要成熟的延迟队列、优先级、TTL、死信、灵活投递确认
  - 单消息语义复杂、量不是极端大、团队偏好开箱即用的代理

其他:RocketMQ 介于两者之间(事务消息、顺序消息、延迟消息强,电商/金融常用);
      Pulsar 计算存储分离、多租户与分层存储,适合超大规模多租户。
六、坑与对照
- 把 Kafka 当任务队列用原地重试。 阻塞分区会卡死后续消息,失败应旁路 retry/DLQ topic。
- 消费者数超过分区数。 多出的实例分不到分区空转,要先扩分区。
- RabbitMQ 无限堆积 + 无 TTL。 内存打满触发流控,要设上限、死信和监控。
- 以为开了 confirm/事务就不重复。 至少一次投递下重复难免,消费端务必幂等。
- 用分区有序却忘了 key。 不指定 key 会轮询到不同分区,顺序无从谈起。
- 忽略消费者重平衡。 Kafka 成员变动触发 rebalance 期间短暂停消费,长任务要配合合理 session/max-poll 间隔与 CooperativeSticky。
CDC 变更流入 Kafka 的典型链路见 CDC 数据同步;下游故障防护见 服务熔断、降级与隔离;缓存削峰见 缓存穿透/击穿/雪崩。
总结
Kafka 与 RabbitMQ 选型:Kafka 是按分区追加、长期保留、消费者自管 offset 的分布式日志,顺序磁盘+零拷贝带来极高吞吐且能改 offset 回放、不同消费组天然独立订阅,适合日志埋点、流处理、数仓、CDC 和事件溯源,但重试死信要自建、并发度受分区数限制、要管 ISR 与重平衡;RabbitMQ 是 Exchange 路由+队列、ACK 即删的智能代理,延迟低、路由与延迟/优先级/死信投递开箱即用,适合订单任务通知等复杂业务队列但默认不能回放、堆积受内存限制;两者都只能保证不丢、重复需消费端幂等,电商顺序/事务消息可看 RocketMQ,超大规模多租户看 Pulsar。