CDC 数据同步:MySQL Binlog 监听与 Canal/Debezium
更新时间:2026-09-18。CDC(Change Data Capture,变更数据捕获)指订阅数据库的变更日志,把行级增删改实时投递给下游——同步缓存、ES、数仓、异构库都靠它。它最大的价值是与业务代码解耦:下单逻辑不用关心「还要删几个缓存、写几个 ES」。本文从 MySQL 主从复制原理讲到 Canal/Debezium 落地与坑。背景:redo/undo/binlog、缓存一致性。
本文要回答的问题
- CDC 为什么能拿到变更?binlog 在主从复制里起什么作用?
- 为什么 CDC 强烈要求 binlog 用 ROW 格式?STATEMENT 差在哪?
- Canal「伪装成从库」具体怎么做的?和 Debezium/Kafka Connect 架构有何不同?
- 同步链路怎么保证不丢、不重?消费端为什么必须幂等?
- DDL 变更、位点管理、消息积压怎么处理?它能替代分布式事务吗?
一、原理:搭在 MySQL 主从复制的便车上
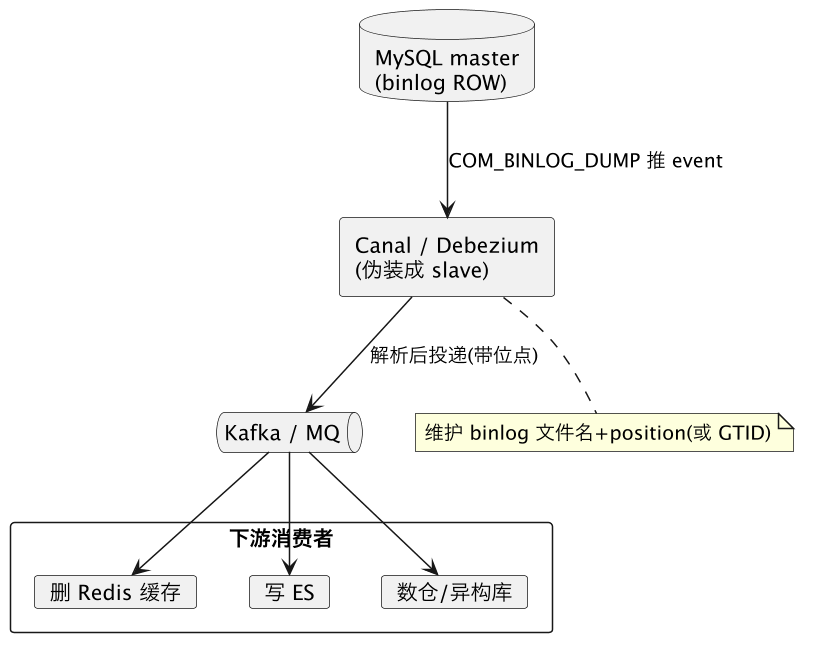
MySQL 主库把所有提交的变更顺序写入 binlog;从库的 IO 线程伪装成客户端连上主库,发起 COM_BINLOG_DUMP,主库就像对待从库一样把 binlog event 推过来。Canal/Debezium 做的事完全一样——把自己注册成一个「从库」,拿到 binlog 流并解析成行变更。
| binlog 格式 | 记录内容 | CDC 适配 |
|---|---|---|
| STATEMENT | 原始 SQL | 函数/时间/自增在从库结果可能不一致,难还原行 |
| ROW | 每行变更前/后的真实值 | CDC 必需,能拿到准确 before/after |
| MIXED | 按语句选择 | 行为不确定,不建议 |
ROW 格式下,一条 UPDATE 能同时拿到变更前镜像(before)和变更后镜像(after),这是缓存失效、审计、增量同步的关键。开启:binlog_format=ROW、binlog_row_image=FULL,并给 Canal/Debezium 一个具备 REPLICATION SLAVE/CLIENT 权限的账号。
二、Canal 与 Debezium 架构差异
Canal(阿里):JVM 进程,内含 parser(拉 binlog)、sink、store(环形缓冲)。canal-server 解析后可直接被客户端拉取,或通过 canal-adapter/connector 投递到 MQ、ES、RDB。部署轻、与 MySQL/国内生态贴合,常配 canal.admin 管理。
Debezium(Red Hat):运行在 Kafka Connect 上的一组 Source Connector,binlog 解析后写入 Kafka topic(一个表一个 topic),位点、扩缩容、容错交给 Kafka Connect 生态;天然云原生、支持 MySQL/PG/Mongo/SQL Server 等多源,下游用 Kafka 生态消费。
| 维度 | Canal | Debezium |
|---|---|---|
| 运行形态 | 独立 server/adapter | Kafka Connect 插件 |
| 输出 | 客户端直拉 / MQ / adapter | Kafka topic |
| 多数据源 | 以 MySQL 为主 | MySQL/PG/Mongo 等 |
| 位点存储 | ZooKeeper/meta/文件 | Kafka(offset)/Connect |
| 适合 | 轻量、直连、国内栈 | 已有 Kafka/K8s、多源、云原生 |
三、典型链路:下单后同步缓存与 ES
业务写 MySQL(提交)
  -> binlog(ROW)
  -> Canal/Debezium 解析出 after 行
  -> Kafka: order 变更事件(主键 + 操作类型 + 版本/binlog位点)
  -> 消费者 A: DEL order:{id} 缓存(下次读回源重建,见缓存一致性)
-> 消费者 B: upsert 到 ES 索引- 投递语义通常是 at-least-once:重启/重连可能重放一段 binlog,所以消费端必须幂等——用主键 upsert、删缓存用 DEL(重复删无害)、带版本号防止旧事件覆盖新值。
- 顺序:同一行的变更要保证按 binlog 顺序处理。Kafka 用主键做分区键,同一主键恒定进同一分区单线程消费,避免后写先到把新值覆盖。
- 位点:Canal 记 binlog file+position(或 GTID),Debezium 记在 Kafka;消费位点的提交应在处理完成之后,避免「提交了位点但没处理」丢数据。
四、坑与对照
- binlog 不是 ROW/FULL。 拿不到准确 after,或镜像被精简(
MINIMAL缺未改列),同步全字段时出问题。 - 消费非幂等 + 至少一次 = 数据错乱。 一律按可重复设计:upsert/DEL/版本号。
- 乱序覆盖。 多线程/多分区消费同一行,必须按主键路由到同一分区顺序处理。
- DDL 变更不同步。 加列/改类型时下游 schema 未更新会解析失败;DDL 要走灰度(先加可空列→双写/兼容→回填→切流),Debezium 有 schema history,也要备份。
- 积压与放大。 一次全表 UPDATE 产生百万行事件冲垮下游;大事务要拆分、对消费者限流与堆积监控(消费延迟 lag)。
- 拿 CDC 当强一致事务。 binlog→MQ→消费是秒级延迟的最终一致,不能替代下单主链路的强一致;选型见 分布式事务方案怎么选、Seata AT/TCC。
总结
CDC 数据同步:原理是让 Canal/Debezium 伪装成 MySQL 从库,通过 COM_BINLOG_DUMP 拉取并解析 binlog,必须用 ROW+FULL 才能拿到每行准确的 before/after;Canal 是轻量独立 server、贴合 MySQL 直连生态,Debezium 跑在 Kafka Connect 上、天然多源云原生;链路为 binlog→解析→Kafka(按主键分区保序)→幂等消费者删缓存/写 ES,语义是 at-least-once 所以消费端必须 upsert/DEL/版本号幂等、位点在处理成功后提交;DDL 要灰度、大事务防积压,且它是最终一致、替代不了强一致分布式事务。