深分页优化:LIMIT OFFSET 为什么慢,与游标/书签分页怎么选
更新时间:2026-09-18。列表翻到第 5000 页就明显变慢,根因几乎总是
LIMIT 100000, 20这种大偏移量:数据库不是「跳过」前 10 万行,而是老老实实查出并排序前 100020 行,再扔掉前 10 万行。本文讲清成本来源和三种优化姿势,以及「能不能跳页」这个决定选型的关键约束。前置:MySQL 索引原理、MySQL 查询优化。
本文要回答的问题
- 为什么
LIMIT 100000,20越翻越慢?慢在扫描、回表还是排序? - 延迟关联(子查询先走覆盖索引)为什么能快?
- 游标/书签分页(keyset)的 SQL 长什么样,为什么复杂度恒定?
- 游标分页不能跳页,那需要页码和总数时怎么办?
- 多列排序、不稳定排序、新数据插入导致的翻页重复/丢失怎么处理?
一、成本从哪来:扫描、回表、排序三重放大
-- 表结构:二级索引 (status, created_at),主键 id
CREATE TABLE orders(
  id BIGINT PRIMARY KEY,
  status TINYINT,
  created_at DATETIME,
  title VARCHAR(200),
  KEY idx_status_ct(status, created_at)
);

-- 深分页写法
SELECT * FROM orders WHERE status=1
ORDER BY created_at DESC LIMIT 100000, 20;
执行代价:① 沿 idx_status_ct 顺序取出约 100020 个索引记录;② 因为 SELECT *,每条都要回表拿完整行(10 万次随机 IO);③ 最后丢弃前 10 万,只返回 20 行。若排序还用不上索引,再叠加一次 filesort。越往后翻,成本线性增长。
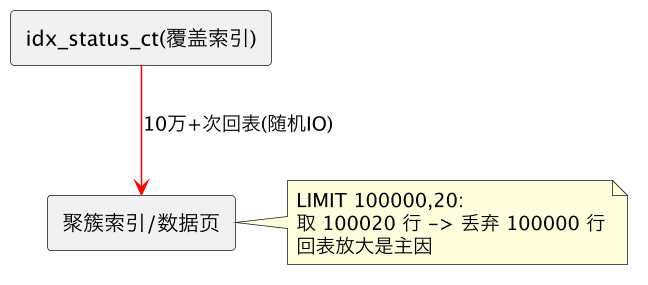
二、方案一:延迟关联,先走覆盖索引拿主键
让排序+分页只在窄索引上完成,最后才对要返回的 20 行回表:
-- 内层只查主键,走覆盖索引,不回表
SELECT t.* FROM orders t
INNER JOIN (
  SELECT id FROM orders WHERE status=1
  ORDER BY created_at DESC LIMIT 100000, 20
) k ON t.id = k.id
ORDER BY t.created_at DESC;
内层 SELECT id 在 InnoDB 二级索引叶子里就含主键,构成覆盖索引,10 万次回表降为 20 次。适合「必须保留 OFFSET 页码、但想救性能」的场景,改动最小,通常有数倍到数十倍提升,但偏移量本身的扫描仍在,到百万级仍会慢。
三、方案二:游标/书签分页(keyset pagination)
记住「上一页最后一条」的排序值,下一页用 WHERE 过滤而不是 OFFSET:
-- 第一页
SELECT id, created_at, title FROM orders WHERE status=1
ORDER BY created_at DESC, id DESC LIMIT 20;

-- 第二页:把上一页最后一条的 (created_at, id) 当书签传入
SELECT id, created_at, title FROM orders
WHERE status=1
  AND (created_at, id) < ('2026-09-01 10:00:00', 86021)
ORDER BY created_at DESC, id DESC LIMIT 20;无论翻到第几页,都是从书签位置沿索引顺序往后读 20 行,复杂度近似恒定,不回表多余行、不丢弃数据。这正是 REST API 设计 里 ?cursor=xxx&limit=20 的落地方式,适合无限滚动、消息流、日志流。
多列排序必须把全部排序列带进书签(用 (a,b) < (x,y) 或展开的 OR),且排序方向一致;否则并列值会漏数据。
四、方案三:业务约束与总数的工程处理
| 能力 | OFFSET 分页 | 游标分页 |
|---|---|---|
| 跳到任意页 | 支持 | 不支持(只能上一页/下一页) |
| 深翻性能 | 线性劣化 | 恒定 |
| 数据插入时翻页 | 会重复/错位 | 稳定(基于已见书签) |
| 总数 total | 精确好算 | 精确成本高,常用「是否有下一页」 |
| 典型场景 | 后台管理、页码导航 | App 信息流、无限滚动 |
需要页码的后台:可限制最大可翻页数(如仅前 100 页),加深筛选条件缩小结果集,或用搜索引擎(ES search_after)。需要总数:深分页场景避免每请求 COUNT(*),改为异步估算、缓存总数,或只返回 has_more(多查一条 LIMIT 21 判断)。
五、坑与对照
- 排序不稳定导致翻页重复/丢失。 仅按可能并列的列
ORDER BY created_at,书签边界并列行会漏。务必追加唯一列id组成确定性排序,并把该复合列建成匹配索引(如(status, created_at DESC, id DESC))。 - 游标分页里又想跳页。 keyset 天生不支持随机跳页,别硬套;要跳页就退回 OFFSET + 延迟关联并限制深度。
- 把游标直接暴露成自增 id 被遍历。 对外用不透明、可校验的 token(Base64 编码排序字段+签名),别让前端构造任意偏移。
SELECT *让覆盖索引失效。 延迟关联内层一定要只选主键/索引列,否则回表放大照旧。COUNT(*)与列表一起深查。 大结果集精确 count 本身就慢,和深分页是两个独立问题,分开治理(估算/缓存)。
排序节点与索引判定见 MySQL EXPLAIN 深挖;PostgreSQL 侧等价手段是 keyset + 复合索引,执行计划见 EXPLAIN (ANALYZE, BUFFERS)。
总结
深分页优化:LIMIT 100000,20 慢在要查出并排序 10 万行再丢弃、且 SELECT * 触发 10 万次回表;要保留页码就用延迟关联——子查询先走覆盖索引只取 20 个主键再回表;信息流场景改用游标书签分页 WHERE (排序列,id) < 上一页末尾 ORDER BY ... LIMIT n,沿索引顺序读、性能恒定不丢数据,代价是不能跳页、需复合唯一排序与匹配索引,总数改用估算或 has_more。