PostgreSQL EXPLAIN (ANALYZE, BUFFERS) 执行计划解读
更新时间:2026-09-18。优化器基于统计信息估算成本选计划,统计陈旧或相关列没做分析时,估算行数与真实行数天差地别,于是选到全表扫描、错误 Join 顺序、劣质 Join 算法。本篇教你像用 MySQL 的
EXPLAIN(见 MySQL EXPLAIN 深挖)一样读 PG 计划,但 PG 的EXPLAIN ANALYZE会真跑一遍给真实数据,这是它最强的武器。索引基础见 PostgreSQL 索引类型。
本文要回答的问题
EXPLAIN、EXPLAIN ANALYZE、加BUFFERS三者区别?为什么 ANALYZE 会真执行?- 计划是倒缩的树,cost/rows/width/actual time/loops 各怎么读?
- 常见扫描节点和 Join 节点的选择逻辑?
- 如何识别「估计行数 vs 实际行数」失真?根因和修法?
- BUFFERS 的 shared hit/read 如何暴露缓存命中和 IO 问题?
一、三种用法:估算、真跑、看缓存
EXPLAIN SELECT * FROM orders WHERE user_id = 42;
-- 只给“估算计划”,不执行;DML 上用它很安全

EXPLAIN (ANALYZE, BUFFERS) SELECT * FROM orders WHERE user_id = 42;
-- ANALYZE:真正执行语句并给出实际行数/耗时/循环次数
-- BUFFERS:报告共享缓存命中/读取的块数(需 ANALYZE 或单独开)
-- 注意:对 UPDATE/DELETE 用 EXPLAIN ANALYZE 会真改数据!请放进事务并 ROLLBACK:
BEGIN;
EXPLAIN (ANALYZE, BUFFERS) UPDATE orders SET status='x' WHERE id=1;
ROLLBACK;| 选项 | 是否执行 | 输出 | 用途 |
|---|---|---|---|
EXPLAIN | 否 | 估算 cost/rows | 看计划、对 DML 安全 |
ANALYZE | 是 | 增加 actual time/rows/loops | 验证估算是否准 |
BUFFERS | 配合 ANALYZE | shared hit/read、temp 块 | 看缓存命中与排序溢盘 |
VERBOSE | —— | 输出列、schema 细节 | 深度排查 |
FORMAT JSON | —— | 结构化 | 接 pg.dalibo.org 等可视化 |
二、读懂一棵计划树
计划是倒缩 + 自底向上执行的算子树:缩进最深的先执行,其输出喂给上层。
EXPLAIN (ANALYZE, BUFFERS)
SELECT u.name, count(*) FROM orders o JOIN users u ON u.id=o.user_id
WHERE o.created_at > now() - interval '1 day'
GROUP BY u.name;
输出里每行的关键字段:
(cost=0.43..8.45 rows=100 width=40)
(actual time=0.021..0.132 rows=120 loops=1)
Buffers: shared hit=30 read=2cost=启动..总成本:抽象成本单位(一次顺序页读=seq_page_cost默认 1,CPU 处理一元=cpu_tuple_cost0.01)。只在同版本同配置内可比,不是毫秒。rows:优化器估计该节点输出行数;width平均行宽。actual time=首行..全部 (ms)、rows实际行数、loops该节点被执行次数(NestLoop 内侧可能 loops 上万)。- 比较
rows(估) 与实际rows:偏差几十上百倍基本就是坏计划根因。 Buffers: shared hit/read:命中缓存块/从磁盘读块;大量 read 说明没命中。written是回写、temp块说明排序/哈希溢盘。
三、扫描节点:什么时候走什么扫描
| 节点 | 触发条件 | 特点 |
|---|---|---|
| Seq Scan | 选择性差/小表/没可用索引 | 顺序扫全表,大表高选择性查询出现它要警惕 |
| Index Scan | 高选择性 + 普通索引 | 沿索引取 TID 再回表,结果有序 |
| Index Only Scan | 索引能覆盖(visibility map 干净) | 不回堆,最快;频繁更新可见性差会退化为回表 |
| Bitmap Index Scan + Bitmap Heap Scan | 中等选择性、多索引 OR | 先建块位图再批量按物理顺序回表,减少随机 IO |
| TID Scan | ctid = | 直接按物理位置 |
 Bitmap Heap Scan on orders
   Recheck Cond: (status = 'paid')
   Heap Blocks: exact=1200
   Buffers: shared hit=2400
   ->  Bitmap Index Scan on idx_orders_status
         Index Cond: (status = 'paid')
坑一:Index Scan 不一定比 Seq Scan 快。 当要取出的行占比大(经验阈值 10~20%,取决于成本参数)时,随机回表比顺序全表更贵,优化器正确地选 Seq Scan。别看到全表扫描就喊加索引,先看选择性和 BUFFERS。
坑二:Index Only Scan 依赖 visibility map。 表刚被大量更新、可见性位图没被 vacuum 标全时,即使索引覆盖也要回表确认可见性,Heap Fetches 偏高——这又回到 VACUUM 与表膨胀治理。
四、Join 节点:三种连接算法
| Join | 成本特征 | 适用 | 坏味道 |
|---|---|---|---|
| Nested Loop | 外侧 m 行 × 内侧索引查找 | m 小、内侧能走索引 | 外侧估大了导致 loops 巨大 |
| Hash Join | 建哈希表 + 探测,O(m+n) | 大表等值连接、无可用索引 | 哈希溢盘(Batches>1、temp 块) |
| Merge Join | 两侧都已排序后归并 | 两边都大且已有序/可走索引排序 | 为它付出大排序不划算 |
-- 让内侧用上索引,Nested Loop 才高效
CREATE INDEX idx_orders_user ON orders(user_id);
-- Hash Join 想不溢盘,调大 work_mem(仅在该会话压测,别盲目全局调)
SET work_mem = '64MB';
EXPLAIN (ANALYZE, BUFFERS) SELECT ... ; -- 观察 Hash Batches 是否降为 1坑三:work_mem 太小让排序/哈希溢盘。 计划里出现 Sort Method: external merge Disk: xxxkB 或 Hash Batches: 128 且 BUFFERS 有 temp read/written,就是溢盘信号。work_mem 是「每个排序/哈希节点」的预算,会被并发查询放大,不能按总内存拍脑袋,要按 max_connections × 每查询节点数 留余量。
五、行数估计失准:坏计划的头号根因
判断方法:扫 EXPLAIN ANALYZE 里每个节点的 rows(估) vs 实际 rows。
->  Seq Scan on orders  (cost=.. rows=10 width=..)
                       (actual time=.. rows=52000 loops=1)
估计 10、实际 52000,差 5000 倍——优化器以为外层只有 10 行选了 NestLoop,实际 5 万行内层被打了 5 万次。
根因与修法:
- 统计信息陈旧 →
ANALYZE orders;(autovacuum 也会做,大表可手动)。 - 统计精度不够 → 提高该列采样目标:
ALTER TABLE orders ALTER COLUMN status SET STATISTICS 1000;
ANALYZE orders; -- 默认 default_statistics_target=100,倾斜严重的列调高- 相关列被当独立(如 status 与 created_at 强相关)→ 用扩展统计建多列相关性/多列 ndistinct:
CREATE STATISTICS st_orders_status_time (dependencies, ndistinct)
  ON status, created_at FROM orders;
ANALYZE orders;- 相关子查询/函数误估(
WHERE x = my_func()默认估计很粗)→ 改写成 JOIN、或对不可内联函数标注ROWS估计。 - 计划缓存/参数嗅探(PL/pgSQL 用通用计划)→ 必要时用动态 SQL 或调
plan_cache_mode。
六、用 BUFFERS 和成本参数对齐真实硬件
默认成本参数假设的是古老磁盘,跑在 SSD/大内存上常常误判:
SELECT name, setting FROM pg_settings
WHERE name IN ('seq_page_cost','random_page_cost','effective_cache_size',
'work_mem','shared_buffers','max_parallel_workers_per_gather');| 参数 | 默认 | SSD/大内存建议 | 说明 |
|---|---|---|---|
random_page_cost | 4.0 | 1.1~1.5 | SSD 随机读没那么贵,调低让优化器更愿走索引 |
seq_page_cost | 1.0 | 1.0 | 基准,一般不动 |
effective_cache_size | 4GB | 物理内存的 50~75% | 告诉优化器 OS+PG 大概能缓存多少,影响索引意愿 |
shared_buffers | 128MB | 内存 25%(封顶常用值) | 真实共享缓存 |
work_mem | 4MB | 按并发预算给 16~64MB | 防排序/哈希溢盘 |
坑四:调成本参数前先有 BUFFERS 证据。 盲目把 random_page_cost 调低可能让本应顺序扫的查询走大量随机回表。正确顺序是:先用 EXPLAIN (ANALYZE,BUFFERS) 看是估计失真(先 ANALYZE/统计)还是 IO 成本假设问题(再调成本参数),每次只改一个变量并回归。
七、一个标准排查流程
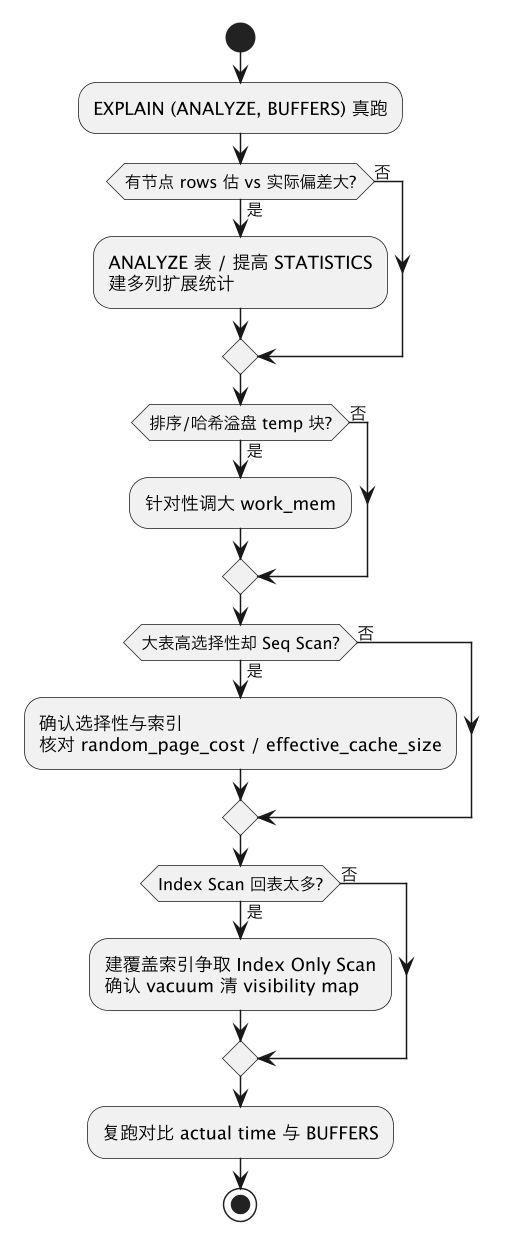
可视化辅助:把 EXPLAIN (ANALYZE, BUFFERS, FORMAT JSON) 的结果贴到 explain 可视化站点,节点按耗时/行数着色,最宽的节点就是瓶颈,比纯文本更快定位。
八、相关与延伸
索引节点背后的结构见 PostgreSQL 索引类型;统计信息由 autovacuum/ANALYZE 更新,膨胀与可见性图见 VACUUM 与表膨胀治理;缓存命中率思路与 InnoDB Buffer Pool 相通;MySQL 对照见 MySQL EXPLAIN 深挖 与 MySQL 查询优化。
总结
PostgreSQL EXPLAIN (ANALYZE, BUFFERS):EXPLAIN 只估不执行、ANALYZE 真跑给实际行数与 loops(DML 要裹事务回滚)、BUFFERS 暴露缓存命中与溢盘;计划是倒缩树自底向上,核心是对比每个节点的估算 rows 与实际 rows——失准先 ANALYZE/提高 STATISTICS/建多列扩展统计,溢盘调 work_mem,高选择性却全表扫再核对索引与 random_page_cost/effective_cache_size,每次只改一个变量并用 BUFFERS 回归。