PostgreSQL 与 MySQL 架构和使用差异对照
更新时间:2026-09-18。本篇是给「会 MySQL、要上手 PostgreSQL」(或反向)的工程师的对照地图。两边都能支撑绝大多数 OLTP,差别主要在架构哲学、默认行为和运维手感。建议先建立地基:MySQL 侧 MySQL 索引原理、MySQL 锁与事务、MySQL 查询优化;PostgreSQL 侧 架构与 MVCC。
本文要回答的问题
- 进程模型和连接管理有何不同?为什么 PG 更依赖连接池?
- 两种 MVCC 在存储上的根本差异,如何决定各自的运维重点?
- 隔离级别、锁、自增、大小写、类型系统有哪些「反直觉」差异?
- 复制与高可用生态各是什么形态?什么项目更适合选哪个?
一、架构与进程模型
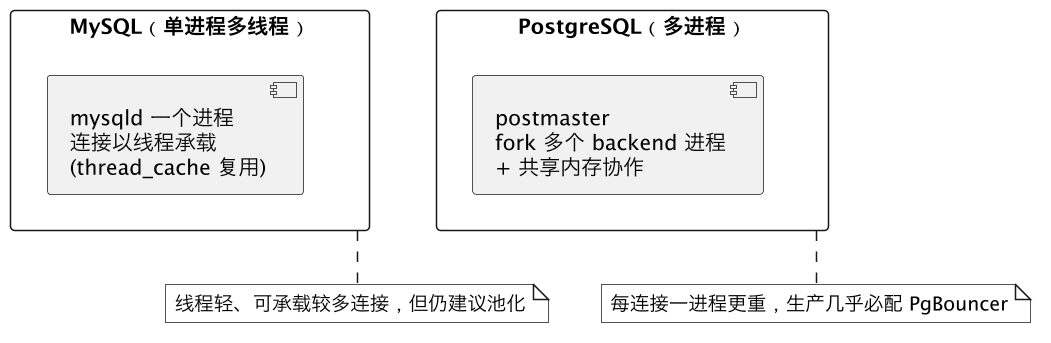
| 维度 | MySQL(InnoDB) | PostgreSQL |
|---|---|---|
| 并发单元 | 一个连接一个线程 | 一个连接一个进程 |
| 连接内存 | 线程较轻 | 每 backend 约 5~10MB |
| 直连数千连接 | 相对能扛(仍不推荐) | 明显吃力,必须 PgBouncer |
| 扩展能力 | 组件较固定 | 扩展生态极强(PostGIS/pgvector/TimescaleDB/Citus) |
连接复用见 PgBouncer 事务级复用,应用进程内池化见 连接池调优:HikariCP 参数与连接数公式。
二、MVCC 与存储:最根本的差异
这是理解两边一切运维差异的钥匙。
| 维度 | InnoDB | PostgreSQL |
|---|---|---|
| 更新方式 | 原地更新数据页,旧版本写 undo 段 | 插新版本留旧版本在堆表 |
| 旧版本位置 | undo log | 堆表里的死元组 |
| 读旧版本 | 沿回滚指针去 undo 拼装 | 在堆表里按快照选可见版本 |
| 主要膨胀对象 | undo 表空间(长事务撑大) | 表 + 索引(死元组) |
| 回收机制 | purge 线程持续清 undo | VACUUM/autovacuum,可能需 repack |
| 回滚成本 | 用 undo 反向还原 | 未提交版本天然不可见,近乎免费 |
工程含义:MySQL DBA 盯 undo 增长、purge 是否卡住、长事务;PostgreSQL DBA 盯死元组/膨胀、autovacuum、最老事务 xmin、冻结年龄。PG 高频更新表要会用 HOT、fillfactor、pg_repack,详见 VACUUM 与表膨胀治理。
三、隔离级别与锁的默认行为
| 维度 | MySQL/InnoDB | PostgreSQL |
|---|---|---|
| 默认隔离级别 | REPEATABLE READ | READ COMMITTED |
| RR 实现 | 快照 + 间隙锁/临键锁防幻读 | 纯快照,无间隙锁,不防写偏差 |
| 最强级别 | SERIALIZABLE(基于锁) | SERIALIZABLE(SSI 谓词锁,冲突报错需重试) |
| 普通 SELECT | RR 下一致性视图 | 不加点锁(用 MVCC 快照) |
| 显式加锁 | SELECT ... FOR UPDATE | 同名;另有 FOR SHARE/NOWAIT/SKIP LOCKED |
坑: 从 MySQL 迁到 PG,默认隔离级别从 RR 变 RC,依赖「事务内两次读一致」的代码会读到新值;把 MySQL 防幻读假设套到 PG 的 RR 上会漏掉写偏差。详见 架构与 MVCC 与 MySQL 锁与事务。
四、SQL 方言与类型系统
| 特性 | MySQL | PostgreSQL |
|---|---|---|
| 自增 | AUTO_INCREMENT | GENERATED ... IDENTITY 或 SERIAL(sequence) |
| 自增取回 | LAST_INSERT_ID() | RETURNING id(增删改都能 RETURNING) |
| UPSERT | ON DUPLICATE KEY UPDATE | ON CONFLICT (...) DO UPDATE/NOTHING |
| 半结构化 | JSON(函数较弱) | JSONB(二进制、可 GIN) |
| 数组列 | 无原生数组 | 原生数组 + 操作符/GIN |
| 布尔 | TINYINT(1) 模拟 | 真正 BOOLEAN |
| 引号 | 双引号有时当字符串 | 单引号=字符串,双引号=标识符 |
| 标识符折叠 | Linux 下表名区分大小写 | 未加引号折叠成小写 |
| 大小写匹配 | LIKE 视排序规则 | LIKE 敏感、ILIKE 不敏感;正则 ~ |
sql
-- PG 三件套:RETURNING / ON CONFLICT / 数组与 JSONB
INSERT INTO users(name, tags) VALUES ('Tom', ARRAY['pg','dba'])
ON CONFLICT (name) DO UPDATE SET tags = EXCLUDED.tags
RETURNING id, created_at;

SELECT id, data->>'city' AS city FROM docs

## 五、索引、执行计划与优化器

| 维度 | MySQL | PostgreSQL |
|------|-------|------------|
| 默认索引 | B+ 树(聚簇,二级索引回表) | B-tree(**堆表非聚簇**;索引经 TID 回堆) |
| 索引家族 | B+ 树为主 | B-tree/Hash/**GIN/GiST/SP-GiST/BRIN** |
| JSON 索引 | 多值/虚拟生成列(有限) | **JSONB + GIN** 成熟 |
| 看计划 | `EXPLAIN`、`FORMAT=JSON` | `EXPLAIN (ANALYZE, BUFFERS)` **真跑一遍**给真实行数/缓冲 |
| 统计信息 | 持久化统计 | `ANALYZE` 刷直方图,陈旧会选错计划 |

- InnoDB 聚簇索引叶子就是行;PG 是「索引→TID→堆元组」,改任何索引列都要维护索引(HOT 正是缓解此点)。
- PG 排查看计划首选带 `ANALYZE, BUFFERS`,见 [EXPLAIN (ANALYZE, BUFFERS)](/database/relational/postgresql-explain-analyze.md);MySQL 侧见 [MySQL EXPLAIN 深挖](/database/relational/mysql-explain-deep-dive.md)。

## 六、日志、复制与高可用生态

| 维度 | MySQL | PostgreSQL |
|------|-------|------------|
| 变更日志 | binlog(逻辑/行,CDC 生态成熟) | WAL(物理)+ 逻辑解码 |
| 主从复制 | binlog 异步/半同步、GTID | 流复制(按 WAL LSN),同步/异步 |
| 读备库 | 从库可读 | **Hot Standby** 备库直接查 |
| 自动故障转移 | MHA/MGR/Orchestrator | **Patroni + etcd/Consul、repmgr**(多为自建) |
| 中间件 | Router、ProxySQL | PgBouncer、Pgpool |
| CDC | Canal/Debezium 监听 binlog | Debezium/逻辑槽监听逻辑解码 |

**坑:** PG 物理复制槽若备库长期断开,会**保留 WAL 不清理**,可能撑爆主库磁盘;`hot_standby_feedback=on` 又会把备库旧 xmin 传回主库,**抑制主库 VACUUM** 造成膨胀——这是 MySQL 背景工程师最易忽略的一条,见 [WAL 与 checkpoint](/database/relational/postgresql-wal-checkpoint.md)。CDC 工具链实践见 [CDC 数据同步:Binlog 监听 Canal/Debezium](/database/practice/cdc-binlog-canal-debezium.md)。

## 七、运维手感与选型

| 维度 | MySQL | PostgreSQL |
|------|-------|------------|
| 部署 | 主从成熟、工具链省心 | 单实例多 database/schema,扩展丰富 |
| 连接池 | 应用内池/ProxySQL | **PgBouncer 几乎是标配** |
| 回收 | purge 自动,少操心 | 必须运维 autovacuum/膨胀 |
| PITR | binlog | WAL 归档 + base backup |
| 强项 | 互联网 CRUD、运维简单、云托管最广 | 复杂查询、GIS、JSONB、向量、时序、HTAP 混合 |

**选型建议:**

- **选 MySQL**:标准互联网 OLTP、团队有 MySQL 积累、想要省心主从与最广云托管、CDC 入仓链路成熟。
- **选 PostgreSQL**:复杂查询/多表 JOIN、强类型与复杂约束、需要 JSONB/数组/GIS/向量/时序扩展、希望一库覆盖更多负载。
- 不要只看 benchmark 峰值,要看团队对各自运维坑(PG 的 autovacuum/膨胀/复制槽;MySQL 的 undo/间隙锁/复制一致性)的掌控力。

## 八、相关与延伸

> MySQL 地基:[MySQL 索引原理](/database/mysql-index.md)、[MySQL 锁与事务](/database/relational/mysql-locks-transactions.md)、[MySQL 查询优化](/database/relational/mysql-query-optimization.md);PG 地基:[架构与 MVCC](/database/relational/postgresql-architecture-mvcc.md)、[VACUUM 与表膨胀治理](/database/relational/postgresql-vacuum-bloat.md)、[索引类型](/database/relational/postgresql-index-types-gin-gist-brin.md)、[WAL 与 checkpoint](/database/relational/postgresql-wal-checkpoint.md);连接池:[PgBouncer](/database/relational/postgresql-connection-pool-pgbouncer.md) 与 [HikariCP 调优](/database/practice/connection-pool-hikaricp-tuning.md)。

## 总结

**PostgreSQL 与 MySQL 差异**:MySQL 单进程多线程、InnoDB 原地更新+undo、默认 RR 带间隙锁、运维省心生态广;PostgreSQL 多进程(标配 PgBouncer)、堆表插新留旧靠 VACUUM、默认 RC 纯快照、类型与索引家族(JSONB/GIN/GiST/BRIN)和扩展生态更强但要会治膨胀与复制槽——标准互联网 CRUD 偏 MySQL,复杂查询与多模/扩展负载偏 PostgreSQL,最终决定因素往往是团队对各自运维坑的掌控力。

WHERE data @> '{"vip": true}'::jsonb;   -- 配合 GIN 索引
最常见迁移坑(双引号): MySQL 里 "abc" 可能被当字符串,PG 里 "abc" 是列名,字符串必须 'abc';PG 还把未加引号的名字折叠为小写,习惯驼峰建表又不打引号的人会找不到列。