MySQL EXPLAIN 深挖:type、key_len、rows、Extra 与索引失效判定
更新时间:2026-09-18。MySQL 查询优化 给了优化方法论,本篇把
EXPLAIN输出的每一列讲到能独立判案的程度,并和 PostgreSQL 的「真跑一遍」计划做对照(见 PostgreSQL EXPLAIN (ANALYZE, BUFFERS))。索引为什么这样工作见 MySQL 索引原理,事务锁见 MySQL 锁与事务。
本文要回答的问题
type列各值的好坏排序?看到 ALL/index 一定有问题吗?key_len怎么算?如何用它判断复合索引到底用了几列、可不可空、字符集影响?rows、filtered、possible_keys/key怎么读?Extra里 Using where / Using index / Using filesort / Using temporary / Using index condition 各代表什么?- 隐式类型转换、函数包装、
OR、LIKE前导通配符为什么让索引失效?
一、EXPLAIN 输出列总览
EXPLAIN SELECT u.name, o.* FROM orders o
JOIN users u ON u.id = o.user_id
WHERE o.status='paid' AND o.created_at > '2026-09-01'
ORDER BY o.created_at DESC LIMIT 20;| 列 | 作用 | 重点 |
|---|---|---|
| id | 查询块标识 | 相同 id 从上到下执行;越大越先执行(子查询) |
| select_type | SIMPLE/PRIMARY/SUBQUERY/DERIVED 等 | 识别派生表、相关子查询 |
| table | 当前行访问的表 | 别名 |
| type | 访问类型(怎么找行) | 本篇核心 |
| possible_keys | 可能用的索引 | 有但 key 为 NULL 说明优化器没选 |
| key | 实际选的索引 | NULL=没用索引 |
| key_len | 用到的索引前缀长度 | 推算复合索引用了几列 |
| ref | 索引比较的来源 | const/列/func |
| rows | 估算要扫描的行数 | 越小越好(估算,非精确) |
| filtered | 经过 WHERE 后剩余百分比 | rows×filtered 估算最终行 |
| Extra | 附加信息 | Using filesort/temporary 等 |
MySQL 8 推荐用 EXPLAIN FORMAT=JSON(含成本细节、被触发的条件)以及 EXPLAIN ANALYZE(8.0.18+,真跑并给实际耗时,接近 PG 的 ANALYZE)。
二、type:访问类型好坏排序
从好到差大致:
system > const > eq_ref > ref > range > index_merge > ref_or_null
> index_subquery > range ... > index > ALL| type | 含义 | 场景/评价 |
|---|---|---|
| system/const | 主键或唯一索引等值,最多 1 行 | 最优,按主键点查 |
| eq_ref | JOIN 时被驱动表用主键/唯一索引等值匹配,每行匹配 1 条 | 很好 |
| ref | 非唯一索引等值匹配 | 常见且好 |
| range | 索引范围扫描(>、BETWEEN、IN、前缀 LIKE) | 常见,可接受 |
| index_merge | 合并多个索引(常见 OR/交集) | 有时是计划不够好的信号,注意 rows 估算 |
| index | 扫整个索引树(不回表时是覆盖扫描;否则不如 range) | 看是否覆盖索引 |
| ALL | 全表扫描 | 大表 + 高选择性时是重点优化对象 |
坑一:ALL 不等于一定要加索引。 小表、或要取出表中大部分行(低选择性,优化器认为回表随机 IO 比顺序扫贵)时,全表扫描是正确选择。判断要看 rows 占总行数比例和真实耗时,而不是见 ALL 就改。
三、key_len:精确判断复合索引用到了哪几列
key_len 只统计实际参与查找/过滤的最左前缀列,是判断「复合索引有没有用足、最左前缀断在哪」的硬证据。
计算规则(utf8mb4 下):
| 类型 | 每列字节 |
|---|---|
INT | 4 |
BIGINT | 8 |
DATE 3 / DATETIME 5 / TIMESTAMP 4(8.0 部分含小数) | 3~5 |
定长 CHAR(n) | n × 4(utf8mb4) |
变长 VARCHAR(n) | n × 4 + 2(变长长度字节) |
| 可空列 | 额外 +1(NULL 标志) |
复合索引 (a INT, b INT, c VARCHAR(20)),三列都用到且 c 可空(utf8mb4):
a:4 + b:4 + c:(20*4 +2) + c 可空 1 = 91key_len=4只用到 a;=8用到 a,b;=91三列都用于查找。- 范围条件之后的列无法继续用于查找(key_len 停在范围列),但仍可能用于索引条件下推过滤。
ALTER TABLE orders ADD INDEX idx_a_b_c (a, b, c);
EXPLAIN SELECT * FROM t WHERE a=1 AND b>5 AND c='x';
-- key_len 只到 b:c 在范围列之后不参与定位(ICP 可在引擎层过滤 c)
坑二:看到 key=idx_a_b_c 不等于三列都生效。 必须用 key_len 确认最左前缀长度;列顺序应按「等值列在前、范围列靠后、排序列酌情」设计,这与 MySQL 索引原理 的最左前缀一致。
四、rows 与 filtered:估算不是实测
rows:优化器估计为完成这步要检查的行数(基于索引基数/统计信息)。filtered:估计经 WHERE 条件过滤后留下的百分比。- JOIN 中,驱动表
rows×filtered%估计有多少行去探测被驱动表——filtered 估错常导致选错驱动表和 Join 顺序。
统计信息陈旧(大量增删后未更新)会让 rows 偏差巨大,可 ANALYZE TABLE t; 刷新;这与 PostgreSQL 里「估算 rows vs 实际 rows 失真」是同一类问题(见 PG EXPLAIN)。
五、Extra:高频值判读
| Extra | 含义 | 行动 |
|---|---|---|
Using index | 覆盖索引,不回表 | 好事,尽量争取 |
Using where | 引擎层返回后还要 Server 层过滤 | 单列常见,配合大 rows 要警惕 |
Using index condition | 索引下推 ICP,在引擎层用索引字段过滤,减少回表 | 好事 |
Using filesort | 排序无法用索引顺序,需额外排序(不一定落盘) | 大数据量排序要优化索引/排序 |
Using temporary | 用了临时表(GROUP BY/DISTINCT/UNION) | 数据大时可能落磁盘,重点优化 |
Using join buffer (Block Nested Loop) | 被驱动表无可用索引,用缓冲做嵌套扫描 | 给 Join 列加索引 |
Select tables optimized away | 聚合可直接由索引得到(MIN/MAX) | 最优 |
Impossible WHERE | 条件恒假 | 检查业务 SQL |
坑三:Using filesort 名字吓人但不代表用了磁盘文件。 小结果集在内存 sort_buffer 里排也是 filesort;只有数据量超过 buffer 才发生临时文件排序(8.0 的 EXPLAIN ANALYZE/优化器跟踪能看到 actual)。优化手段是让 ORDER BY 走索引有序性,或缩小排序集(先用索引过滤再排序)。Using temporary; Using filesort 同时出现且 rows 大,通常是 GROUP BY/ORDER BY 与索引顺序不匹配的信号。
六、索引失效的典型判定
1)隐式类型转换。 字符串列传数字:
-- phone 是 varchar,传数字触发隐式转换,索引失效(等价于对列套函数)
SELECT * FROM users WHERE phone = 13800000000;   -- type 可能变 ALL
SELECT * FROM users WHERE phone = '13800000000'; -- ref,正常走索引
2)索引列上用函数/运算。
WHERE DATE(created_at) = '2026-09-18'          -- 失效,改写为范围
WHERE created_at >= '2026-09-18' AND created_at < '2026-09-19'
WHERE amount + 1 = 100                          -- 失效,改成 amount = 99
3)前导通配 LIKE。 LIKE '%abc' 无法用 B+ 树前缀定位(可考虑反向索引/全文);LIKE 'abc%' 是 range,可用索引。
4)OR 两侧不同索引/列。 WHERE a=1 OR b=2,若不能都走索引常退化为全表;可拆 UNION ALL 或观察 index_merge 是否更优。
5)违背最左前缀 / 范围列后再等值。 复合索引 (a,b,c),缺 a、或 b 用范围导致 c 不能定位(用 key_len 验证)。
6)!=、NOT、IS NOT NULL 选择性问题。 多数因匹配行太多被优化器判为全表——本质是成本而非语法禁用。
7)collation 不一致的 Join。 两表 Join 列字符序不同触发隐式转换,索引失效且 type 极差,统一字符集根治。
七、一个判案流程
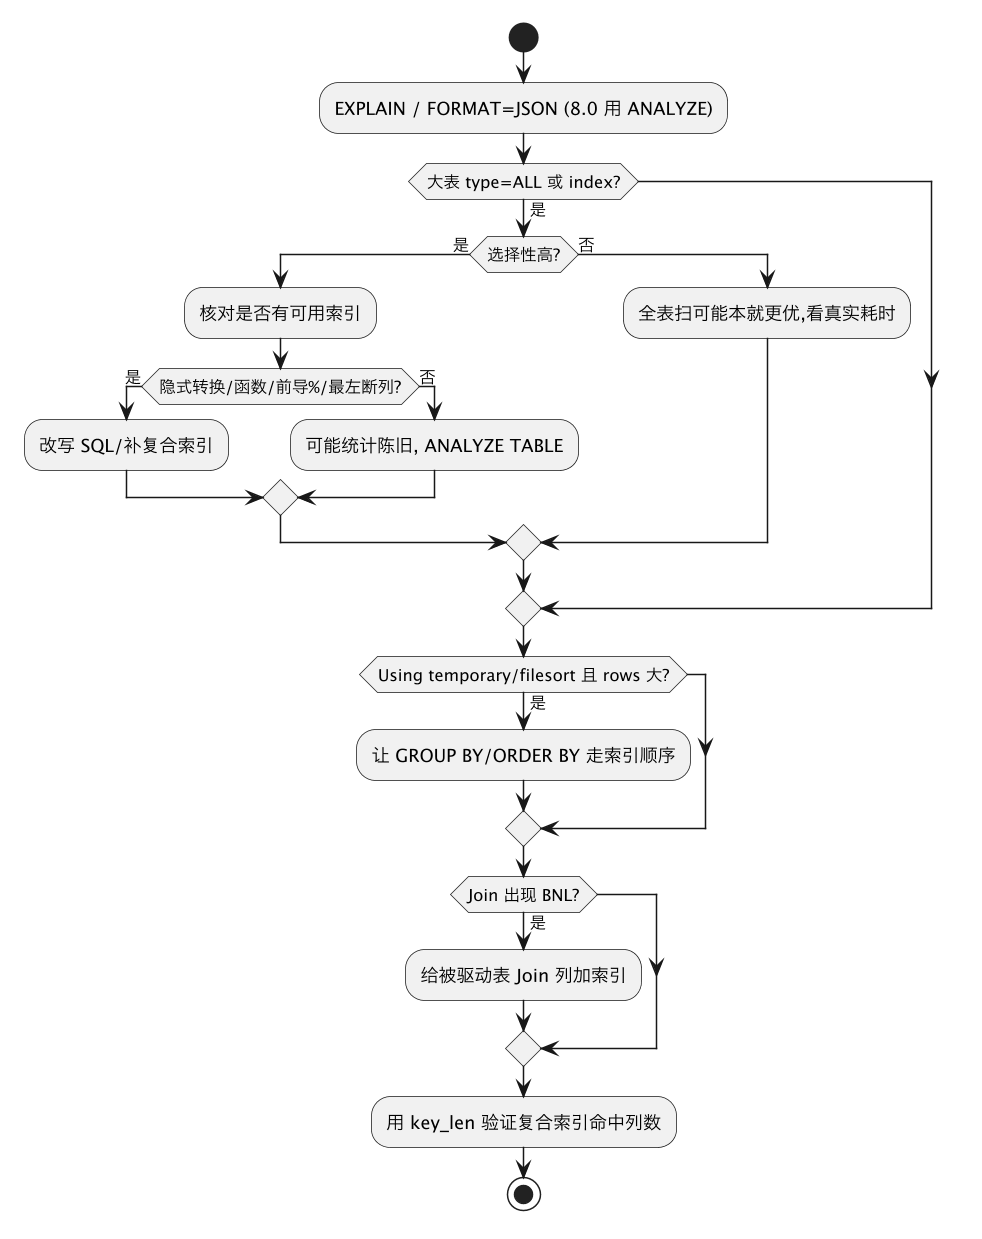
八、相关与延伸
索引底层与最左前缀见 MySQL 索引原理;慢查询方法论、覆盖索引/下推见 MySQL 查询优化;锁与间隙锁见 MySQL 锁与事务;内存与统计见 InnoDB Buffer Pool;PostgreSQL 计划对照(真跑、BUFFERS、rows 偏差)见 PostgreSQL EXPLAIN (ANALYZE, BUFFERS)。
总结
MySQL EXPLAIN 深挖:重点看 type(const/eq_ref/ref/range 好,大表 ALL/index 要查但别见 ALL 就加索引,小表或低选择性全表扫可能更优)、key(实际索引)、key_len(按 INT 4/BIGINT 8/varchar 按字符集×n+2、可空+1 精确反推复合索引用到第几列,范围列后不再用于定位)、rows×filtered(估算,陈旧就 ANALYZE TABLE);Extra 里 Using index 是覆盖、Using index condition 是下推、Using filesort 不一定落盘、Using temporary+filesort 且 rows 大要让排序/分组走索引、Join BNL 要补索引;隐式类型转换、列上函数/运算、前导通配 LIKE、OR、违背最左前缀、collation 不一致是最常见的索引失效根因。