MySQL redo/undo log 与崩溃恢复流程
更新时间:2026-09-18。redo log 保证已提交的修改掉电不丢(持久性 + 崩溃前滚),undo log 同时承担事务回滚和 MVCC 旧版本两件事,二者再与 Server 层的 binlog 通过两阶段提交协同。理解这套机制,才能正确设置刷盘参数、看懂崩溃恢复日志。前置:MySQL 锁与事务(MVCC/隔离级别)、InnoDB Buffer Pool(脏页与刷脏);PostgreSQL 对应物见 WAL 与 checkpoint。
本文要回答的问题
- redo log 是什么、为什么循环写?ib_logfile 与 checkpoint 什么关系?
- undo log 为什么既能回滚又能提供 MVCC 旧版本?
- 崩溃恢复分几步?哪些事务前滚、哪些回滚?
- redo(引擎层)和 binlog(Server 层)都记日志,为什么还要两阶段提交?
innodb_flush_log_at_trx_commit、sync_binlog、doublewrite 怎么取舍?
一、三种日志先分清楚
| 日志 | 所在层 | 内容 | 生命周期 | 主要用途 |
|---|---|---|---|---|
| redo log | InnoDB 引擎层 | 物理:某页某偏移改成什么 | 固定大小循环写、覆盖旧段 | 持久性、崩溃前滚、让脏页延迟刷 |
| undo log | InnoDB 引擎层 | 逻辑反向:旧值/删除标记 | 随事务与 MVCC 需要保留,purge 清理 | 回滚、MVCC 一致性读 |
| binlog | Server 层 | 逻辑:语句或行变更 | 追加写、按文件保留 | 主从复制、PITR、CDC |
redo 是物理日志、循环写;binlog 是逻辑日志、追加写——这点常被混淆。
二、redo log:WAL 先行与循环写
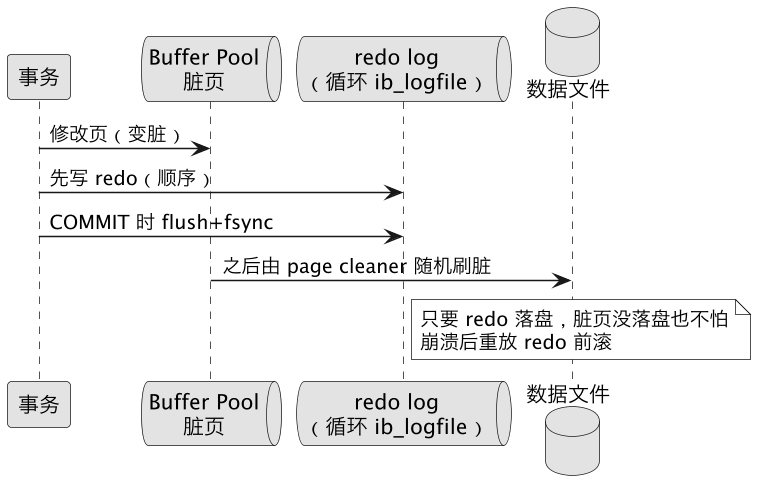
redo log 是固定大小的环形文件(innodb_log_file_size × 组数),有两个关键位置:
- write pos:写入位置,往前推进;
- checkpoint:此前对应的脏页都已刷盘,这之前的 redo 可被覆盖。
write pos 追 checkpoint 之间是「还没用、可写」空间;checkpoint 追 write pos 之间是「脏页未落盘、必须保留」的 redo。写得快、刷脏慢导致 write pos 追上 checkpoint 时,InnoDB 必须立刻强制刷脏推进 checkpoint,产生 IO 尖刺(与 Buffer Pool 刷脏调优同源,见 InnoDB Buffer Pool)。
坑一:redo 太小导致频繁「突击刷脏」。 老版本默认 48MB/文件极易写满,表现为周期性 RT 抖动。MySQL 8.0 改为可动态扩容、默认约 100MB×... 但写密集仍应调大 innodb_log_file_size(如 1~4GB 量级,按可接受的崩溃恢复时间定),8.0 直接改 innodb_redo_log_capacity。
三、刷盘级别:持久性 vs 性能
SHOW VARIABLES LIKE 'innodb_flush_log_at_trx_commit';
SHOW VARIABLES LIKE 'sync_binlog';innodb_flush_log_at_trx_commit:
| 值 | 行为 | 掉电风险 |
|---|---|---|
| 1(默认) | 每次提交都 flush+fsync redo | 不丢已提交事务,最安全 |
| 0 | 每秒才刷一次 | OS/主机掉电可能丢约 1 秒已提交事务 |
| 2 | 每次提交写到 OS cache,每秒 fsync | 进程崩溃不丢、主机掉电可能丢约 1 秒 |
sync_binlog:1 表示每次事务都 fsync binlog(最安全,配合 redo=1 即「双 1」);0/N 由 OS 或每 N 次刷,性能好但掉电可能丢 binlog、影响主从/PITR。
坑二:金融/订单不要为了吞吐把双 1 改掉而不留兜底。 真要放宽(如日志、可重放写入),应明确「最多丢 1 秒、可接受」,配合组提交(binlog_group_commit_sync_delay 等)在不牺牲太多安全的前提下合并 fsync,而不是简单设 0。
四、undo log:回滚 + MVCC 一份日志两用
事务修改一行前,旧版本被记入 undo:
- 回滚:未提交事务执行 ROLLBACK(或崩溃后判定要撤销)时,按 undo 做反向操作(INSERT 反向 DELETE、DELETE 反向插回、UPDATE 改回旧值)。
- MVCC 一致性读:旧版本通过行记录的回滚指针(DB_ROLL_PTR)串成版本链,ReadView 判断可见性时沿链取到对自己可见的旧版本(机制见 MySQL 锁与事务)。
聚簇索引行(最新, trx_id=T5, roll_ptr) ──► undo: v3(T4) ──► v2(T2) ──► v1(T1)
                                          一致性读沿版本链找可见版本
由此产生 undo 清理问题:只要还有长事务/一致性读需要看很老的版本,purge 线程就不能清理对应 undo,undo 表空间会持续膨胀。这与 PostgreSQL 长事务阻止 VACUUM 是镜像问题(见 PostgreSQL VACUUM)。监控长事务是共同的运维铁律。
五、redo 与 binlog 的两阶段提交(2PC)
为什么需要:redo 属于 InnoDB、binlog 属于 Server,主从复制依赖 binlog。若只写了一边就崩溃,会出现「主库数据和从库重放 binlog 的结果不一致」。两阶段提交保证二者原子:
1. InnoDB 写 redo(状态=PREPARE),fsync
2. Server 写 binlog,fsync
3. InnoDB 写 redo(状态=COMMIT)
崩溃恢复时:
   - 有 redo COMMIT           -> 提交,前滚
   - redo 处于 PREPARE:
       binlog 完整且有该 XID  -> 提交(保证从库也会重放)
       binlog 不完整/缺失     -> 回滚
判据的关键:以「binlog 是否完整落盘」决定 PREPARE 事务提交还是回滚,从而让引擎数据与复制日志严格对齐。XID 用于把 redo 事务和 binlog 事件对应起来。
六、崩溃恢复三阶段
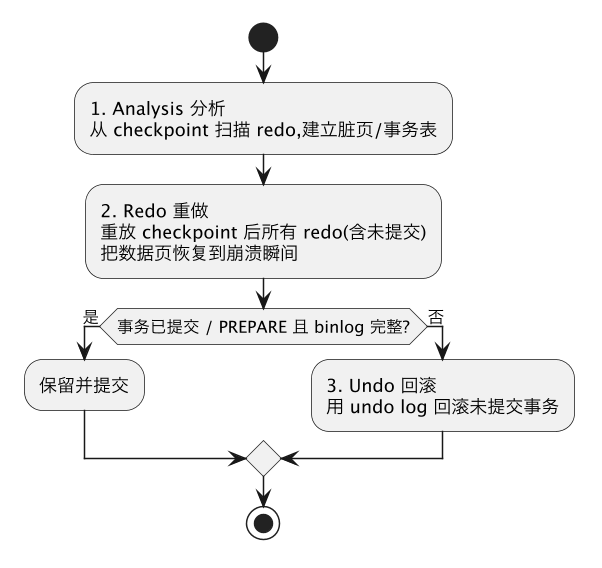
- Analysis(分析):从最近 checkpoint 出发,扫 redo 确定崩溃时哪些页脏、哪些事务在跑。
- Redo(重做/前滚):重放 checkpoint 之后全部物理修改(不管当时提没提交),把数据库物理恢复到崩溃瞬间状态。这一步是「幂等」的物理重放。
- Undo(回滚):对崩溃时仍未提交(或 PREPARE 但 binlog 不完整)的事务,用 undo 反向回滚。
这解释了为什么「redo 负责前滚、undo 负责回滚」,也解释了 checkpoint 越老、redo 越多,崩溃恢复越慢(与 PG 调 checkpoint 的权衡一致)。
七、doublewrite:防「部分页写」
redo 是物理页内增量:若脏页 16KB 往磁盘只写了 4KB 就掉电(torn page),页本身损坏,重放「基于旧页的增量 redo」也救不回来。doublewrite buffer 在刷脏前先把整页写到一段连续的 doublewrite 区,再写各自位置:
- 恢复时发现页校验/页码不对,先从 doublewrite 区取整页副本恢复页,再应用 redo。
- 代价是额外一份顺序写(有性能损耗,但通常可接受,SSD 上也建议保留,除非存储/文件系统保证 16KB 原子写)。
八、参数速查与取舍清单
| 参数 | 安全值 | 放宽后的收益/风险 |
|---|---|---|
innodb_flush_log_at_trx_commit | 1 | 0/2 提交易,但主机掉电丢约 1 秒已提交事务 |
sync_binlog | 1(双 1) | 0/N 性能好,掉电可能丢 binlog、影响复制/PITR |
innodb_redo_log_capacity/log_file_size | 按 RTO 设 1~4GB 级 | 太小频繁突击刷脏、RT 抖动;太大崩溃恢复慢 |
innodb_doublewrite | ON | 关了省写但有撕裂页风险(除非存储保证原子写) |
binlog_group_commit_sync_delay | 默认 0 | 适当调大攒组提交,降低 fsync 次数、提吞吐 |
排查崩溃恢复时,先看错误日志的 Database was not shut down normally、Starting crash recovery、redo 前滚与 undo 回滚数量,再核对双 1、redo 容量、doublewrite 与磁盘 fsync 实际行为(警惕 RAID 缓存与云盘持久性宣称)。
九、相关与延伸
脏页/刷脏/checkpoint 的内存侧见 InnoDB Buffer Pool;undo 版本链与 ReadView、锁见 MySQL 锁与事务;执行与回表见 MySQL 查询优化;PostgreSQL 的 WAL/复制槽对照见 PostgreSQL WAL 与 checkpoint 与 架构与 MVCC。
总结
MySQL redo/undo log 与崩溃恢复:redo 是引擎层物理日志、固定环形空间 WAL 先行,让脏页可延迟随机刷、崩溃后前滚,写满会强制刷脏产生 IO 尖刺故要调大容量;undo 一份两用——回滚未提交事务 + 沿回滚指针版本链支撑 MVCC,长事务会让它无法 purge 而膨胀;redo 与 Server 层 binlog 靠 PREPARE→写 binlog→COMMIT 两阶段提交保证主从一致;崩溃恢复走分析→重做(前滚所有物理变更)→回滚(未提交事务),doublewrite 防 16KB 页半写;生产用「双 1」保已提交事务不丢,放宽前必须确认能接受约 1 秒丢失。