PostgreSQL 架构与 MVCC:进程模型、多版本元组与快照可见性
更新时间:2026-09-18。本文是数据库域 PostgreSQL 系列第一篇。MySQL/InnoDB 用 undo log 保存旧版本、原地更新数据页;PostgreSQL 走的是另一条路——更新即插入新版本,旧版本留在表里,靠 VACUUM 回收。理解这条根本差异,才能看懂后面的 VACUUM、WAL、索引选型。前置阅读:MySQL 锁与事务(对比两种 MVCC)、MySQL 索引原理(B+ 树基础)。
本文要回答的问题
- PostgreSQL 的进程模型是什么?一条连接进来发生了什么?
- 为什么说 PostgreSQL「不原地更新」?旧版本存在哪?
xmin/xmax是什么?一条元组凭什么对当前事务「可见」?- 快照(snapshot)的
xmin/xmax/xip如何判定可见性?RC 与 RR 差别在哪? - HOT(Heap-Only Tuple)是什么?它如何缓解更新带来的索引膨胀?
- 死元组为什么会让表越来越大?autovacuum 怎么自动清理?
一、整体架构:一个 postmaster 带一群后端进程
PostgreSQL 是多进程结构(不是多线程),所有进程通过一块共享内存通信。
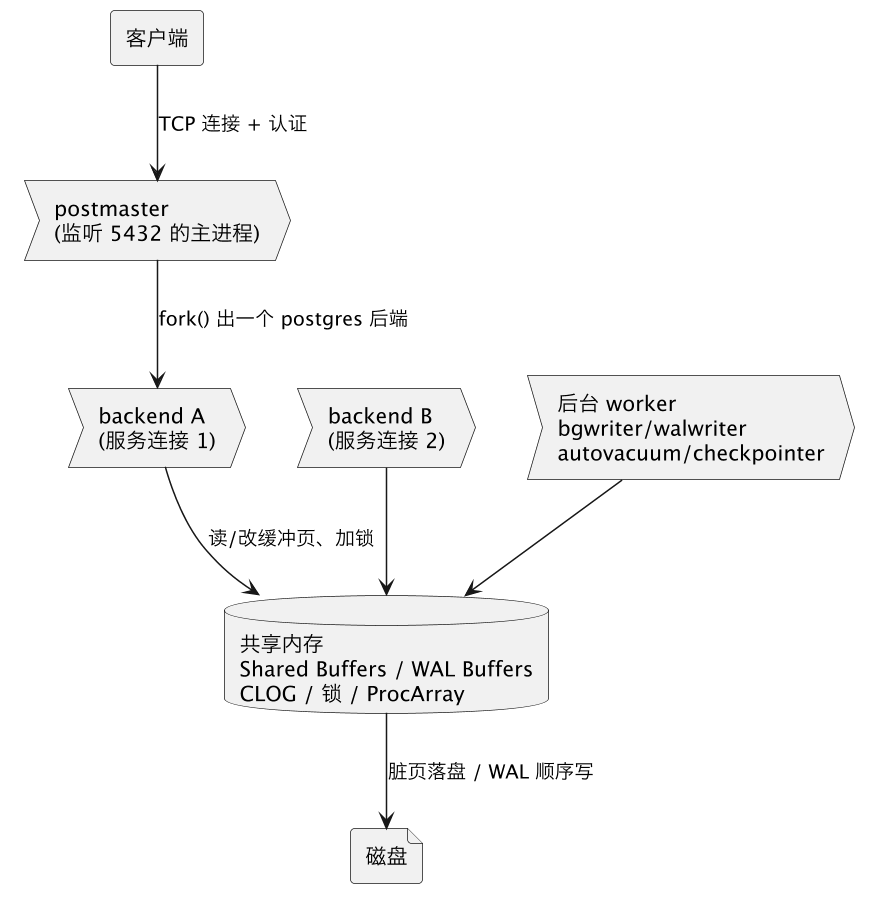
关键角色:
| 进程/区域 | 职责 | 与 MySQL 的对应物 |
|---|---|---|
| postmaster | 监听端口、认证、为每个连接 fork() 后端 | mysqld 监听线程 |
| backend(postgres 进程) | 一条连接独占一个进程,解析/优化/执行 | 一个连接一个线程 |
| Shared Buffers | 缓存表/索引的 8KB 页 | InnoDB Buffer Pool |
| bgwriter | 把脏页提前刷盘,减轻 checkpoint 压力 | page cleaner |
| walwriter | 周期性把 WAL buffer 落盘 | log writer |
| checkpointer | 到点把脏页刷盘 | checkpoint 线程 |
| autovacuum | 回收死元组、冻结老事务号 | InnoDB 无对应(undo purge 近似) |
第一个坑:连接即进程。 每个后端进程都能吃到 5~10MB 内存,进程调度也比线程重。PostgreSQL 不适合让应用直接开几千条长连接,必须在前面放连接复用器,见 PgBouncer 事务级复用。
# 观察:每条连接 = 一个 postgres 进程
ps -eo pid,ppid,rss,cmd | grep '[p]ostgres'
#  1024    1  ... postgres -D .../16/main
#  2001 1024  ... postgres: app_user app_db 10.0.0.21(51022) idle
#  2002 1024  ... postgres: app_user app_db 10.0.0.22(51030) SELECT
#  1100 1024  ... postgres: checkpointer
#  1107 1024  ... postgres: autovacuum launcher
二、多版本并发控制:UPDATE 不是改,是「插新留旧」
堆表(heap)是一堆 8KB 的页,页里放的是元组(tuple)的多个版本。每个版本头带两个系统列:
xmin:插入该版本的事务号(XID)。xmax:删除/更新该版本的事务号;未删除时为 0。更新在物理上等于「旧版本写 xmax 标记删除 + 插入新版本」。
CREATE TABLE acct(id int PRIMARY KEY, bal int);
INSERT INTO acct VALUES (1, 100);

SELECT xmin, xmax, id, bal FROM acct;
--   xmin  | xmax | id | bal
-- --------+------+----+-----
--  500120 |    0 |  1 | 100

BEGIN;
UPDATE acct SET bal = 300 WHERE id = 1;
SELECT xmin, xmax, id, bal FROM acct;  -- 新版本 xmin=500121
COMMIT;
-- VACUUM 之前,用 pageinspect 能看到两条物理版本:
-- 旧版本 xmin=500120,xmax=500121(死元组);新版本 xmin=500121,xmax=0
由此得到三个直接后果:
- 读不阻塞写、写不阻塞读。 读者按快照挑一个对自己可见的版本,永不读未提交行,也不给读加锁;写者只锁正在改的那一行。
- 回滚几乎免费。 事务没提交,它插入的版本对别人天然不可见,VACUUM 稍后清掉;不像 InnoDB 要靠 undo log 反向还原。
- 更新留下死元组,表会膨胀。 这是 PostgreSQL 运维头号日常,治理见 VACUUM 与表膨胀治理。
对比 InnoDB:数据页原地更新,旧版本放 undo 段,读旧版本沿回滚指针去 undo 拼装;PostgreSQL 旧版本就在堆表里。前者表本身不膨胀但 undo 可能膨胀,后者表/索引会膨胀——两套设计各自的代价。
三、快照可见性:一条元组能不能被看见
事务在某一刻拍一张快照,含三个字段:
| 快照字段 | 含义 |
|---|---|
xmin | 拍快照时活跃事务中最小的 XID(OldestXmin) |
xmax | 下一个将要分配的 XID 上界 |
xip | 拍快照时仍在进行(in-progress)的事务 XID 列表 |
版本插入事务 X=xmin 的可见性可概括为:
1. X 已 abort,或 X 在 xip 列表里(拍快照时还没提交) -> 不可见
2. X < 快照.xmin(在 OldestXmin 之前已提交)          -> 可见
3. X >= 快照.xmax(快照之后才开始的事务)             -> 不可见
4. 介于二者之间:查 CLOG 提交位,已提交才可见
xmax 再做一层对称判断:若删它的事务对当前快照已提交,旧版本不可见,应看新版本。
RC 与 RR 的差别只在「何时拍快照」
| 隔离级别 | 快照时机 | 后果 |
|---|---|---|
| Read Committed(默认) | 每条语句重拍快照 | 同事务两次 SELECT 可能读到不同结果 |
| Repeatable Read | 事务首条语句拍一次,全程复用 | 同一视角;更新冲突报 could not serialize access |
| Serializable | 快照隔离 + 谓词锁检测危险结构 | 防写偏差,冲突报 40001,需应用重试 |
-- RC 验证:会话 A
BEGIN;                              -- 默认 RC
SELECT bal FROM acct WHERE id=1;   -- 100
-- 会话 B:UPDATE ...=300; COMMIT;
SELECT bal FROM acct WHERE id=1;   -- 300  ← 读到新值
COMMIT;
-- RR 验证
BEGIN ISOLATION LEVEL REPEATABLE READ;
SELECT bal FROM acct WHERE id=1;   -- 100
-- 会话 B 改 300 提交
SELECT bal FROM acct WHERE id=1;   -- 100  ← 仍是事务开始时快照
COMMIT;
第二个坑:别拿 MySQL 的 RR 经验套 PostgreSQL。 InnoDB 的 RR 靠间隙锁防幻读、锁味重;PostgreSQL 的 RR 是纯快照、无间隙锁,普通 SELECT 完全无锁,但不防写偏差(write skew),要强一致用 Serializable 并在代码里重试 40001/40P01。
四、HOT:尽量别让一次 UPDATE 污染索引
若每次更新都插新版本、表上又有 5 个索引,索引代价极大。**HOT(Heap-Only Tuple)**优化:
- 更新不改任何被索引列、且新老版本在同一堆页放得下时,新版本不进索引。
- 旧版本在页内用
t_ctid串成 HOT 链,索引项仍指链头,顺链找到最新可见版本。
索引项 (id=1) ──► 页内 HOT 链头 ──► 旧版本(xmax) ──► 新版本(t_ctid)
                  (不新增索引项,省一次索引写、减少索引膨胀)
提升 HOT 比例:① 频繁更新的列别建索引(改到索引列 HOT 失效);② 调小 fillfactor(默认 100,热点表设 80~90)给页留空间。
ALTER TABLE hot_table SET (fillfactor = 85);
VACUUM (FULL) hot_table;   -- 重建使 fillfactor 生效(锁表,低峰做);线上建议 pg_repack

SELECT relname, n_tup_upd, n_tup_hot_upd,
       round(100.0*n_tup_hot_upd/NULLIF(n_tup_upd,0),1) AS hot_pct
FROM pg_stat_user_tables
WHERE n_tup_upd > 0 ORDER BY hot_pct ASC;  -- HOT% 低的表优先调
五、事务号回卷与冻结:MVCC 的隐藏账单
XID 是 32 位,约 42 亿回卷。PostgreSQL 规定「相差超 20 亿」的事务号比较时当作「在过去」。为避免很老的元组突然变成「未来事务」而消失,必须把它们的 xmin 标成永久状态 frozen(FrozenXID 恒为最老)。
- 普通 VACUUM 顺手冻结够老的元组(
vacuum_freeze_min_age控制)。 age(relfrozenxid)逼近autovacuum_freeze_max_age(默认 2 亿)时,强制触发反回卷 autovacuum,即使该表autovacuum_enabled=false。- 若让某表 age 冲到约 20 亿,库会进入只读保护强制停写——必须监控的红线。
-- 回卷风险 Top 表
SELECT relname, age(relfrozenxid) AS xid_age,
       pg_size_pretty(pg_total_relation_size(relid)) AS total
FROM pg_class WHERE relkind IN ('r','t')
ORDER BY age(relfrozenxid) DESC LIMIT 10;
六、autovacuum:让多版本机制自转起来
死元组无限堆积会让表膨胀、扫描变慢、索引变胖。autovacuum 负责清理死元组(空间标记可复用)与冻结老元组。
SELECT name, setting FROM pg_settings
WHERE name IN ('autovacuum_vacuum_threshold','autovacuum_vacuum_scale_factor',
               'autovacuum_analyze_scale_factor','autovacuum_vacuum_cost_limit',
'autovacuum_naptime') ORDER BY name;| 参数 | 默认 | 工程建议 |
|---|---|---|
autovacuum_vacuum_scale_factor | 0.2(死元组达 20% 才清) | 大表调低到 0.02~0.05,更勤更轻 |
autovacuum_analyze_scale_factor | 0.1 | 大表调低,统计信息更新更快 |
autovacuum_vacuum_cost_limit | 200(shared 2000) | IO 富余时调高加快清理 |
autovacuum_naptime | 60s | 库多表多时调到 10~30s |
第三个坑:默认 20% 阈值对大表是灾难。 10 亿行的表要积 2 亿死元组才触发,期间表已严重膨胀、统计信息陈旧导致优化器选错计划。应对大表单独调小:
ALTER TABLE big_orders SET (
  autovacuum_vacuum_scale_factor = 0.03,
  autovacuum_analyze_scale_factor = 0.02,
  autovacuum_vacuum_cost_limit = 2000
);
七、相关与延伸
本篇建立架构与多版本地基:旧版本如何回收见 VACUUM 与表膨胀治理;MVCC 依赖的预写日志见 WAL 与 checkpoint 调优;执行计划见 EXPLAIN (ANALYZE, BUFFERS);连接模型应对见 PgBouncer 事务级复用。对照 InnoDB 的多版本与加锁读 MySQL 锁与事务,两种 MVCC 取舍一目了然。
总结
PostgreSQL 架构与 MVCC:多进程 + 共享内存,一条连接一个 backend(故需 PgBouncer);堆表多版本以 xmin/xmax 标记,靠快照 xmin/xmax/xip 判可见性,读不阻塞写、回滚近乎免费,代价是死元组留在表里——用 HOT(不改索引列、配合 fillfactor)减少新版本进索引,用 autovacuum 回收死元组并冻结老 XID 防回卷;RR 是纯快照无间隙锁,Serializable 才防写偏差且需重试。