PostgreSQL WAL 与 checkpoint 调优:redo、刷盘与 IO 尖刺
更新时间:2026-09-18。WAL(Write-Ahead Log,预写日志)是 PostgreSQL 持久性和崩溃恢复的基石,也直接决定写入吞吐和复制行为。MySQL 背景读者可对照 MySQL redo/undo log 与崩溃恢复。多版本与日志如何配合,先读 架构与 MVCC;WAL 清理与复制槽、VACUUM 的耦合见 VACUUM 与表膨胀治理。
本文要回答的问题
- 为什么要「先写日志」?WAL 记了什么,LSN 是什么?
- 一次 COMMIT 何时算成功?
synchronous_commit与wal_sync_method如何影响安全/性能? - checkpoint 做什么、由什么触发?太勤为什么有 IO 尖刺?
- 全页写(full_page_writes)为什么放大 WAL?
- 复制槽为什么会让 WAL 堆积撑爆磁盘?崩溃恢复时间由什么决定?
一、WAL:先日志、后数据页
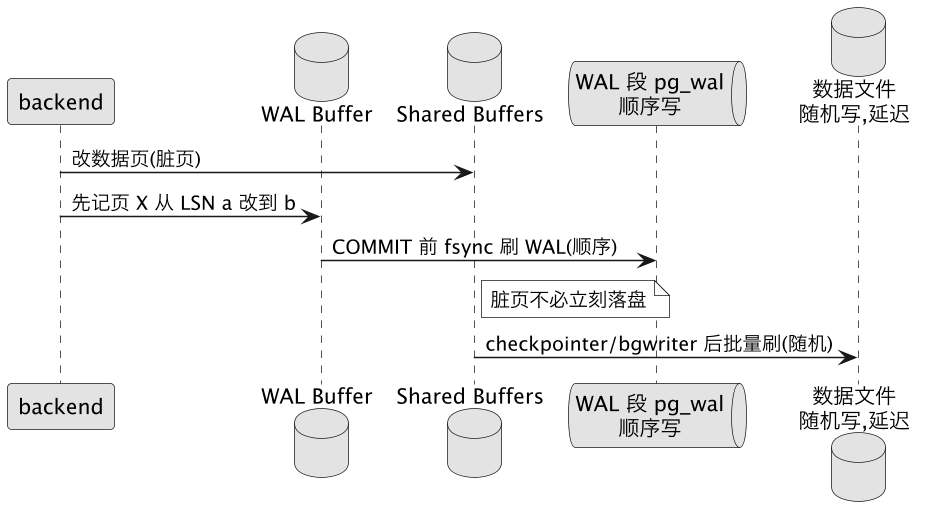
不变式:数据页落盘前,描述它的 WAL 必须已持久化。 掉电时从最后 checkpoint 重放 WAL(redo)恢复到一致状态。LSN(Log Sequence Number)是 WAL 字节偏移,单调递增;数据页头记 pd_lsn,redo 时比对决定是否重放。WAL 顺序追加、数据页随机刷,是「日志先行」提升吞吐的物理原因。
二、提交持久性:fsync 与 synchronous_commit
SELECT name, setting FROM pg_settings
WHERE name IN ('fsync','wal_sync_method','synchronous_commit','wal_buffers','wal_compression');| 参数 | 含义 | 取舍 |
|---|---|---|
fsync=on | 真正 flush 到盘 | 关掉掉电可能库损坏,生产绝不关 |
wal_sync_method | fsync/fdatasync/open_sync | Linux 多为 fdatasync,用 pg_test_fsync 实测 |
synchronous_commit | 提交是否等 WAL flush | on 最安全;off 崩溃最多丢约 wal_writer_delay 窗口 |
wal_buffers | WAL 内存缓冲 | 默认 -1 自动=shared_buffers/32 |
高并发下多个提交攒一批一次 fsync,叫组提交,摊薄单次落盘成本。
坑一:synchronous_commit=off ≠ fsync=off。 前者只是提交不等落盘(最多丢极短窗口事务、库不损坏),后者掉电可能整库损坏。只对「可丢一小段」的写入按事务放宽前者:
SET LOCAL synchronous_commit = off;
INSERT INTO ingest_log(...) VALUES (...);
三、checkpoint:把恢复起点往前推
checkpoint 记录一个 WAL redo 起点、把此前脏页逐步刷盘,其后旧 WAL 才可回收(仍受归档/复制槽约束)。触发条件:周期 checkpoint_timeout(默认 5min)、WAL 量超 max_wal_size(默认 1GB)、手动 CHECKPOINT/停库/基础备份。
坑二:checkpoint 太勤 → IO 尖刺 + 全页写放大。 默认 1GB 对写密集库太小,可能几分钟触发一次,结束前集中刷脏页,磁盘 util 100%、查询延迟整体抬高。调法:调大 max_wal_size(4~16GB)与 checkpoint_timeout(15~30min),并把 checkpoint_completion_target 设高(PG13+ 默认 0.9),让脏页均匀摊在周期内刷。
# postgresql.conf 示例(按磁盘与 RTO 预算定,非银弹)
max_wal_size = 8GB
min_wal_size = 2GB
checkpoint_timeout = 15min
checkpoint_completion_target = 0.9
wal_buffers = 16MBSELECT checkpoints_timed, checkpoints_req,
checkpoint_write_time, checkpoint_sync_time
FROM pg_stat_bgwriter;
-- checkpoints_req 长期偏高 = 常被 WAL 量逼着提前 checkpoint,应调大 max_wal_size四、全页写:WAL 为什么会突然变大
full_page_writes=on(默认建议开)时,checkpoint 后某页第一次被改,WAL 记录整个 8KB 页而非行变化,防止掉电时的「部分页写/撕裂页」让行级 redo 无法重建。代价是 checkpoint 后出现一轮「整页风暴」放大 WAL。普通 ext4/SSD 不要关(只有存储保证原子写才可考虑);缓解手段是别让 checkpoint 太频繁,并开 wal_compression=on 压缩整页镜像。
五、WAL 保留、归档与复制槽:磁盘隐形杀手
只要还有人「需要」某段 WAL 就不能删:崩溃恢复(到上一 checkpoint)、持续归档(PITR,archive_command 失败会堆积)、流复制备库与复制槽。
-- 各复制槽保留了多少 WAL(最常见爆盘来源)
SELECT slot_name, active, restart_lsn,
  pg_size_pretty(pg_wal_lsn_diff(pg_current_wal_lsn(), restart_lsn)) AS retained_wal
FROM pg_replication_slots;

-- 归档是否卡住(failed>0 / last_archived_time 停滞立刻查 archive_command)
SELECT * FROM pg_stat_archiver;# 操作系统侧看 WAL 目录体量
du -sh "$PGDATA/pg_wal"坑三:失活复制槽会无限保留 WAL。 备库下线但槽还在,restart_lsn 不前进,主库 WAL 只增不减直到写满停库;hot_standby_feedback=on 时备库还回传旧 xmin 抑制主库 VACUUM(见 VACUUM 治理)。必须监控槽 retained_wal、及时 pg_drop_replication_slot 清理失效槽,并保证 archive_command 始终成功且有告警。
六、崩溃恢复 RTO 的平衡
重启恢复要重放最后一个 checkpoint 之后的所有 WAL:checkpoint 越稀疏、max_wal_size 越大,崩溃后重放越多、启动越慢。调优是一组权衡:
| 目标 | 做法 | 代价 |
|---|---|---|
| 写吞吐高、延迟平滑 | 大 max_wal_size/timeout、completion_target 0.9 | 崩溃恢复慢、WAL 占空间 |
| 崩溃恢复快 | 更勤 checkpoint | IO 尖刺、全页写放大 |
| 不丢已提交事务 | fsync=on、synchronous_commit=on | 提交延迟含 fsync |
| 批量导入快 | 临时放宽提交、开 wal_compression | 视持久性要求 |
经验:把 checkpoint 摊平到 0.9,max_wal_size 给到「峰值半小时写不满」的量级,再用崩溃恢复演练验证 RTO,而不是盲目追大。
七、相关与延伸
MySQL 对应机制见 MySQL redo/undo log 与崩溃恢复;多版本与后台进程见 架构与 MVCC;WAL 堆积与 VACUUM、复制槽的牵制见 VACUUM 与表膨胀治理;连接侧见 PgBouncer 事务级复用。
总结
PostgreSQL WAL 与 checkpoint:先 fsync 顺序 WAL、后批量刷随机数据页,崩溃时从最后 checkpoint 的 LSN 重放恢复;提交安全靠 fsync=on(绝不可关)与 synchronous_commit(可按事务放宽、最多丢极短窗口);checkpoint 太勤造成 IO 尖刺与全页写放大,应调大 max_wal_size/checkpoint_timeout、把 checkpoint_completion_target 设 0.9 摊平刷盘,用 checkpoints_req 判断是否被迫提前;务必监控复制槽 retained_wal 与归档积压,防止失活槽把 WAL 撑爆磁盘,并在写吞吐与崩溃恢复 RTO 间取平衡。