连接池调优:HikariCP 参数、连接数公式与连接泄漏排查
更新时间:2026-09-18。很多人把连接池当「越大越好」,结果池越大 P99 越差。连接池的本质是复用昂贵的数据库连接 + 把应用侧并发削到数据库能舒服处理的程度。本文讲清连接数公式、HikariCP 每个关键参数,以及最常见的
Connection is not available与连接泄漏排查。外置的 PostgreSQL 连接复用见 PgBouncer 事务级复用。
本文要回答的问题
- 为什么连接池不是越大越好?几百个连接为什么反而慢?
- 连接数公式
connections = ((core*2)+disk)是什么意思,怎么落地? - maximumPoolSize / minimumIdle / maxLifetime / idleTimeout 各自怎么设?
HikariPool-1 - Connection is not available, request timed out怎么排查?- 连接泄漏怎么发现?池和数据库
wait_timeout怎么配合?
一、为什么连接不是越多越好
数据库执行 SQL 真正吃的是 CPU、内存、IO,而不是「连接数」。连接只是会话上下文。连接过多会:① 每个连接在 DB 侧占内存(PG 一连接一进程更贵,见 架构与 MVCC);② 大量并发查询争用锁/latch/buffer pool,上下文切换飙升;③ 应用侧也要为每条在途请求分配线程与内存。
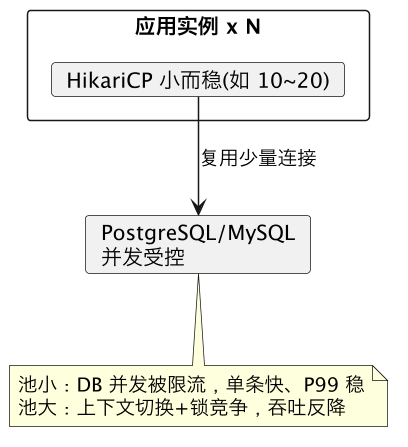
PostgreSQL 官方 wiki / HikariCP 作者都引用经典公式:
连接数 = ((CPU 核心数 * 2) + 有效磁盘数)它的含义不是教条数字,而是:在传统机械磁盘、一次请求基本只阻塞在一个 IO 的模型下,需要的活跃连接大约是核数的两倍加磁盘数。SSD/虚拟化环境取「核数×2」甚至更小。这是单个数据库实例、所有应用实例池大小之和的目标,不是每个实例都开这么大。4 核应用服务器、单库常见值就是每实例 10~20。
二、关键参数逐项
spring:
  datasource:
    hikari:
      maximum-pool-size: 15          # 池上限:公式 + 压测,宁可小
      minimum-idle: 15               # 固定为=max,避免频繁伸缩(推荐)
      connection-timeout: 3000       # 取连接最多等 3s,超时快速失败
      idle-timeout: 600000           # 空闲连接存活(仅 minimumIdle<max 时生效)
      max-lifetime: 1800000          # 连接最长寿命 30min,必须 < DB wait_timeout
      keepalive-time: 120000         # 周期性探活,防被中间设备静默断开
      connection-test-query: SELECT 1   # 新版驱动可省,用 JDBC4 isValid
leak-detection-threshold: 20000 # 连接借出超 20s 打泄漏告警栈| 参数 | 作用 | 建议 |
|---|---|---|
| maximumPoolSize | 连接上限 | 按公式+压测,小而稳 |
| minimumIdle | 空闲保活数 | 与 max 相等,固定池规模 |
| connectionTimeout | 借连接等待 | 1~5s,快速暴露问题而非堆积请求 |
| maxLifetime | 连接强制回收 | 小于 DB wait_timeout/负载均衡空闲超时(留 30s+ 余量) |
| idleTimeout | 空闲回收 | min=max 时基本不生效 |
| leakDetectionThreshold | 泄漏检测 | 生产设比最慢 SQL 略高(如 20~60s) |
三、为什么 maxLifetime 必须小于数据库超时
若连接在池里空闲超过 MySQL wait_timeout(默认 8 小时)或中间 LB/防火墙的静默断连时间,DB/网络已把它关掉,而池还以为可用,借出后第一条 SQL 报 Communications link failure / connection reset。让 Hikari 的 maxLifetime(如 30 分钟)主动早于对端回收,并配合 keepalive,就能把「死连接」在池内轮换掉,而不是交给业务请求踩中。再加一点随机抖动,避免大量连接同一时刻重建打爆数据库。
四、Connection is not available 排查
这条异常只有两类根因——池里连接全被占着没还,或建不出新连接:
- 慢查询/长事务占住连接。 借出后一条 SQL 跑几十秒,池很快耗尽。先查 DB:MySQL
SHOW PROCESSLIST、PGpg_stat_activity找长事务(idle in transaction),结合 EXPLAIN 优化慢 SQL。 - 连接泄漏:拿了没关。 没用 try-with-resources、手动事务里异常分支没 close。开
leakDetectionThreshold,日志会打印「借出连接却超时未还」的调用栈,直接定位代码。 - 池太小 / 突发流量。 先确认不是前两者,再压测决定是否调大;盲目调大只会把压力推给 DB。
- 建连失败。 网络、认证、达到 DB
max_connections、PgBouncer 连接上限;看启动与获取连接的原始异常。
// 正确:try-with-resources 保证连接归还
try (Connection c = dataSource.getConnection();
     PreparedStatement ps = c.prepareStatement("SELECT ...")) {
    try (ResultSet rs = ps.executeQuery()) { /* ... */ }
}
五、坑与对照
- 每实例各开一大池。 记住总数=实例数×池大小,多实例部署要按总量倒推每实例大小。
- minimumIdle 与 max 不等导致抖动。 流量波动时反复建连/销毁,推荐固定成相等。
- maxLifetime ≥ wait_timeout。 必然偶发拿到死连接;maxLifetime 要更短并加抖动。
- 把连接当线程级全局缓存。 连接必须方法级借还,禁止跨请求/长生命周期持有。
- PG 上盲目堆连接。 高并发应前置 PgBouncer 收敛后端连接,应用池 + PgBouncer 分层,见 PgBouncer。
连接数打满的数据库侧表现见
faq/connection-pool-size-how-to-set(FAQ 待补);事务与长事务锁见 MySQL 锁与事务。
总结
HikariCP 调优:连接池不是越大越好,活跃连接按 ((核数*2)+磁盘数) 起步并以压测为准(常见每实例 10~20),多实例要算总和,池过大反而因上下文切换和锁竞争降低吞吐;生产把 minimumIdle 设成与 maximumPoolSize 相等固定规模,maxLifetime 设为小于 DB wait_timeout/LB 空闲超时并加随机抖动防死连接,leakDetectionThreshold 抓未归还;Connection is not available 先查慢查询/长事务和连接泄漏(try-with-resources 必用),确认非前两者再谈调大,PostgreSQL 高并发前置 PgBouncer。