批量插入优化:多值 INSERT、INSERT...SELECT、LOAD DATA 与驱动重写
更新时间:2026-09-18。灌数据慢,九成是「一条一条插」:每条语句一次网络往返、一次事务日志、可能一次 fsync。批量写入优化的核心就一句——在正确的边界内,把多次小写入合并成少量大写入。本文对比多值 INSERT、INSERT...SELECT、LOAD DATA/COPY、以及 JDBC/驱动层的批量重写,并给出批次大小和冲突处理的工程值。前置:redo/undo log 与崩溃恢复。
本文要回答的问题
- 逐条 INSERT 慢在哪?网络、fsync、日志各自占多少?
- 多值 INSERT、
rewriteBatchedStatements、LOAD DATA 谁最快、差在哪? - MySQL 的
LOAD DATA INFILE和 PostgreSQL 的COPY怎么用、要注意什么? - 批次大小拍多少合适?太大会怎样?
- 批量写入遇唯一键冲突怎么办?自增锁、主从延迟有什么坑?
一、慢的根源:把「可合并的开销」重复了一万次
-- ❌ 每条自动提交:1 万次往返 + 1 万次刷盘
INSERT INTO t(a,b) VALUES(1,'x');
INSERT INTO t(a,b) VALUES(2,'y');

-- ✅ 多值 INSERT:一条语句
INSERT INTO t(a,b) VALUES(1,'x'),(2,'y'),(3,'z'), ... ;| 开销 | 逐条 autocommit | 批量单事务 |
|---|---|---|
| 网络往返 RTT | 每行 1 次 | 每批 1 次 |
| 事务提交/fsync | 每行 1 次 | 每批 1 次 |
| redo/binlog 刷盘 | 碎片化 | 顺序合并写 |
| 行锁/undo 管理 | 反复创建 | 一次持有 |
二、四种批量姿势与性能量级
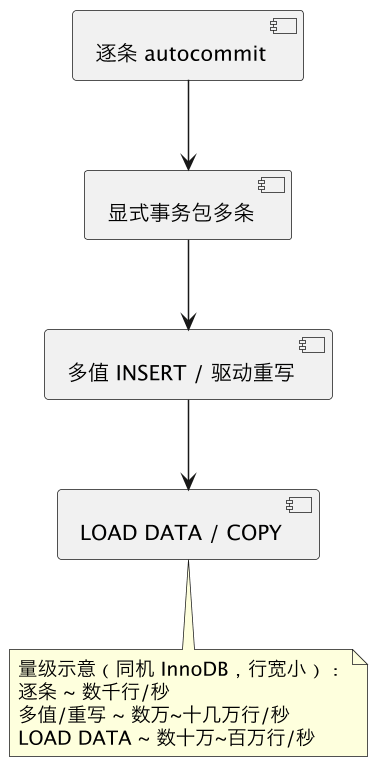
-- 1) INSERT...SELECT:表内/跨表搬运,不走应用
INSERT INTO order_archive(id, amount, created_at)
SELECT id, amount, created_at FROM orders
WHERE created_at < '2026-01-01';

-- 2) LOAD DATA INFILE:文件直灌,绕过大部分 SQL 解析
LOAD DATA LOCAL INFILE '/data/t.csv'
INTO TABLE t
FIELDS TERMINATED BY ',' OPTIONALLY ENCLOSED BY '"'
LINES TERMINATED BY '\n'
IGNORE 1 ROWS (a,b,c);
PostgreSQL 等价物是 COPY t FROM '/data/t.csv' WITH (FORMAT csv, HEADER),走批量管道,是 PG 最快的导入路径。
驱动层:MySQL JDBC 必须显式开启 rewriteBatchedStatements=true,addBatch/executeBatch 才会把多条 INSERT 重写成一条多值语句(否则只是循环发单条);PostgreSQL JDBC 用 reWriteBatchedInserts=true,或 CopyManager 走 COPY。
三、批次大小:不是越大越好
经验起点:
- 多值 INSERT:每批 500~2000 行(或单条 SQL 控制在 max_allowed_packet 之内)
- JDBC batch:executeBatch 每 1000 条提交一次
- 导入任务:观察 redo/undo 增长、主从延迟、锁等待动态调整
批次过大的代价:单条语句超出 max_allowed_packet 直接失败;长事务持锁久、undo 膨胀(MySQL 见 Buffer Pool 与 redo);主从单事务回放造成主从延迟尖刺;失败重放成本高。用「固定行数或固定字节数先到为准」切片。
四、冲突处理与可复现基准
-- MySQL:批量 upsert(依赖唯一键)
INSERT INTO t(id, name, ver) VALUES(1,'a',1),(2,'b',1)
ON DUPLICATE KEY UPDATE name=VALUES(name), ver=ver+1;
-- 或仅忽略冲突
INSERT IGNORE INTO t ...;

-- PostgreSQL
INSERT INTO t(id,name) VALUES(1,'a')
ON CONFLICT (id) DO UPDATE SET name=EXCLUDED.name;
简单基准(同机、关闭每提交 fsync 仅用于对比、生产勿关持久性):
SET GLOBAL innodb_flush_log_at_trx_commit=2; -- 仅基准环境
-- 分别用 逐条/多值1000/LOAD DATA 灌 100 万行,对比耗时
五、坑与对照
- 开了 batch 却没配重写参数。 MySQL JDBC 不配
rewriteBatchedStatements=true,executeBatch退化成逐条发送,是最常见的「以为批量了其实没有」。 - 批次撑爆包大小。 多值 INSERT 总行字节数必须小于
max_allowed_packet;宽表/长文本要按字节而非行数切片。 - 一个超大事务灌到底。 undo/binlog 膨胀、锁与主从延迟全部恶化;务必分批提交。
- LOAD DATA 的 LOCAL 与权限/安全。
local_infile、文件编码、换行符(Windows CRLF)、首行表头都要处理;LOCAL还涉及客户端文件读取权限。 - 自增锁与冲突空洞。 批量插入 + 唯一键冲突/回滚会消耗自增值留下空洞,属正常,不要依赖自增连续。
- 有外键/二级索引时变慢。 二级索引越多写放大越大;大批量导入可临时调大 buffer pool、对非关键索引先导后建。
导入产生的 redo/刷脏机制见 redo/undo log;把变更同步到其他存储见 CDC 数据同步;窗口式地对结果集再加工见 SQL 窗口函数。
总结
批量插入:逐条 autocommit 慢在每行一次往返和 fsync,优化按「显式事务→多值 INSERT/驱动重写→LOAD DATA/COPY」逐级提速;务必给 MySQL JDBC 开 rewriteBatchedStatements=true、PG 开 reWriteBatchedInserts 或用 COPY;批次按 500~2000 行/包大小切片提交,避免长事务 undo 膨胀与主从延迟;表内搬运用 INSERT...SELECT,冲突用 ON DUPLICATE KEY UPDATE/ON CONFLICT,LOAD DATA 注意 LOCAL 权限、编码、CRLF 与表头。