分库分表:垂直/水平拆分、分片键选择、扩容迁移与全局 ID
更新时间:2026-09-18。分库分表是单库容量/吞吐到顶后的手段,但它是「用复杂度换规模」:一旦分片,join、跨片事务、全局唯一、分页排序、扩容迁移全都变难。本文先讲清两种拆分和路由,再给出分片键选择、扩容与全局 ID 的工程做法,最后强调能靠索引、读写分离、归档、加机器解决就别急着分。前置:InnoDB Buffer Pool、MySQL 锁与事务。
本文要回答的问题
- 垂直拆分和水平拆分分别解决什么问题?
- 分片键怎么选?为什么「带分片键的查询」和「不带」天差地别?
- 哈希/范围/一致性哈希路由各有什么坑?扩容时怎么少迁移数据?
- 分片后全局唯一 ID 怎么生成?Snowflake 时钟回拨怎么办?
- 跨片 join、分页、聚合、事务的代价是什么?
一、两种拆分
垂直拆分(按业务/模块切)
  单库 -> 用户库 / 订单库 / 商品库
  解决:模块耦合、单库连接与 IO 争用、团队边界
  不解决:单张超大表(订单 10 亿行)

水平拆分(按数据行切,同构多张表/多个库)
  orders -> orders_0..orders_3 或 4 个库
  解决:单表容量、写吞吐、索引高度
  引入:路由、跨片、全局ID、扩容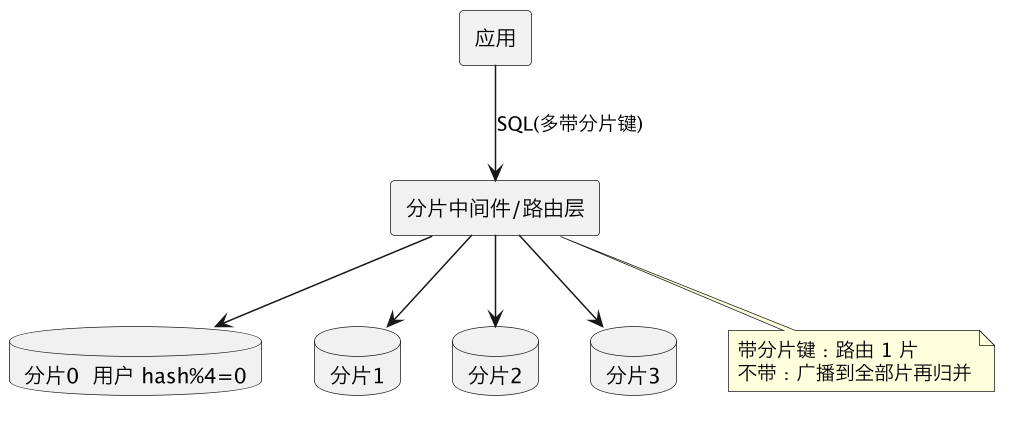
二、分片键:决定生死的一次选择
-- 分片键 user_id
-- ✅ 命中单片:路由到一个库
SELECT * FROM orders WHERE user_id=1001 AND id=?;
-- ❌ 广播:每个片都查,再在中间件内存里归并排序
SELECT * FROM orders WHERE status=1 ORDER BY created_at DESC LIMIT 20;
选择三原则:① 高基数、分布均匀,避免按低基数(如状态)分片造成热点;② 查询亲和,最高频的查询条件都带它(订单常按用户查,就用 user_id;常按商户查,就另建按商户的异构索引/冗余表);③ 尽量不变,分片键一旦变更要跨片搬迁。
| 路由方式 | 规则 | 优点 | 坑 |
|---|---|---|---|
| 取模/哈希 | hash(key)%N | 分布均匀 | 扩容 N 变化要迁移大量数据 |
| 范围 | 按区间 | 范围查询友好 | 易热点、新数据集中 |
| 一致性哈希/虚拟节点 | 环形映射 | 扩容迁移量小 | 实现复杂、查询路由表 |
| 基因法/预置库表 | 一开始就定 64 库×64 表逻辑分片,物理库逐步挂载 | 扩容只动映射 | 前期设计要足 |
工程主流是逻辑分片数固定(如 1024)、物理机按需扩容:路由 slot=hash%1024,slot 到物理库的映射可变,扩容时只迁移部分 slot,应用无感。
三、扩容与数据迁移
双写 + 对账 + 灰度切流是常用路径:① 新分片建好;② 旧数据按新规则回填;③ 开启双写(新老规则都写)或订阅 binlog 同步(见 CDC 数据同步);④ 全量+增量对账;⑤ 读流量灰度切新;⑥ 下线旧路由。全程保证可回滚。
四、全局唯一 ID
自增主键在多片会冲突,常用方案:
- Snowflake:
时间戳 + 机器号 + 序列号,趋势递增、本地生成性能高,问题是时钟回拨(详见 分布式 ID Snowflake)。 - 号段模式:DB/配置中心一次取一段(如 1000 个),应用内存分配,号段内连续、依赖中心化组件但压力小。
- UUID:全局唯一但无序,作为 InnoDB 聚簇主键会导致页分裂与索引膨胀,不建议做主键。
- 趋势递增的全局 ID 对 B+ 树插入友好,呼应 InnoDB 页结构 的顺序插入。
五、跨片代价与「别过早分」
| 操作 | 分片后 |
|---|---|
| 带分片键点查 | 单片,几乎无损 |
| 不带分片键查询 | 广播 + 内存归并 |
跨片分页 LIMIT 100000 | 每片取 100020 行归并,放大 N 倍(见 深分页) |
| 跨片 count/sum | 每片聚合再合并;count 好合并,distinct/avg 要小心 |
| 跨片 join | 禁止/广播表/冗余字段/异构索引 |
| 跨片事务 | 退化为分布式事务(见 分布式事务方案怎么选) |
拆分前先问:能不能加合适索引、冷热数据归档(把历史订单搬到归档库)、读写分离、升配/加盘?大多数「分库分表」诉求,归档 + 索引就能解决。真要分,优先单库分表,再考虑多库,中间件可用 ShardingSphere/Vitess 等,但要接受其对 SQL 的限制。
六、坑与对照
- 分片键只图均匀不顾查询。 均匀但高频 SQL 都不带它,等于每条查询全片广播。
- 用取模且不留扩容余量。
%4扩到%8近半数据要搬迁;优先固定逻辑分片数。 - 拿 UUID 当聚簇主键。 随机插入导致页分裂、索引碎片化,见 InnoDB 页结构。
- 忽视跨片分页和聚合。 深分页、distinct、全局排序在分片下成本陡增。
- 跨片强事务。 能避免就避免,用最终一致/本地消息表,见 Seata AT/TCC。
缓存层的水平分片(Redis Cluster 槽位)思路可对照 Redis Cluster 槽位。
总结
分库分表:垂直拆解决耦模块、水平拆解决单表容量与写吞吐,但分片键是生死决策——要高基数均匀、最高频查询都带、且尽量不变,否则查询退化为全片广播加内存归并;路由优先固定逻辑分片数+可变物理映射以便翻倍扩容少迁移,迁移走双写/CDC+对账+灰度切流;全局 ID 用趋势递增的 Snowflake 或号段而非无序 UUID;跨片 join/分页/事务代价高,能用索引、归档、读写分离解决就别过早分片。