数据库死锁实战:从死锁日志到加锁顺序
更新时间:2026-09-18。死锁不是数据库「坏了」,而是两个或多个事务互相持有对方想要的锁,形成等待环。InnoDB 有死锁检测器,会主动回滚代价最小的事务并报
Deadlock found。死锁无法 100% 避免,工程目标是:看懂日志 → 找到加锁顺序冲突 → 让所有事务按同一顺序加锁,并保证应用会重试。锁基础见 MySQL 锁与事务。
本文要回答的问题
- 死锁的四个必要条件是什么?InnoDB 怎么发现并解除死锁?
SHOW ENGINE INNODB STATUS的死锁段怎么读?谁持有什么、等什么?- RR 下的间隙锁/next-key lock 为什么会制造「看起来没冲突」的死锁?
- 唯一键、外键、二级索引会带来哪些隐性锁?
- 修复为什么是「统一加锁顺序 + 缩短事务 + 重试」?PostgreSQL 怎么查?
一、最小复现
CREATE TABLE dl(id INT PRIMARY KEY, v INT, KEY idx_v(v)) ENGINE=InnoDB;
INSERT INTO dl VALUES(1,10),(2,20),(5,50),(10,100);
-- 两个客户端,默认 REPEATABLE READ时刻 T1 T2
t1 BEGIN; UPDATE dl SET v=11
WHERE id=1; (持有 id=1 行锁)
t2 BEGIN; UPDATE dl SET v=21
WHERE id=2; (持有 id=2 行锁)
t3 UPDATE dl SET v=? WHERE id=2; -> 等待 T2 的 id=2
t4 UPDATE dl SET v=? WHERE id=1; -> 等待 T1
---- 等待环形成,InnoDB 检测到死锁,回滚其中一个 ----
ERROR 1213 (40001): Deadlock found when trying to get lock;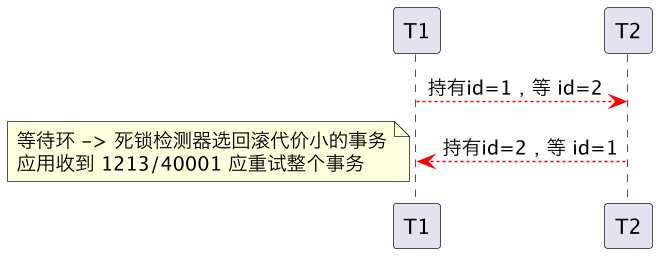
InnoDB 不会让它们永远等:锁等待图成环即判定死锁,回滚一个事务(释放其锁),另一个继续。InnoDB 用的是主动检测(也配 innodb_lock_wait_timeout 兜底,默认 50s)。
二、读死锁日志
SHOW ENGINE INNODB STATUS\G
-- 关注 LATEST DETECTED DEADLOCK 段*** (1) TRANSACTION:
TRX 9001 ACTIVE 3 sec starting index read
UPDATE dl SET v=11 WHERE id=2
*** (1) HOLDS THE LOCK(S):
RECORD LOCKS ... index PRIMARY ... record lock id=1 <- 它手里的
*** (1) WAITING FOR THIS LOCK:
RECORD LOCKS ... index PRIMARY ... record lock id=2 <- 它等的
*** (2) TRANSACTION:
UPDATE dl SET v=21 WHERE id=1
*** (2) HOLDS ... record lock id=2
*** (2) WAITING ... record lock id=1
*** WE ROLL BACK TRANSACTION (2) <- 被牺牲者读法三步:① 找到两个 TRANSACTION 各自执行的语句;② 看每个事务 HOLDS(持有)与 WAITING FOR(等待)的锁、落在哪个索引(PRIMARY 还是某个二级索引)、什么类型(record/gap/next-key);③ 环一旦闭合就是死锁,被 ROLL BACK 的事务由应用重试。
实时查锁等待(MySQL 8):
SELECT * FROM performance_schema.data_lock_waits;       -- 谁等谁
SELECT * FROM sys.innodb_lock_waits\G                   -- 更友好的视图
三、RR 下的隐性锁:间隙锁也能死锁
可重复读(RR)为防幻读,在范围/唯一检查时加 next-key lock(记录锁+前间隙锁)。两个事务即使操作「不同的、尚不存在的行」,也可能因争抢同一间隙而死锁——典型是并发插入相同唯一值:双方先在同一间隙加共享型间隙锁等待,插入时又都要把间隙锁升级为插入意向锁,互斥成环。
| 锁类型 | 锁什么 | 典型触发 |
|---|---|---|
| record lock | 单条索引记录 | 等值命中主键/唯一索引 |
| gap lock | 记录之间的间隙 | 范围扫描、防插入 |
| next-key lock | 记录+前间隙 | RR 下范围更新/删除默认 |
| insert intention lock | 插入前的意向间隙锁 | INSERT |
隐性锁来源:唯一索引冲突检查、外键约束检查、走了非唯一二级索引的 UPDATE/DELETE(先锁二级索引项再回表锁主键,等于加两趟锁,加锁顺序更易交叉)。
四、修复手段
- 统一加锁顺序(根治)。 让所有事务以固定顺序访问行/表,例如批量更新前先按主键排序:
UPDATE ... WHERE id IN (...) ORDER BY id,应用层也对要锁的 id 列表排序后再操作。环形等待是四要素里唯一能在应用层打破的。 - 缩短事务、减小锁范围。 把 RPC/外部调用、耗时计算移出事务;只在真正要改数据时开启事务并尽快提交,降低与别人重叠的时间窗。
- 让语句走精确索引。 用唯一/主键等值命中拿 record lock,避免大范围 next-key;
EXPLAIN确认没退化成全表扫(全表扫会给扫过的所有记录加锁,极易死锁)。 - 评估隔离级别。 业务允许时用 READ COMMITTED,间隙锁大幅减少(PG 默认 RC 且本就无间隙锁,见 PG vs MySQL)。
- 应用必须重试 1213/40001。 死锁是正常并发现象,捕获后带退避重试整个事务,而不是把错误抛给用户。
- 热点单行更新。 库存扣减等热点用乐观锁版本号/Redis 原子操作/队列串行化,减少 DB 行锁竞争。
PostgreSQL 排查:SELECT * FROM pg_locks WHERE NOT granted; 结合 pg_stat_activity 看阻塞关系;PG 的序列化失败 SQLSTATE 40001、死锁 40P01 同样要应用重试(见 架构与 MVCC)。
五、坑与对照
- 只看语句不看持锁/等锁。 同样的 SQL 因索引不同加锁范围天差地别,日志里的 index 和锁类型才是关键。
- 以为「我操作不同行不会死锁」。 间隙锁、唯一键冲突、二级索引回表都会产生你没意识到的锁。
- 全表更新。 没走索引导致锁全部扫描行,是死锁/锁等待大户。
- 事务里夹远程调用。 锁持有时间被外部延迟拉长,冲突概率暴涨。
- 不重试。 把偶发死锁当致命错误;正确做法是幂等前提下自动重试。
锁与 MVCC/隔离级别见 MySQL 锁与事务;连接被长事务占满见 HikariCP 调优。
总结
数据库死锁排查:死锁是多事务持锁互等成环,InnoDB 主动检测并回滚代价最小者、报 1213/40001,应用要幂等重试;排查用 SHOW ENGINE INNODB STATUS 的 LATEST DETECTED DEADLOCK 段,按「事务语句→HOLDS→WAITING→落在哪个索引/record 还是 gap/next-key」三步还原等待环;RR 下间隙锁、唯一键冲突检查、二级索引回表会制造看似无关的死锁;根治靠统一加锁顺序(按主键排序加锁)、缩短事务不夹 RPC、语句走精确索引避免全表加锁、必要时降到 RC,热点行用乐观锁/队列,PG 用 pg_locks 并对 40001/40P01 重试。