分布式 ID:Snowflake 位结构与时钟回拨处理
更新时间:2026-09-18。分库分表后,自增主键在多个分片间会冲突,于是需要全局唯一 ID。方案有 UUID、数据库号段、Snowflake 等;互联网业务最常用 Snowflake——本地生成、性能极高、整体趋势递增对数据库索引友好。它最大的工程风险是时钟回拨。本文把位结构、容量和回拨处理讲透。前置:分库分表、InnoDB 页结构。
本文要回答的问题
- UUID、数据库自增、号段、Snowflake 各适合什么场景?
- Snowflake 的 64 位是怎么切的?每毫秒能发多少、能用多少年?
- 为什么要求趋势递增?和 B+ 树页分裂有什么关系?
- 时钟回拨为什么危险?等待、切机器位、用历史时间分别怎么选?
- workerId 怎么分配?10 位机器号不够、容器频繁重建怎么办?
一、四种方案对比
| 方案 | 全局唯一 | 趋势有序 | 性能 | 依赖/坑 |
|---|---|---|---|---|
| DB 自增 | 单库唯一 | 严格递增 | 低、单点瓶颈 | 多片冲突、暴露量级 |
| 号段模式(Leaf-segment) | 是 | 近似递增 | 高 | 依赖中心化发号器 |
| UUID | 是 | 无序 | 极高 | 作主键致页分裂、索引膨胀 |
| Snowflake | 是 | 趋势递增(按时间) | 极高、本地发 | 时钟回拨、workerId 分配 |
二、Snowflake 的 64 位结构
 0 | 00000000 00000000 00000000 00000000 00000000 0 | 0000000000 00 | 000000000000
符号位(恒0)        41 位毫秒时间戳(相对纪元)        10位workerId   12位序列号

- 1 位符号:保证 ID 为正
- 41 位时间:相对自定义纪元的毫秒数,约 69.7 年
- 10 位机器:最多 1024 个 worker(常再拆 5 数据中心+5 节点)
- 12 位序列:同一毫秒内 0..4095,即单机 409.6 万 ID/秒
同毫秒靠序列号自增;序列号用尽则忙等到下一毫秒;时间往前走,所以 ID 整体趋势递增,作为 InnoDB 聚簇主键时新行基本追加在 B+ 树最右侧,避免随机插入的页分裂(对比无序 UUID,见 InnoDB 页结构)。
// 可运行的最小实现(Java,省略锁优化细节)
public class Snowflake {
  private final long workerId;
  private final long epoch = 1704067200000L;       // 自定义纪元 2024-01-01
  private long lastTs = -1L, seq = 0L;
  private static final long WORKER_BITS=10, SEQ_BITS=12;
  private static final long MAX_SEQ = (1L<<SEQ_BITS)-1;     // 4095
  private static final long WORKER_SHIFT=SEQ_BITS;          // 12
  private static final long TS_SHIFT=SEQ_BITS+WORKER_BITS;  // 22

  public Snowflake(long workerId){ this.workerId=workerId; }

  public synchronized long next(){
    long now=System.currentTimeMillis();
    if(now < lastTs) throw new IllegalStateException("clock moved back "+(lastTs-now)+"ms");
    if(now==lastTs){ seq=(seq+1)&MAX_SEQ; if(seq==0) now=waitNextMs(lastTs); }
    else seq=0L;
    lastTs=now;
    return ((now-epoch)<<TS_SHIFT) | (workerId<<WORKER_SHIFT) | seq;
  }
  private long waitNextMs(long last){ long t; do{t=System.currentTimeMillis();}while(t<=last); return t; }
}
三、核心坑:时钟回拨
NTP 校时、虚拟机/容器迁移、人工改钟都可能让墙上时钟往回跳。回拨后生成的「时间+序列」可能与回拨前已发出的 ID 撞号。处理策略分三档:
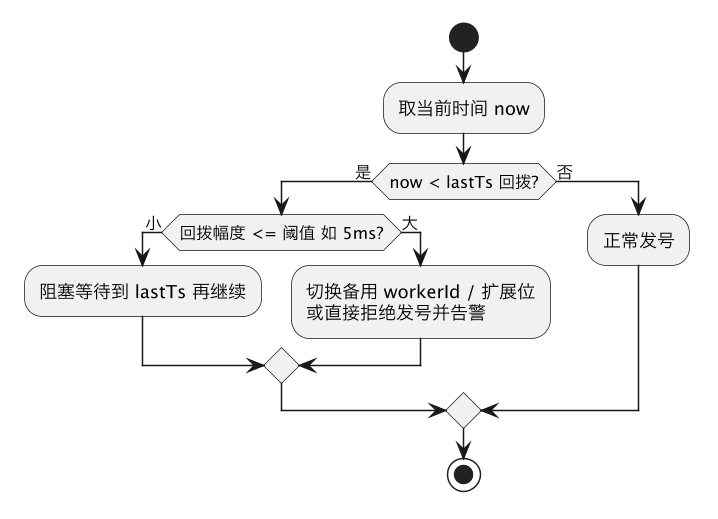
- 小幅回拨:等待。 自旋/睡眠直到
now >= lastTs,简单但回拨大时会卡住业务,必须设上限。 - 大幅回拨:拒绝 + 告警,或启用备用位。 百度 UidGenerator、美团 Leaf 等用「环形队列预分配」或「workerId 与时间位扩展」容忍更大回拨;激进做法借用额外位记录,牺牲部分机器/序列容量。
- 启动期回拨:用最近持久化时间。 把上次发号时间持久化(ZK/Redis/本地文件),重启后校验当前时间不得早于它,防止进程重启撞上旧钟。
生产建议:时间源用 chrony 平滑校时(避免 step 式大跳)、容器宿主机统一时钟、回拨超阈值直接抛错并接监控,而不是默默等待把线程池拖垮。
四、workerId 分配
10 位 1024 个节点常不够用或易冲突。常见做法:用 ZooKeeper/etcd/Redis 注册并租约分配 workerId(节点下线回收);K8s 用 StatefulSet 稳定序号或初始化时向协调者申请;或压缩 worker 位、引入「预留扩展位」。绝不要手工写死或用 IP 哈希(扩缩容后可能复用撞号)。
五、坑与对照
- 直接抛错 vs 无限等待。 小回拨等待、大回拨要快速失败,避免把请求线程全部阻塞。
- workerId 冲突。 两个节点同 workerId + 同毫秒序列必撞号;分配必须带租约与冲突检测。
- 纪元随便改。 上线后 epoch 不可变更,改了等于重置时间位导致结构重叠。
- 序列号耗尽忙等。 单机理论上限 409.6 万/秒,极端热点要考虑多 worker 或异步预生成。
- 前端精度问题。 ID 是 64 位长整型,JS Number 只安全表示到 2^53,返回给前端要用字符串,否则末位被舍入。
需要中心化、对有序性要求高可用 [号段];要绝对不要中心化就 Snowflake 并解决时钟与 workerId;无序场景才考虑 UUID。分片背景见 分库分表。
总结
分布式 ID Snowflake:用 1 位符号+41 位毫秒时间(约 69 年)+10 位 workerId(1024 节点)+12 位序列(单机 409.6 万/秒)组成 64 位 ID,本地发号、整体趋势递增,作 InnoDB 主键可顺序追加、避免 UUID 那种随机插入页分裂;最大风险是时钟回拨撞号——小幅阻塞等待、超阈值快速失败告警并配合 chrony 平滑校时,workerId 用 ZK/etcd 租约分配防冲突,长整型给前端务必转字符串。