InnoDB 页结构:数据页/索引页与页分裂
更新时间:2026-09-18。理解 InnoDB「页(Page,默认 16KB)」是理解索引、Buffer Pool、redo、页分裂的共同地基:磁盘 IO、内存缓存、redo 日志、B+ 树节点,全部以页为单位。本文讲清一个数据页内部怎么组织记录、聚簇/二级索引叶子里到底存什么,以及为什么主键要自增、随机插入为什么会页分裂。前置:MySQL 索引原理、InnoDB Buffer Pool。
本文要回答的问题
- 为什么页是 16KB?页、区(extent)、段(segment) 什么关系?
- 一个数据页内部有哪些区域?记录在页内怎么查找(为什么不是纯链表扫描)?
- 聚簇索引叶子和二级索引叶子分别存什么?什么是回表?
- 页分裂什么时候发生?为什么自增主键能避免,UUID 为什么糟糕?
- 页合并、填充因子、碎片怎么观测和治理?
一、为什么一切围绕「页」
磁盘按块、数据库按页:一次读写的最小单位是一个页,即使只查一行也要把它所在的整页加载进 Buffer Pool。默认页大小 16KB(innodb_page_size,建实例时定,常用 4/8/16/32/64K)。逻辑层次:
页 Page 16KB(IO/缓存/B+树节点/redo 的基本单位)
  └ 64 个连续页 = 区 extent(1MB,顺序空间分配)
       └ 多个区 = 段 segment(叶子段/非叶子段/回滚段…)
            └ 表空间 tablespace(ibd 文件)
以区为单位连续分配,是为了让范围扫描尽量顺序读;Buffer Pool 里每个缓存块也恰好放一页(见 Buffer Pool)。
二、数据页内部结构
+--------------------------------------------------+
| File Header / File Trailer   页号、校验和、前后页指针 |
|--------------------------------------------------|
| Page Header        记录数、空闲/已用空间、槽数等      |
|--------------------------------------------------|
| User Records       真实数据记录(单链表, 按键有序)     |
|                  ← 增长方向    增长方向 →            |
| Free Space         空闲空间(供插入)                  |
|--------------------------------------------------|
| PAGE Directory     槽(slot), 指向若干记录(稀疏索引)   |
|--------------------------------------------------|
| 行格式: 变长字段长度列表 | NULL标志位 | 记录头 | 列数据 |
+--------------------------------------------------+- 记录在物理上用 next_record 指针串成单链表,逻辑按键有序、物理位置可乱。
- 为避免在单链表里逐条找,页尾 PAGE Directory 维护若干「槽(slot)」,每个槽指向一组记录的最后一条。页内查找先在槽上二分定位到槽,再在槽覆盖的少量记录里沿链表精确定位——这是「页内二分」的由来。
- 记录头含
deleted_flag、next_record、记录类型;删除不立即搬走,只打标记并入垃圾链表(Garbage Space),空间可被后续插入复用。
三、聚簇索引叶子=整行,二级索引叶子=主键
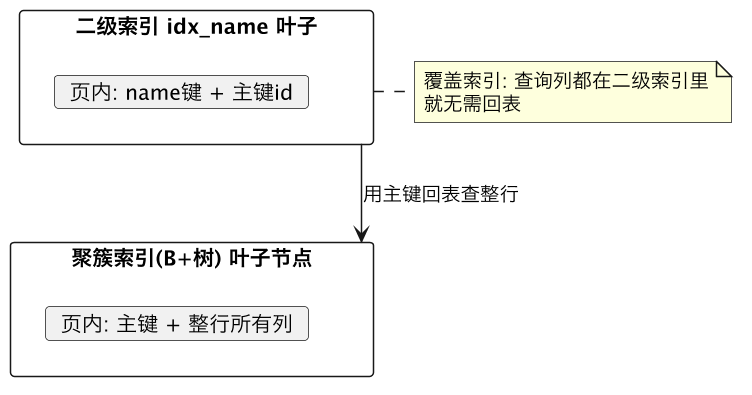
聚簇索引按主键组织,叶子页里就是完整行;二级索引叶子存「索引列 + 主键值」,查非索引列要拿主键再去聚簇索引查一次(回表,见 MySQL 索引原理)。B+ 树非叶子节点只存键+子页指针(约 1KB 量级),所以一个非叶子页能扇出上千子页,让 B+ 树非常矮胖(千万级行通常树高 3~4 层),点查只要 3~4 次页 IO,且大部分非叶子页常驻内存。
四、页分裂:随机插入的代价
页内记录必须按键逻辑有序。当一行新数据插入到一个已满页的中间位置时:
- InnoDB 申请一个新页;
- 把原页约一半记录移动/重链到新页(分裂);
- 在 B+ 树层加入新页指针,必要时非叶子节点也要分裂;
- 产生大量随机 IO、空间碎片,并写 redo。
顺序插入(自增主键): 总是追加到最后一页右侧 -> 基本不分裂, 页填得满(约15/16)
随机插入(UUID主键): 插入点散布到各页中间 -> 频繁分裂, 页只填约 1/2~2/3, 碎片化
这就是为什么 InnoDB 强烈建议用短的、单调递增的聚簇主键(自增 bigint、Snowflake 这类趋势递增 ID),而不是无序 UUID:顺序写让插入集中在最右侧热点页、页填充率高、范围/索引体积更优;UUID 让插入随机、页分裂频繁、缓冲与索引膨胀。二级索引的插入也类似,但其键非主键,无序度更高。
页合并(merge):删除/更新使页内记录低于阈值(约 MERGE_THRESHOLD,默认页大小的 50%)时,InnoDB 尝试把相邻页合并以回收空间;更新导致行变长无法原地放下时会先页内重排,仍放不下则分裂/迁移记录。
五、观测与治理
-- 表/索引的碎片化与统计
SHOW TABLE STATUS LIKE 'orders'\G          -- Data_free 等
SELECT * FROM information_schema.INNODB_SYS_TABLESPACES;
-- 重建表、整理碎片(5.6+ Online DDL,不阻塞读写大部分场景)
ALTER TABLE orders ENGINE=InnoDB;
OPTIMIZE TABLE orders;                     -- 实质是重建+分析
治理要点:① 主键短且递增,避免 UUID;② 控制行长(尤其大 VARCHAR/TEXT 溢出页),让单页放更多记录、树更矮;③ 高并发插入自增主键会有最右页热点,极端写场景可用分表/哈希分片打散(见 分库分表);④ 随机键导致碎片严重时再评估 OPTIMIZE(重建有成本,别在高峰期做)。
六、坑与对照
- 拿 UUID 当主键。 随机插入页分裂、填充率低、索引大、缓存命中差。
- 主键过长。 每个二级索引叶子都要冗余主键,主键越长二级索引越臃肿。
- 以为删除立刻释放磁盘。 只打删除标记、页可能不收缩,靠复用与 merge,文件不缩小时是表空间高水位(
Data_free)。 - 改大 innodb_page_size 就一定快。 大页利于顺序扫描与大行,但点查缓冲粒度变粗、浪费更多,要按负载选。
- 频繁变更长度致行迁移。 更新让行变长超出页容量会搬迁记录、产生分裂,字段设计要留余量。
页如何在内存被缓存与淘汰见 InnoDB Buffer Pool;页变更如何被 redo 保护见 redo/undo log 与崩溃恢复;二级索引写优化见 Change Buffer 与自适应哈希。
总结
InnoDB 页结构:一切以 16KB 页为 IO、缓存、B+ 树节点和 redo 的基本单位,64 页成区、区成段;数据页内记录用单链表按键有序串接、靠页尾 PAGE Directory 槽二分实现页内快速定位,删除只打标记留待复用;聚簇索引叶子存整行、二级索引叶子存索引列+主键(查别的列要回表),非叶子页只存键与指针使树矮胖;随机插入(UUID)会因保持有序而频繁页分裂并造成碎片和填充率下降,所以主键要短且趋势递增(自增/Snowflake),删除靠页合并回收、碎片用 OPTIMIZE/重建表治理。