InnoDB Change Buffer 与自适应哈希:写优化与读加速的边界
更新时间:2026-09-18。Change Buffer 和自适应哈希(AHI)是 InnoDB 的两个「自动优化器」:前者优化非唯一二级索引的写,后者优化频繁等值查询的读。它们大多数时候默默工作,但都有明确的适用边界,用错场景不仅没收益还会放大开销。本文把两者的触发条件、merge 时机和「什么时候该关」讲清。前置:InnoDB 页结构、Buffer Pool。
本文要回答的问题
- Change Buffer 到底缓存了什么?为什么能减少随机 IO?
- 为什么唯一索引用不了 Change Buffer?
- 哪些写操作会被 buffer(insert/delete-mark/purge),什么时候 merge 回页?
- 写多读少受益,写完立刻读为什么反而更慢?
- 自适应哈希 AHI 怎么自动建立?高并发下它为什么可能成为瓶颈、要不要关?
一、Change Buffer:把二级索引的随机写攒起来
更新/插入一条数据时,若涉及的二级索引页恰好不在 Buffer Pool,普通做法要先把该页从磁盘随机读进来再改。二级索引的插入点往往是随机的(不像聚簇主键那样顺序追加,见 页结构),随机读很多。
Change Buffer 的做法:对满足条件的变更,先不读目标页,只把「对这个索引项的修改」记在内存 Change Buffer(同时有持久化的 ibdata 部分),等以后该页被读到或后台线程工作时,再把缓存的变更 merge 到真正的索引页。一次 merge 可以合并对同一页的多次修改,把多次随机 IO 压成一次。
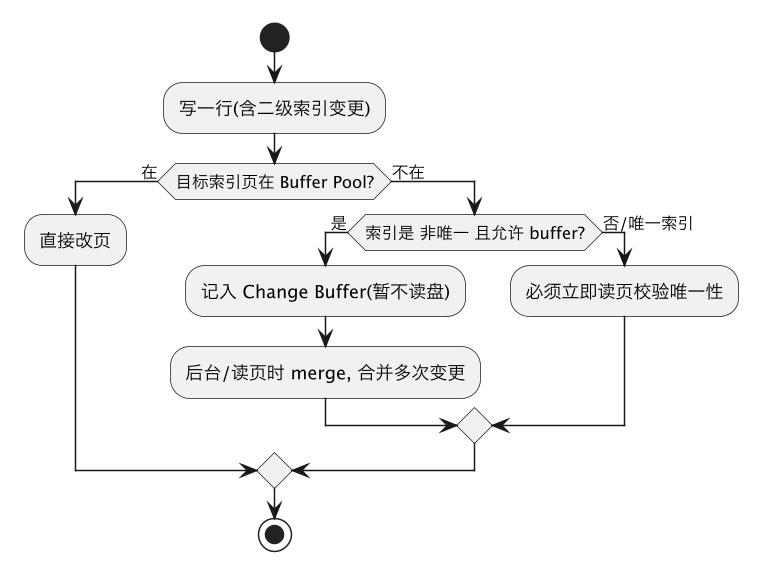
可 buffer 的操作由 innodb_change_buffering 控制:inserts(老名字 insert buffer)、deletes(delete mark)、changes(前两者)、purges(后台 purge)、all(默认)。innodb_change_buffer_max_size 默认占 Buffer Pool 的 25%。
二、为什么唯一索引用不了
唯一约束要求写入时立刻判断「是否已存在相同键」,这必须把目标索引页读进内存做检查,没法「先记下来以后再 merge」——否则无法当场拒绝重复值。所以:
| 条件 | 能否用 Change Buffer |
|---|---|
| 非唯一二级索引 | 能 |
| 唯一/主键索引 | 不能(必须立即读页校验) |
| 页已在 Buffer Pool | 无需 buffer,直接改 |
这也是主键之外,普通索引默认允许重复的一个隐性性能优势:写密集且二级索引多的表,非唯一索引写放大更低。
三、什么时候受益,什么时候帮倒忙
受益:写多读少、二级索引多、索引页随机分散(典型如流水/日志/账单表),变更在 buffer 里攒着,由后台或读取时一次性 merge,随机 IO 大减。
收益差甚至反效果:
- 写完立刻读同一批数据:刚 buffer 完马上又查该页,读操作触发立即 merge,省掉的随机读又被补回来,还要多维护一份 change buffer,纯属多此一举。
- 数据量小、索引页几乎常驻内存:本来就不用读盘,buffer 没有意义,还白占最多 25% Buffer Pool。
- 大量 change buffer 积压 + 崩溃恢复:merge 未完成会延长恢复;异常关机后首次访问也可能触发集中 merge 出现抖动。
merge 时机:该索引页被读入缓冲池(用户查询)、后台 master 线程按比例主动 merge、实例正常/崩溃恢复时、以及缓冲池空间压力下。观测:
SHOW ENGINE INNODB STATUS\G
-- INSERT BUFFER AND ADAPTIVE HASH INDEX 段:
-- size, free list len, seg size, merges, merged operations, hash searches/s
merged operations - insert/delete/purge 远大于 merges,说明每次 merge 摊到了很多变更,收益高;若 merges 频繁但每次合并很少,说明数据很快被读到,收益低。
四、自适应哈希索引(AHI):自动给热点页建哈希
InnoDB 监测到某些 B+ 树页被同一种等值模式反复访问(监控 SHOW ENGINE INNODB STATUS 里 hash searches/s 与 non-hash searches/s,命中率高即有益),会自动为这些索引项在内存建立哈希索引,让点查从「沿 B+ 树走 3~4 层」变成接近 O(1) 哈希查找,无需用户手动建。
普通点查: root -> 非叶子 -> 叶子  (3~4 次页定位)
AHI 命中: 哈希值 -> 记录 (近似 O(1))它是自动、内存、易失的,只缓存满足自适应条件的部分项,重启后重新观察构建,不占磁盘结构。
什么时候考虑关:AHI 的维护与查找用一把全局性质的锁(btr0sea 的读写锁与分片)。在高并发、访问模式高度离散、几乎不重复的负载下,多个线程频繁触发 AHI 分区锁竞争,维护哈希的成本超过命中收益,可能成为瓶颈。此时可 innodb_adaptive_hash_index=OFF 做 A/B 压测对比,而不是想当然开关——多数稳定 OLTP 等值查询场景它是正收益。
五、坑与对照
- 指望 Change Buffer 加速唯一索引写入。 唯一索引必须立即读页校验,用不了,别误判。
- 写完马上读还期待省 IO。 触发即时 merge,收益归零。
- Change Buffer 占满缓冲池。 小内存/读多写少时可调小
max_size甚至innodb_change_buffering=none,把内存让给数据页。 - 盲目关 AHI 或盲目信 AHI。 用压测和
hash searches命中率说话;离散高并发若怀疑锁竞争,再关了对比。 - 把 AHI 当用户哈希索引。 它自动且易失,不能替代你为特定查询建的普通/哈希索引。
缓冲池整体的 young/old LRU、刷脏与命中率见 InnoDB Buffer Pool;页为何随机插入见 InnoDB 页结构;写变更的崩溃保护见 redo/undo log。
总结
InnoDB Change Buffer 与 AHI:Change Buffer 在目标二级索引页不在内存时,先缓存对非唯一二级索引的 insert/delete/purge 变更、之后一次性 merge,从而把多次随机读压成一次,写多读少且索引分散最受益;唯一索引因必须立即读页校验唯一性而用不了,写完立刻读会触发即时 merge 使收益归零、小表常驻内存还白占默认 25% 缓冲池;AHI 则由 InnoDB 自动监测高频等值访问、在内存建近似 O(1) 的易失哈希加速点查,多数 OLTP 有益,但高并发表离散热点下其分区锁可能成瓶颈,要用命中率与压测 A/B 决定是否关闭。