CAP 与 BASE 理论及其工程边界
更新时间:2026-09-18。CAP 和 BASE 是分布式系统最常被引用、也最常被误解的两个词。「CAP 三选二」是个粗糙口号——它描述的是发生网络分区(P)的那一瞬间,你只能在一致性和可用性之间二选一,而不是平时要主动放弃 C 或 A。理解这一点,才能在注册中心、分布式事务、缓存、多副本数据库的选型上做对取舍。应用落地见 Seata AT/TCC 与本地消息表、分布式事务方案怎么选。
本文要回答的问题
- CAP 的 C/A/P 严格定义是什么?为什么说「没有分区时 CA 可以兼得」?
- CAP 的 C 和 ACID 的 C 是一回事吗?
- ZooKeeper/etcd 偏 CP、Eureka/Nacos 偏 AP,差别体现在哪?
- BASE 的「基本可用、软状态、最终一致」具体怎么落地?
- 最终一致不是摆烂,它需要哪些配套(复制、消息、对账、读修复)?
一、CAP 严格定义
C  Consistency 线性一致性(linearizability)
    读一定返回最新写入(或报错);所有节点在同一时刻看到相同数据
A  Availability 可用性
    每个非故障节点的请求都要在有限时间内返回非错误响应
P  Partition tolerance 分区容错
网络分区(节点间消息丢失/延迟/分裂)时系统仍要继续运作分布式系统中网络分区不可避免(交换机、GC 停顿、跨机房链路、拥塞都可能造成),所以 P 不是「选不选」,而是必须容忍。真正的取舍只在分区发生时:
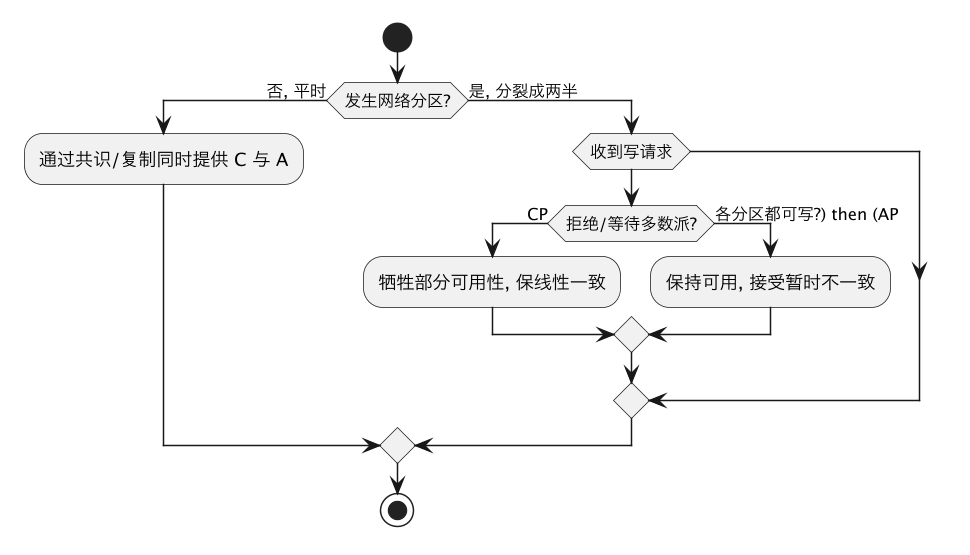
- CP:分区时少数派/无法确认全局最新的节点拒绝服务(返回错误或等待),保证不会读到/写入过期数据。典型:ZooKeeper、etcd(Raft 多数派),HBase、MongoDB(强一致配置)。
- AP:分区时各节点仍可读写,保证可用,代价是不同分区数据暂时分叉,恢复后再合并。典型:Eureka(注册信息各节点可不一致、宁可返回可能过期的实例列表也不拒服务)、Cassandra/Dynamo、DNS、CDN。
- 「CA 单机/传统数据库」是个常见误称:单机没有网络分区概念所以不适用 CAP;一旦是分布式系统就要面对 P。
两个 C 不是一回事:ACID 的 C 是「事务满足业务完整性约束」;CAP 的 C 是「多副本上的线性一致性」,讨论的是分布式复制语义,别混用。
二、CP 与 AP 的工程体现:以注册中心为例
| 场景 | 偏好 | 行为 |
|---|---|---|
| 选主、分布式锁、配置元数据、金融账户 | CP | 宁可在少数派时不可用,也不能两个主并存/读到旧余额 |
| 服务发现注册中心 | 多为 AP | 节点短暂拿到过期列表,可由客户端重试/熔断兜底,胜过整个调不到实例 |
| 电商商品/库存展示 | AP | 分区时允许旧数据,恢复后追平 |
Eureka 牺牲强一致换可用性:注册表在节点间异步复制,分区时各节点继续给出(可能不全/略旧)的服务列表,因为「服务发现暂时返回旧实例」可以被客户端负载均衡和 熔断降级 容忍;而 etcd/ZK 在拿不到多数派时拒绝写,避免脑裂产生两个 leader。Nacos 同时提供 AP(Distro,临时实例)与 CP(Raft,持久化实例)两种模式,按数据性质选。
三、BASE:在 AP 一侧把系统做「现实可用」
BASE 是对大规模互联网系统放弃强一致、追求高可用的实践总结:
BA  Basically Available 基本可用
    故障/高压时允许响应变慢、功能降级(如只读/排队/关闭推荐), 但核心仍可用
S   Soft State 软状态
    允许中间状态存在(主从延迟、处理中、支付中), 不要求全局瞬时一致
E   Eventually Consistent 最终一致
不再有新更新后, 各副本经过一段时间最终收敛到一致它不是「不保证一致」,而是接受短时间窗口的不一致,换取可用性和吞吐,并用机制保证收敛。
落地手段:
- 异步复制 + 读策略:主写从读,允许复制延迟;对强一致要求的读走主库或读法定人数(quorum,
R+W>N)。 - 消息驱动补偿:本地消息表/事务消息把跨服务动作异步化,失败重试,见 本地消息表与 Seata。
- 缓存失效/回填:Cache Aside 写库删缓存、订阅 binlog 补偿、TTL 兜底,见 缓存与数据库一致性。
- 版本/时间戳收敛:多端/多副本用向量时钟、最后写入胜(LWW)、版本号防止旧值覆盖新值。
- 读修复与反熵:读时发现副本旧了顺带修复(read repair),后台节点间比对同步(anti-entropy/Merkle 树)。
- 对账兜底:金融/订单类最终一致系统必须有周期性对账,把理论上不该残留的不一致人工/自动订正。
四、一致性谱系(不是非黑即白)
强(线性一致)  因果一致  读己之写  最终一致  弱一致
   ZK/etcd    会话/消息      主从+读主     异步MQ/缓存    尽力广播
读己之写(用户发完帖刷新要能看到自己的)、单调读(不要一会儿新一会儿旧)是比最终一致更强、常被业务需要的中间保证,可通过「写后短期读主」「按用户路由固定副本」实现。选型要回答的不是「C 还是 A」,而是:哪些数据/操作必须线性一致,哪些可以容忍多长的不一致窗口,窗口内如何兜底。
五、坑与对照
- 把 CAP 当日常三选二。 只有分区瞬间才被迫取舍,平时通过共识协议两者都能较好满足。
- 混用两个 C。 CAP 的 C 是线性一致,ACID 的 C 是约束一致。
- 注册中心无脑选 CP。 服务发现要的是可用性,CP 注册中心在选主/少数派时可能让整个调用链「找不到实例」。
- 上了最终一致却不建收敛机制。 没有重试、版本、对账,最终一致会退化成「永久不一致」。
- 对所有数据统一强一致。 把账户和信息流同等对待会平白损失可用性和性能,应按数据分级。
- 忽略不一致窗口内的产品体验。 软状态要有明确的「处理中」展示与超时回查,而不是让用户看到错乱数据。
服务在依赖故障时保持基本可用见 服务熔断、降级与隔离;缓存侧取舍见 缓存与数据库一致性;并发容量设计见 高并发系统设计:从容量评估到缓存异步。
总结
CAP 与 BASE:CAP 中 P(网络分区)在分布式系统里无法回避,真正的取舍只在分区发生的那一刻——CP(ZK/etcd/Raft、锁与账户)宁可拒绝少数派请求也要保线性一致,AP(Eureka、Cassandra、DNS、商品展示)宁可返回可能略旧的数据也要保持可用,平时不存在「主动二选一」,且 CAP 的 C 是线性一致、与 ACID 的 C 无关;BASE(基本可用、软状态、最终一致)是 AP 侧的工程化,靠异步复制与读策略、本地消息表重试、缓存失效+binlog 补偿、版本号防旧盖新、读修复/反熵和定期对账保证最终收敛;正确做法是按数据分级——核心资金走 CP/强一致,信息流走最终一致并把不一致窗口、处理中状态与对账兜底设计清楚。