N+1 冗余与故障转移:主备、双活怎么算容量
更新时间:2026-09-19。前置:高可用几个九。冗余不是「多买一台机器」这么简单,真正决定可用性的是「一台挂了,流量能不能在用户无感的情况下被剩下的接住」。这篇讲清冗余等级、两种主备架构和容量怎么算。
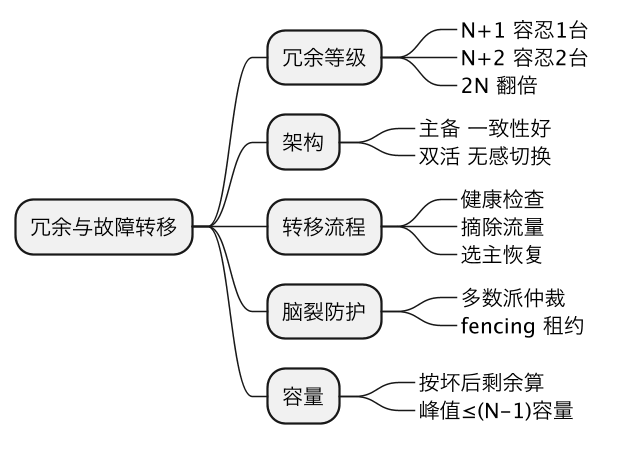
一、冗余等级:N+1 / N+2 / 2N
N   = 承载正常流量所需的最少实例数
N+1 = 多 1 台热备 → 允许同时坏 1 台
N+2 = 多 2 台    → 允许同时坏 2 台(常用于跨故障域)
2N = 完整翻倍(每台都有一份镜像),成本最高| 等级 | 容量开销 | 容忍故障 | 典型场景 |
|---|---|---|---|
| 无冗余(N) | 0 | 0 | 可随时重建的无状态批处理 |
| N+1 | +1/N | 1 台 | 最常见的在线服务集群 |
| N+2 | +2/N | 2 台 | 跨机房、发布期也要容错 |
| 2N | +100% | 整组 | 数据库主备、核心金融 |
N+1 是「够用」的起点,但要考虑维护期叠加故障:滚动发布时本来就有 1 台下线,此时再坏 1 台,N+1 集群就失去冗余。容量敏感的核心服务常用 N+2,或保证「发布期间仍维持 N+1」。
二、两种架构:主备 vs 双活
1)主备(active-passive / active-standby)
一台主对外服务,备机实时同步但不接流量;主故障时备提升为主。
- 优点:数据一致性好处理(只有一个写入点),成本低(备机可以规格低或冷备)。
- 缺点:切换有中断(秒~分钟级),备机平时「闲着」,切换逻辑(谁是主)容易出脑裂。
- 典型:MySQL 主从 + 哨兵切换、传统 VIP + keepalived。
2)双活/多活(active-active)
多个实例同时接流量、可同时写,前面挂负载均衡。
- 优点:无切换等待(坏一台 LB 直接摘除,用户无感),负载被分摊、机器都在干活。
- 缺点:写冲突、数据同步、会话保持都更复杂;无状态服务天然适合,有状态服务需要分布式协调。
- 典型:无状态 Web/API 集群(配合连接池)、Redis Cluster 多分片、跨地域多活。
三、故障转移怎么发生:检测 → 摘除 → 恢复
1. 健康检查(LB/sidecar 周期性探测 /healthz)
2. 连续 N 次失败 → 判定实例不健康
3. 从负载均衡池摘除(停止发新连接/请求)
4. 对有状态服务:提升备机 / 重新选主(哨兵/Raft)
5. 实例恢复并通过预热 → 重新加回池关键参数是健康检查的间隔与失败阈值,它们直接决定 MTTR:间隔 10s、3 次失败才摘,最坏要 30s 才切走流量。但阈值太松会把慢实例、网络抖动误判为故障造成抖动切换。常配合被动健康检查(真实请求失败计数)+ 主动探测双重信号。四层/七层负载均衡怎么转发见 L4/L7 负载均衡。
四、脑裂:主备最危险的失效
脑裂(split-brain)指网络分区后主备都认为对方死了、各自当主,于是出现两个写入点,数据分叉。防护手段:
- 仲裁(quorum/见证节点):必须获得多数派投票才能当主,Redis 哨兵、Raft、Paxos 都靠这个。
- fencing(隔离旧主):旧主即使没收到下线信号,也因拿不到分布式锁/存储租约而无法继续写。
- 冗余但独立的心跳链路:避免单条心跳网络故障触发误切换。
分布式锁与协调的底层见 Redis 分布式锁/Redlock。
五、容量怎么算:坏一台后还扛得住吗
冗余要按「故障发生后剩余节点的容量」来算,而不是平时平均利用率:
若集群 4 台(N=3 + 1 备),单台扛 10k QPS:
总容量 40k;坏 1 台后剩 30k。
→ 规划峰值流量必须 ≤ 30k(不是 40k),平时利用率上限 ≈ 30/40 = 75%
常见错误是把集群跑到 90% 利用率,结果一台挂掉,剩余节点被瞬时 120% 流量压垮,触发雪崩式连环故障——这正是舱壁隔离和服务熔断要兜的场景。规划时还要考虑故障实例是否优雅降级而非彻底断供,见降级与兜底。
坑
- 只数机器不做自动切换:备机要人工介入才顶上,MTTR 几十分钟,冗余名存实亡。
- 把集群跑到高利用率:一台故障后剩余节点超载,引发连锁雪崩。
- 主备共用一条心跳线:网络抖动即误判切换、甚至双主脑裂。
- 有状态双活忽略写冲突:多写点不做冲突解决会数据分叉。
- 备机规格缩水且从不演练:真切换时备机扛不住主的流量;冗余必须定期演练(见混沌演练)。
总结
N+1 表示在承载流量所需的 N 台之外多备一台以容忍单点故障,N+2/2N 提供更高保护但成本递增;无状态服务首选多实例 active-active 由负载均衡健康检查自动摘除实现近无感切换,有状态服务多用主备加多数派仲裁与 fencing 防脑裂;规划时必须按「坏掉一台后剩余节点的容量 ≥ 峰值流量」来定平时利用率上限(常见 60%~75%),并确保冗余跨独立故障域、备机同规格且定期演练,否则冗余在真正故障时接不住。