舱壁隔离与故障域:把故障关进一个舱里
更新时间:2026-09-19。名字来自造船:船舱用隔板分成多个水密隔舱,一个舱进水,船不会沉。软件里的**舱壁隔离(Bulkhead)**同理——把资源切成互不抢占的几份,一个功能泄漏/变慢,不会把整个进程的线程、连接、内存全吃光。它和优雅降级、熔断是过载防护三件套。
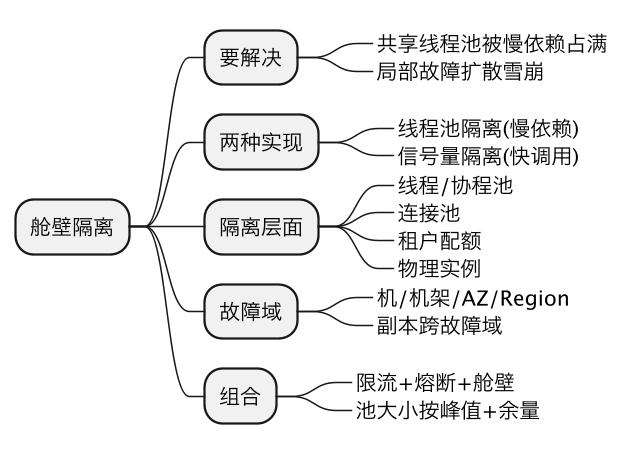
一、为什么需要隔离:资源是共享的「大舱」
典型反例:一个服务用同一个线程池 + 同一个连接池处理所有下游调用。某天推荐服务变慢,调用它的线程全部阻塞等待,线程被迅速占满:
共享线程池(200 线程)
├─ 调用推荐(变慢)→ 占住 150 个线程,全部 WAITING
├─ 调用订单(正常)→ 拿不到线程,排队
└─ 调用支付(正常)→ 也拿不到线程
结果:一个非核心依赖慢,拖垮整个进程的所有功能(雪崩)这就是服务雪崩在单进程内的微观成因。熔断器能阻止对烂依赖的调用,但如果所有调用已经共享并占满了线程池,熔断触发前资源可能已耗尽——舱壁从资源分配层提前隔离。
二、线程池隔离 vs 信号量隔离
| 维度 | 线程池隔离 | 信号量隔离(计数器) |
|---|---|---|
| 原理 | 每个依赖独立线程池+队列 | 一个原子计数器限制并发数 |
| 开销 | 线程上下文切换、队列缓冲 | 极轻,无额外线程 |
| 异步/超时 | 可异步、超时易实现(future.cancel) | 同步调用,超时靠底层 |
| 适用 | 慢依赖、需要排队和熔断配合 | 快调用、本地/近缓存、高 QPS |
| 典型实现 | Hystrix/Resilience4j Bulkhead、自研业务线程池 | Sentinel、Resilience4j SemaphoreBulkhead |
经验:对慢的、外部的、会阻塞的下游用独立线程池;对极快的内部方法用信号量限流即可,避免线程开销。
三、隔离的几个层面
1)线程/协程池隔离:按业务重要性或下游依赖分配独立池。下单、支付各有独立池且更小更稳,推荐、画像等非核心用另一个大池,互不抢占。
2)连接池隔离:数据库、Redis、各下游 HTTP 连接分开配置上限,避免一个慢查询占满全部 DB 连接。HikariCP 的池大小与连接数公式见连接池调优。
3)租户/接口/租户配额:多租户或多 API 共享服务时,给每个租户独立的并发/速率配额,防止一个大客户的突发把其他客户打挂(与限流叠加)。
4)实例与资源物理隔离:核心链路与离线任务分到不同节点群/节点池,避免批处理抢 CPU;关键服务独占数据库实例。
四、故障域(failure domain):隔离的物理边界
舱壁在单进程内隔离资源,故障域在基础设施层隔离共同失效的范围。划分原则是让冗余副本落在不同故障域:
故障域层级(域越大,同时失效的东西越多):
  进程/容器 → 物理机 → 机架(共享 ToR 交换机/PDU)→
可用区/AZ(共享机房供电制冷)→ 地域/Region(城市/电网)- 主备在同一台宿主机:宿主机挂,两份一起没(假冗余)。
- 同一机架:ToR 交换机或 PDU 故障同时带走。
- 同一可用区:机房断电/断网全灭,跨 AZ 部署才能扛机房级故障。
这正是N+1 冗余与高可用串并联中「冗余必须独立」的落地:副本跨故障域,并联可用性公式才成立。数据层跨域还涉及容灾 RTO/RPO。
五、隔离度怎么定:爆炸半径与利用率的权衡
隔离不是越细越好:
- 池太小 → 正常流量就排队、资源利用率低;
- 池太大 → 隔离意义弱,故障时仍能吃光资源。
- 建议按各依赖的峰值并发 + 余量分别定池大小,核心池预留更多;配合熔断(错误率超阈快速失败)和限流(入口总量),形成三道防线。
坑
- 所有下游共用一个大线程池:非核心慢依赖一打满,核心下单支付一起超时,这是最常见的雪崩源。
- 隔离池不设队列上限/超时:请求在独立池里无限排队,内存堆爆、延迟无限拉长,等于没隔离。
- 冗余在同一故障域:主备同宿主/同机架/同 AZ,共享电源交换机,一起失效。
- 池大小拍脑袋:不按峰值并发和下游容量算,要么频繁拒绝要么形同虚设。
- 隔离了线程却共享连接池:线程是分开了,全堵在同一个 DB 连接池上,瓶颈转移但没消除。
总结
舱壁隔离借鉴轮船水密隔舱,把线程池、连接池、并发配额按依赖和业务重要性切成互不抢占的资源单元,使一个慢依赖或一个大租户的故障只能耗尽自己那个舱、无法拖垮下单支付等核心链路;慢的外部调用用独立线程池、快的内部调用用轻量信号量,并让冗余副本跨进程、机架、可用区等不同故障域以真正缩小爆炸半径;池大小按峰值并发加余量设定,再与入口限流、依赖熔断和优雅降级组合成过载防护的完整防线。