高可用几个九:可用性百分比怎么换算成停机时间
更新时间:2026-09-19。「我们要做到四个九」是评审会上的高频词,但四个九到底意味着多久不能用、要花多大代价?这篇把可用性百分比、停机时间、串联合成和成本讲透。相关的冗余怎么做见 N+1 与故障转移,灾难恢复的 RTO/RPO 见容灾等级。
一、可用性的定义:MTBF 与 MTTR
可用性 A = 正常服务时间 / 总时间
= MTBF / (MTBF + MTTR)- MTBF(Mean Time Between Failures):两次故障之间的平均正常运行时间。
- MTTR(Mean Time To Repair/Recover):从故障到恢复服务的平均时间(含发现、定位、修复)。
注意提升可用性有两条路:拉长 MTBF(让它不容易坏),或缩短 MTTR(坏了能秒级切走)。分布式时代后者往往更重要——单机硬件 MTBF 很难再提高,但靠自动故障转移把 MTTR 压到几十秒,整体可用性就能上一个数量级。MTTR/MTBF 的概念辨析见 FAQ。
二、几个九对应的停机时间
| 可用性 | 俗称 | 每天允许停机 | 每月 | 每年 |
|---|---|---|---|---|
| 99% | 两个九 | 14.4 分钟 | 7.2 小时 | 3.65 天 |
| 99.5% | 两个半九 | 7.2 分钟 | 3.6 小时 | 1.83 天 |
| 99.9% | 三个九 | 86.4 秒 | 43.2 分钟 | 8.76 小时 |
| 99.95% | 三个半九 | 43.2 秒 | 21.6 分钟 | 4.38 小时 |
| 99.99% | 四个九 | 8.64 秒 | 4.32 分钟 | 52.6 分钟 |
| 99.999% | 五个九 | 0.86 秒 | 25.9 秒 | 5.26 分钟 |
每多一个九,允许停机时间缩小 10 倍,但成本通常不止 10 倍——从三个九到四个九,往往要跨机房多活、自动化一切人工操作、全链路冗余;四个九以上,连「计划内发布」都必须做到用户无感(灰度、热升级)。绝大多数互联网业务 99.9%~99.95% 是性价比最高的区间,五个九更多是电信级/金融核心的诉求。
三、计划内维护算不算停机
口径必须在 SLO 里写清(见 SLI/SLO 定义):
- 严格口径:只要用户请求失败就算,包括发布、机房切换。这倒逼发布工程做到无感。
- 宽松口径:约定维护窗口内不计入。代价是数据好看但用户确实受影响,容易自欺欺人。
现代实践倾向前者:用滚动发布、健康检查、流量摘除,让重启不产生失败请求,从而「计划内维护」也不烧错误预算。
四、串联与并联:系统整体可用性怎么算
串联(任一组件挂,全链路挂):  A总 = A1 × A2 × ... × An
并联(互为冗余,全挂才不可用):A总 = 1 - (1-A1)(1-A2)...(1-An)举例:一条链路由网关(99.9%)、服务(99.9%)、数据库主从(99.9%)串联,整体只有 0.999³ ≈ 99.7%(每年停机约 26 小时)——串联组件越多,可用性乘得越低,这就是为什么依赖要少、关键路径要短。
若数据库做成双活并联(两个 99.9% 副本,各自独立故障):并联可用性 = 1 − (0.001)² = 99.9999%。冗余把单点变成「同时坏才挂」,可用性指数级提升——但前提是两份副本真的独立(不同电源、交换机、故障域),否则一个机房断电同时带走两份,并联公式失效,这正是故障域隔离要解决的问题。
坑
- 只盯多堆机器不算可用性:若没做自动故障转移,机器挂了要人肉切,MTTR 几小时,再多冗余也上不了四个九。
- 串联组件遗漏:DNS、证书、配置中心、第三方支付都是串联依赖,任一抖动直接拉低整体。
- 把计划内维护剔除后自嗨:用户在发布期照样报错,对外可用性并不高。
- 假冗余:主备在同一机柜/同一可用区,共享电源和交换机,故障相关,并联公式不成立。
- 盲目追求五个九:成本指数上升而业务无感,应按错误预算选择够用的目标。
总结
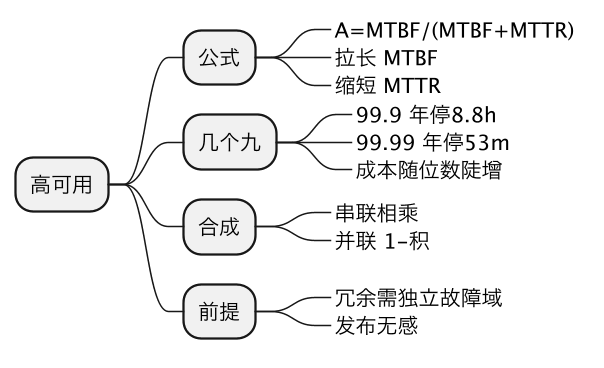
可用性 A=MTBF/(MTBF+MTTR),提升它既靠拉长无故障时间、更靠自动故障转移缩短恢复时间;99%、99.9%、99.99%、99.999% 分别对应每年约 3.65 天、8.8 小时、53 分钟、5 分钟的停机,每多一个九成本陡增一个数量级;串联系统可用性相乘(组件越多越低)、独立冗余的并联系统为 1 减各故障率乘积,并联收益以副本跨独立故障域、发布做到用户无感为前提,多数在线业务取 99.9%~99.95% 性价比最高。