Redis 主从复制与哨兵:PSYNC、异步复制与故障转移
更新时间:2026-09-18。单实例 Redis 有单点风险,主从复制提供数据冗余与读写分离,Sentinel(哨兵)在此之上提供自动故障检测与主从切换。前置:Redis 数据结构、RDB/AOF 持久化(全量同步要传 RDB);水平分片场景见 Redis Cluster 槽位。
本文要回答的问题
- 一个 replica 是怎么和 master 同步上的?全量 vs 部分重同步?
- 复制积压缓冲区(replication backlog)是什么?断线后什么情况下不必全量?
- 异步复制意味着什么故障窗口?WAIT 命令能解决吗?
- Sentinel 怎么判断 master 下线?谁来执行切换?
- 脑裂是什么?min-replicas 配置怎么降低旧主继续写入的风险?
- 客户端怎么感知主切换?
一、复制拓扑与建立过程
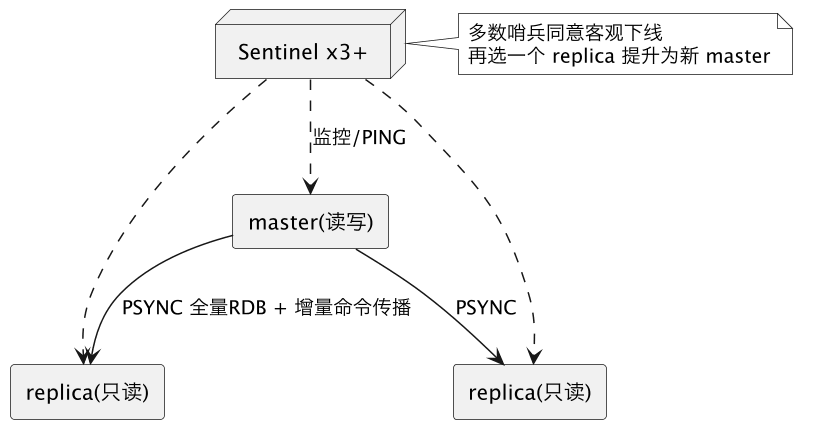
replica 用 REPLICAOF host port(旧版 SLAVEOF)加入:
# redis.conf
replicaof 10.0.0.11 6379
masterauth "your-password"
replica-read-only yes
首次同步(全量)流程:
1. replica -> PSYNC ? -1(不知道 master 的复制 ID/偏移)
2. master 判断需要全量:执行 BGSAVE 生成 RDB
3. master 把 RDB 发给 replica,replica 加载
4. 期间 master 的新写命令缓存在 client output buffer,RDB 发完后补发
5. 之后进入命令传播:master 每执行一条写,异步发给 replicas
坑一:全量同步是 master 的重负担。 BGSAVE fork+COW、传 RDB 吃带宽,replica 加载期间不可用;多个 replica 同时首次同步或频繁断线重连会把 master 拖垮。监控 master connected slaves、master_sync_in_progress、RDB fork 耗时。
二、PSYNC 与复制积压缓冲区:断线能否增量补上
master 维护一个固定大小的环形 replication backlog(复制积压缓冲区),最近写命令以「master_replid + offset」为坐标存在里面。
replica 短暂断线后重连:PSYNC <replid> <last_offset>
  master 检查请求的偏移是否还在 backlog 内:
    在 -> CONTINUE,只补缺失增量(部分重同步,便宜)
不在 -> FULLRESYNC,只能再来一次全量(昂贵)redis-cli INFO replication
# master_replid / master_repl_offset
# slave0:ip=...,state=online,offset=...,lag=0
redis-cli CONFIG GET repl-backlog-size # 默认 1MB,生产偏小
redis-cli CONFIG GET repl-backlog-ttl坑二:默认 backlog 只有 1MB,断线稍久就被覆盖、被迫全量。 写量大的实例应调大(如 64MB~256MB,按「断线可容忍时间 × 写入速率」估算),让短暂网络抖动只走增量。
主从通过 offset 持续对齐,lag 是 replica 心跳(REPLCONF ACK)延迟秒数,lag 持续增大说明复制跟不上或网络有问题。
三、异步复制与数据安全
Redis 主从复制是异步的:master 本地执行完就给客户端返回成功,写命令随后传播给 replicas。
- master 宕机且尚未传播的写会丢(故障切换到某个落后的 replica)。
- 这是性能与持久性的取舍,不要把它当同步数据库。
# WAIT 可阻塞等待指定数量 replica 确认(尽量,但非强一致保证)
> SET k v
> WAIT 2 100      # 最多等 100ms,要求 2 个 replica ACK
(integer) 2
WAIT 降低丢失概率,但在故障切换/网络分区下仍不构成线性一致,不能当作事务提交。
# 用 min-replicas 让“没有足够健康从库”的 master 拒绝写,缩小故障/脑裂丢数据窗口
min-replicas-to-write 1
min-replicas-max-lag 10
含义:若不足 1 个 lag ≤10s 的 replica,master 对写返回错误(牺牲可用性换安全)。
四、Sentinel:监控、通知、自动故障转移
Sentinel 是独立进程(至少 3 个、分布在不同机器/可用区),它们监控 master/replicas 并互相协商:
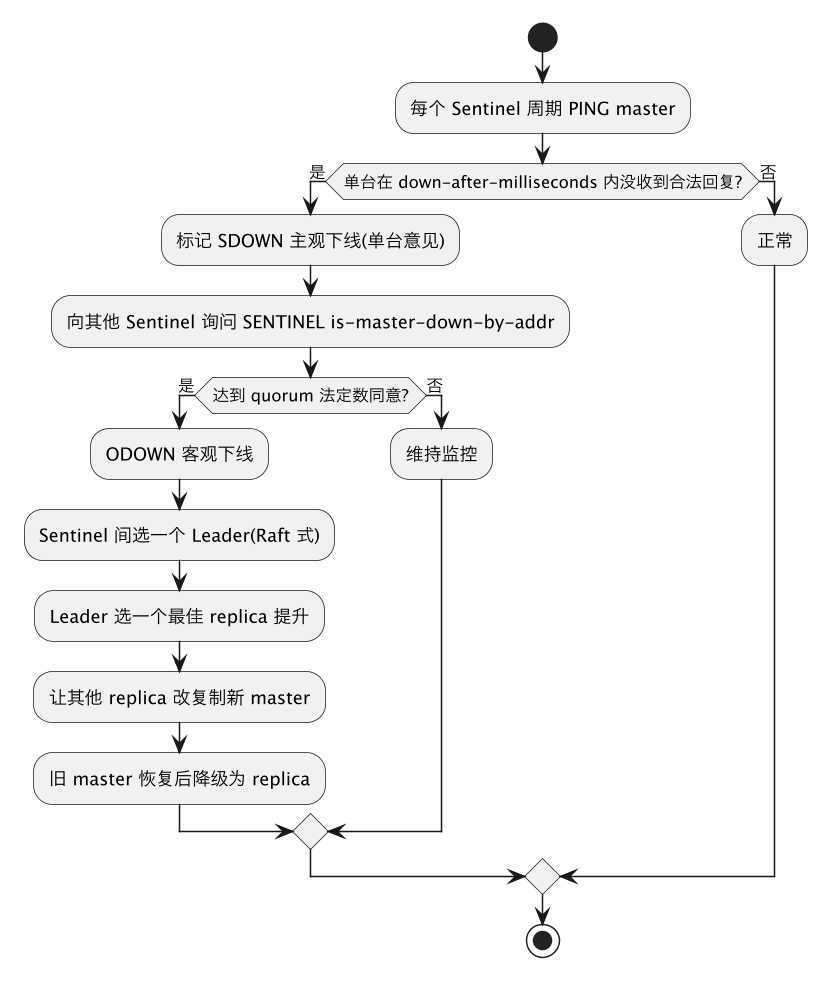
选新主的优先级:过滤掉断线/落后太多的 replica → 按 replica-priority(越小越优先,0 永不参选)→ 复制偏移最大(数据最全)→ runid 字典序兜底。
# sentinel.conf
sentinel monitor mymaster 10.0.0.11 6379 2
# 名字  主地址  端口  quorum=2(判定 ODOWN 需 2 票)
sentinel down-after-milliseconds mymaster 5000
sentinel failover-timeout mymaster 60000
sentinel parallel-syncs mymaster 1
五、脑裂与可用性权衡
分区时可能出现「老 master 在一个分区、Sentinel 多数派在另一个分区并选出新 master」,客户端若仍连着老主写入,恢复后老主降级,这些写就丢了。缓解:
min-replicas-to-write+min-replicas-max-lag:分区后老主联系不上足够 replica 就拒绝写,让它「想写也写不了」,显著缩小脑裂丢失窗口。- 客户端在故障转移期间要处理只读/重定向错误并重连。
六、客户端如何感知切换
- 客户端连接的是 Sentinel 而不是写死主 IP,启动/重连时:
    SENTINEL get-master-addr-by-name mymaster -> 返回当前主 IP:port
- 收到 READONLY(写到旧主)/连接断开,应重新向 Sentinel 查询并重连
- 主流客户端(Jedis/Lettuce/redis-py 的 Sentinel 模式)内置订阅 +切换事件/自动刷新
- 切换有秒级不可用窗口(failover-timeout、client 重连),应用要重试# 运维侧观察
redis-cli -p 26379 SENTINEL masters
redis-cli -p 26379 SENTINEL replicas mymaster
redis-cli -p 26379 SENTINEL failover mymaster # 手动触发切换演练七、Sentinel vs Cluster:选哪个
| 方案 | 解决什么 | 数据分布 |
|---|---|---|
| 主从 + Sentinel | 高可用(自动故障转移) | 单 master 装全量数据 |
| Redis Cluster | 高可用 + 水平分片 | 16384 槽分布在多 master |
数据量/写吞吐单机扛不住、要水平扩展,用 Cluster(见 Redis Cluster 槽位);只是要主从自动切换、数据量单机放得下,Sentinel 更简单。
八、相关与延伸
全量同步依赖 RDB,见 RDB 与 AOF 持久化;数据结构与 BigKey 见 Redis 数据结构;分片与 MOVED 重定向见 Redis Cluster 槽位;热点与缓存故障见 BigKey/HotKey 诊断、缓存穿透/击穿/雪崩。
总结
Redis 主从复制与哨兵:replica 通过 PSYNC 加入,首次全量(master BGSAVE 传 RDB + 补发缓存命令),之后异步命令传播;master 用环形复制积压缓冲区按 replid/offset 支持断线部分重同步,偏移被覆盖才被迫昂贵全量,故写多实例要调大 repl-backlog-size;复制是异步的,故障切换可能丢尚未传播的写,WAIT 只降概率不强一致,配 min-replicas-to-write/max-lag 让落后时拒绝写;Sentinel 多实例先 SDOWN 后达 quorum 判 ODOWN,选 Leader 后按 priority/offset/runid 提升最佳 replica 并让其余改挂新主;客户端要经 Sentinel 发现主、处理 READONLY/断连重连;脑裂靠 min-replicas 缩小丢失窗口;单机放得下只需高可用选 Sentinel,要水平分片选 Cluster。