SQLite 架构:VDBE 虚拟机、B-tree 页与 WAL 模式原理
更新时间:2026-09-18。SQLite 是世界上部署量最大的数据库引擎:它不是一个「连接到服务器」的进程,而是被链接进应用进程的库,整个数据库就是一个磁盘文件。本篇建立它的心智模型:分层架构、VDBE 字节码、pager 与 B-tree,以及决定并发能力的 journal 模式(尤其 WAL)。和 C/S 数据库的对比可参照 PostgreSQL 架构与 MVCC。
本文要回答的问题
- 「嵌入式、无服务器」在架构上意味着什么?进程内库怎么访问一个文件?
- SQL 是怎么被执行的?VDBE 虚拟机和字节码是什么?
- 数据库文件内部怎么组织(页、table b-tree、index b-tree)?
- rollback journal 和 WAL 两种模式差别?WAL 为什么能「多读单写不互斥」?
- WAL 何时 checkpoint 回主库?SQLite 适合/不适合什么场景?
一、分层架构:从 SQL 到磁盘页

| 层 | 职责 |
|---|---|
| Interface/C API | sqlite3_prepare_v2(编译)、stmt、sqlite3_step(逐步执行) |
| Compiler | 词法/语法分析 → 生成查询计划 → 产出 VDBE 字节码 |
| VDBE | 虚拟数据库引擎,一个可移植的栈式虚拟机,执行字节码指令 |
| B-tree | 在页上维护有序的 table b-tree(带 rowid)与 index b-tree |
| Pager | 按页读写、内存缓存、事务管理、日志、文件锁 |
| OS Interface(VFS) | 抽象文件/锁,便于移植到不同 OS |
关键差异:MySQL/PostgreSQL 是「客户端 ↔ 服务器进程 ↔ 磁盘」,SQLite 是函数调用直接进库,没有网络协议、没有独立服务进程、没有跨进程连接调度。
二、VDBE:SQL 被编译成字节码程序
每条 SQL 最终被编译成一段短小的 VDBE 指令序列,类似一个微型汇编程序。用 EXPLAIN(不是 EXPLAIN QUERY PLAN)能直接看到字节码:
CREATE TABLE t(id INTEGER PRIMARY KEY, v TEXT);
INSERT INTO t(v) VALUES ('hello');
EXPLAIN SELECT count(*) FROM t WHERE id > 10;
-- addr opcode        p1 p2 p3
-- 0    Init          0  11  0
-- 1    AggNext       ...
-- ... Rewind/Column/AggStep/ResultRow ...-- 看优化器选了什么访问路径(更接近其他库的 EXPLAIN)
EXPLAIN QUERY PLAN SELECT * FROM t WHERE id = 1;
-- SEARCH t USING PRIMARY KEY (id=?)
EXPLAIN QUERY PLAN SELECT * FROM t WHERE v LIKE '%x%';
-- SCAN t ← 全表扫描要点:
- VDBE 是栈式/寄存器式虚拟机(现代版本偏寄存器风格指令),指令如
SeekGE(B-tree 定位)、Column、IdxNext、AggStep。 - 同一份字节码在所有平台行为一致,这是 SQLite 高可移植性的核心。
- 调优主要看
EXPLAIN QUERY PLAN的 SCAN(全扫)/SEARCH(索引),而不是手写字节码。
三、文件格式:页、table b-tree 与 index b-tree
整个数据库是一个固定页大小(默认 4096 字节)的文件,结构是多棵 B-tree:
| 结构 | 键 | 值 |
|---|---|---|
| table b-tree | INTEGER PRIMARY KEY(rowid) | 整行记录(列值) |
| WITHOUT ROWID 表 | 声明的 PRIMARY KEY | 整行 |
| index b-tree | 索引列 + rowid | 叶子键(用于回表) |
db 文件
┌── 页1: sqlite_master(schema:表/索引定义)
├── table b-tree 页...     键=rowid,值=行
└── index b-tree 页...     键=(索引列,rowid),叶子按索引有序
普通表(有 rowid):索引找到 (索引列→rowid),再用 rowid 去 table b-tree 取行(回表)
坑一:主键的两种形态。 INTEGER PRIMARY KEY 直接成为 rowid 别名(聚簇,省一次回表);其他类型主键会在内部建一个隐藏 rowid + 一个唯一 index b-tree,查它要回表。设计高频点查列尽量用 INTEGER PRIMARY KEY(或 WITHOUT ROWID 适合复合主键且行小)。
Pager 负责把页缓存在进程内存、记录脏页,并在提交时按日志模式保证原子性。多个进程靠 文件锁(字节范围锁) 协调,而不是共享内存里的锁管理器。
四、两种日志模式:rollback journal vs WAL
PRAGMA journal_mode;        -- delete(默认旧模式) / wal / memory / off
PRAGMA journal_mode=WAL;    -- 切到 WAL(生成 db-wal、db-shm)
rollback journal(delete/truncate/persist,传统默认)
- 改页前先把原始页备份到
-journal文件;提交时删 journal。 - 崩溃恢复:若发现 journal 还在,用它把页回滚到改前状态。
- 并发:写事务持有保留锁→排他锁,写时别人连读都要等(读者与写者互斥),并发很弱。
WAL(Write-Ahead Log,推荐用于并发读写)
- 修改先追加到
-wal文件,提交就是把 WAL 帧 fsync 落盘;读操作在一个「快照(read mark)」上,从 db + WAL 的合适版本取页。 - 结果:多个读者 + 一个写者可以同时进行(多读单写、读不阻塞写、写不阻塞读),这是 SQLite 并发能力的关键升级。
- 仍然只允许一个写者(WAL 写锁在整个库级别),所以它不是高并发写入数据库。
读事务:拿 read mark → 读页时,若该页在 WAL 里有“≤自己快照”的最新帧就读 WAL,否则读主 db
写事务:把被改页的新帧追加进 WAL(提交=fsync WAL),不立即改主 db| 维度 | rollback journal | WAL |
|---|---|---|
| 写时能否并发读 | 否(排他锁阻塞读) | 能 |
| 读/写互斥 | 强互斥 | 读不阻塞写、写不阻塞读 |
| 并发写 | 单写 | 仍单写 |
| 额外文件 | -journal(瞬时) | 持久的 -wal + -shm |
| 网络文件系统 | 相对容忍 | 要求共享内存/锁,不支持网络盘 |
坑二:WAL 依赖 -shm 共享内存与原语锁,不能放在网络文件系统(NFS/ SMB)上。 多进程必须在同一台机器、通过同一文件系统访问;容器/多 volume 挂载场景尤其要确保 db、-wal、-shm 在同一可共享内存的本地卷。
五、WAL checkpoint:把日志合并回主库
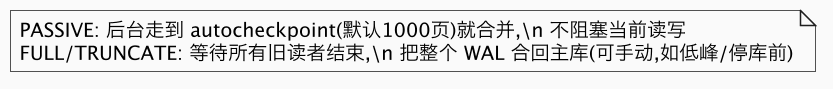
WAL 不能无限增长。checkpoint 把 WAL 里的页写回主 db 文件,然后 WAL 可复用/截断。
PRAGMA wal_checkpoint;            -- PASSIVE:能做多少做多少,不等待读者
PRAGMA wal_checkpoint(FULL);      -- 等读者退出,做到一致点
PRAGMA wal_checkpoint(TRUNCATE);  -- FULL 后把 WAL 截到 0
PRAGMA wal_autocheckpoint;        -- 默认 WAL 达到 1000 页时自动 PASSIVE checkpoint
六、锁状态与「database is locked」
WAL 模式下连接获取锁是分阶段的,理解它能解释大部分锁报错:
读连接:拿 SHARED 锁 + 一个 read mark(快照)
写连接:拿 RESERVED(预留写 WAL)→ 提交时 PENDING→EXCLUSIVE(很短暂,冲掉旧帧)- 多读者各持 SHARED 不冲突;写者在大部分时间持 RESERVED,允许并发读。
- 提交切 EXCLUSIVE 的瞬间需要没有读旧 WAL 帧的读者,通常极短;长读事务会让它等待。
- 两个写者:第二个拿不到 RESERVED,立即得到
SQLITE_BUSY。
PRAGMA busy_timeout = 5000;   -- 遇锁最多等 5000ms 再报 SQLITE_BUSY
PRAGMA synchronous = NORMAL; -- WAL 下推荐 NORMAL(安全且更快),FULL 最稳但慢
坑四:必须设 busy_timeout。 默认是 0——一旦写冲突立刻 database is locked。服务化使用要统一在连接初始化时设置 busy_timeout,并让写事务尽量短、写操作串行化(单写线程/单写进程)。
七、适用与不适用场景
| 适合 SQLite | 不适合 SQLite |
|---|---|
| 单机/桌面/移动 App、浏览器本地存储 | 多机通过网络共享同一个库 |
| 边缘设备、IoT、嵌入式配置与缓存 | 高并发写(多客户端同时大量写) |
| 中小网站(读多写少,WAL 下很能扛) | 需要复杂用户/权限体系、跨库 JOIN 集群 |
| 测试、可整体拷贝的归档/数据集、单文件交付 | 超大单库多写者的 OLTP(还是上 PostgreSQL/MySQL) |
实践建议:批量写放在一个事务里(默认每条语句一个事务会被 fsync 拖垮);用预编译 statement 绑定参数;WAL + synchronous=NORMAL + busy_timeout 是常见服务配置;定期/在 -wal 膨胀时做 TRUNCATE checkpoint。
八、相关与延伸
C/S 数据库的多进程架构与 MVCC 对照见 PostgreSQL 架构与 MVCC;WAL/checkpoint 概念在服务端的形态见 PostgreSQL WAL 与 checkpoint;索引/查询计划判读见 SQLite 索引与查询优化;与 MySQL/PG 选型对比见 PostgreSQL 与 MySQL 差异。
总结
SQLite 架构与 WAL:SQLite 是链接进进程的库,整个库是一个分页文件,SQL 经编译生成 VDBE 字节码由虚拟机执行,B-tree 层用 table b-tree(键为 rowid)和 index b-tree 组织,Pager 管页缓存/事务/文件锁;传统 rollback journal 写时阻塞读,WAL 模式把修改先追加到 -wal,实现多读单写并发、读写互不阻塞,但仍只允许一个写者;修改由 checkpoint(默认 1000 页被动触发)合回主库,长读事务会钉住 WAL 致其膨胀,且 WAL 依赖共享内存不能放网络盘;使用时务必设 busy_timeout、写事务短小并串行、批量写包进单事务,它最适合单机/边缘/读多写少与单文件交付,不适合网络共享与高并发多写。
坑三:长读事务会钉住 WAL。 只要存在一个持有很旧 read mark 的读事务,那段 WAL 帧就不能被 checkpoint 回收,-wal 越滚越大、读放大上升(读一页可能要在长 WAL 里多次回查)。应用务必用完语句尽快结束事务/重置 statement,不要长期挂着一个打开的事务——这和服务端数据库「长事务阻止日志回收」是同构问题(见 PostgreSQL WAL)。