Redis 持久化:RDB 与 AOF 取舍、fsync 策略与混合持久化
更新时间:2026-09-18。Redis 是内存数据库,持久化决定「宕机/重启后能找回多少数据」。理解 RDB/AOF 的关键是分清快照与日志追加两种范式,以及它们共同依赖的
fork()+ 写时复制。前置:Redis 数据结构;高可用下持久化与复制的关系见 Redis 主从复制与哨兵。
本文要回答的问题
- RDB 快照是怎么在不阻塞服务的情况下生成的?fork/COW 的代价?
- AOF 记录什么?
always/everysec/no三档 fsync 安全性差多少? - AOF 越写越大怎么办?重写(rewrite)原理和风险?
- 崩溃时怎么恢复?RDB、AOF、混合持久化谁先生效?
- 生产环境到底开 RDB、AOF 还是混合?
一、两种范式一图对比
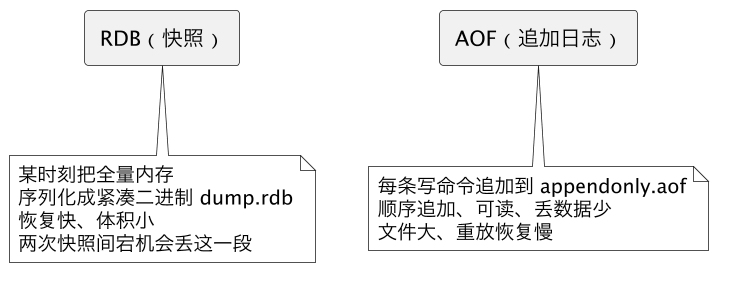
| 维度 | RDB | AOF |
|---|---|---|
| 形式 | 某一时刻的内存快照(二进制紧凑) | 写命令追加日志(RESP 文本/多部分协议) |
| 数据安全 | 两次快照之间宕机会丢 | everysec 最多丢约 1 秒 |
| 文件体积 | 小(压缩二进制) | 大(命令冗余,需重写) |
| 恢复速度 | 快(直接加载) | 慢(顺序重放命令),混合后改善 |
| 对性能影响 | bgsave 时 fork + COW | 持续写盘 + fsync + 定期重写 |
| 可读性 | 不可读 | 可读(可手工删尾部坏命令) |
二、RDB:bgsave、fork 与写时复制
# 触发:save(阻塞,生产别用)/ bgsave(后台)/ 配置规则自动触发
127.0.0.1:6379> BGSAVE
Background saving started
127.0.0.1:6379> INFO persistence
# rdb_bgsave_in_progress:1
# rdb_last_bgsave_status:ok
# latest_fork_usec:18340        # 最近一次 fork 耗时(微秒),越大越危险
BGSAVE 时主进程 fork() 出一个子进程,由子进程把内存快照写到临时 RDB,再原子 rename 覆盖旧文件。fork 本身在大内存实例上可能很慢(要复制页表),fork 期间主进程被阻塞——这是 Redis 大实例延迟毛刺的经典来源。
写时复制(COW):fork 后父子共享物理内存页,只有主进程修改的页才被复制一份。因此:
- 如果 bgsave 期间写入很猛,大量页被改 → RSS 实际占用可能逼近甚至接近额外一倍内存。
- 内存使用率很满 + 大 RDB + 写入高峰 → fork 时可能 OOM(Linux 还可能因 overcommit 策略拒绝 fork)。
# 关注 fork 耗时与 COW 放大
redis-cli INFO stats | grep latest_fork_usec
# latest_fork_usec 若达到几百 ms~秒级,说明实例过大/页表多,要拆分或用大页注意事项

# 建议关闭透明大页 THP:它会让 COW 复制单位从 4KB 变 2MB,放大内存与延迟
echo never > /sys/kernel/mm/transparent_hugepage/enabled
坑一:RDB 规则的「多条件是或关系」。 save 3600 1 300 100 60 10000 表示任一条件满足就快照(3600s 内 1 次写、或 300s 内 100 次、或 60s 内 1 万次)。有人以为是「同时满足」,结果快照比预期频繁。要完全禁用 RDB 用 save ""。
三、AOF:命令追加与三档 fsync
AOF 在命令执行后把协议追加到内存 AOF buffer,再按策略刷到文件:
appendonly yes
appendfsync always    # 每条写都 fsync:最安全最慢,几乎不用
appendfsync everysec  # 每秒 fsync 一次(默认推荐):最多丢约 1 秒
appendfsync no # 交给 OS 刷:最快,宕机丢失量取决于 OS,不可控redis-cli CONFIG GET appendfsync
redis-cli CONFIG GET appendonly
# Redis 7 AOF 目录结构:appendonlydir/ 下 manifest + 基础 AOF + 增量 AOF 段| fsync | 宕机丢失 | 性能 | 适用 |
|---|---|---|---|
| always | 几乎 0 | 差(每命令一次磁盘同步) | 极少用 |
| everysec | 约 1 秒 | 接近不持久化 | 绝大多数生产 |
| no | 不可控(数十秒级) | 最好 | 纯缓存/可重建数据 |
坑二:everysec 在磁盘繁忙时的行为。 当后台 BIO 线程 fsync 慢于 1 秒,主进程会让步避免 AOF 缓冲区无限堆积(表现为写入延迟短暂变高)。磁盘 IO 饱和(AOF 重写 + RDB 叠加其他服务)时会出现每秒级抖动,应把持久化盘隔离、用 SSD。
四、AOF 重写:把「过程」压缩成「当前状态」
AOF 记录的是命令流水:同一个 key 被 INCR 一百万次就有一百万条,但最终值只是一个数字。重写读取当前内存,用最少的命令重建出等效数据集,生成新的基础 AOF,再切换。
127.0.0.1:6379> BGREWRITEAOF
# 自动触发:aof 文件比上次重写后增长超过 auto-aof-rewrite-percentage(默认100%)
# 且大于 auto-aof-rewrite-min-size(默认64mb)
重写同样 fork() 子进程,因此有与 RDB 相同的 fork/COW 代价。重写期间的新写命令既要写到旧 AOF,也要进「重写增量缓冲」,子进程完成后把增量补上再切换。
坑三:重写期间是内存与磁盘双高峰。 既要 COW 内存、又要同时写新旧文件,磁盘剩余空间不足可能重写失败并留下临时文件。要像对待 RDB 一样预留内存与磁盘,并避免在业务高峰触发。
五、混合持久化与崩溃恢复顺序
Redis 4.0+ 支持 RDB-AOF 混合(aof-use-rdb-preamble yes,新版默认开):AOF 重写时基础部分以 RDB 二进制写,后续增量仍用命令追加,兼顾「RDB 加载快」与「AOF 丢得少」。
启动恢复选择逻辑:
开启 AOF(含混合):优先加载 AOF(先读 RDB 段再重放命令段)
否则:加载 dump.rdb
都没有:空实例启动redis-cli INFO persistence | egrep 'aof_enabled|aof_last|rdb_last|loading'
# AOF 尾部写一半损坏:redis-check-aof --fix 截掉不完整尾部(丢尾部命令但能启动)六、生产配置建议
# 推荐:AOF everysec + 混合,兼顾安全与恢复速度
appendonly yes
appendfsync everysec
aof-use-rdb-preamble yes
auto-aof-rewrite-percentage 100
auto-aof-rewrite-min-size 256mb

# 保留低频 RDB 作为冷备/快速全量恢复(并异地拷贝)
save 3600 1
save 300 100
# 系统层:关 THP、留足 COW 内存与磁盘、独立持久化盘、vm.overcommit_memory=1| 数据性质 | 建议 |
|---|---|
| 纯缓存、可从 DB 重建 | 可弱化/关闭持久化 |
| 不能丢秒级以上数据 | AOF everysec + 混合 + 异地备份 |
| 追求最短重启时间 | 混合持久化 |
| 跨机房/灾备 | 结合复制与异地快照 |
坑四:持久化不是备份。 RDB/AOF 都在本机,误操作 FLUSHALL、文件损坏、机器报废照样丢。真正备份要把文件定期复制到异地/对象存储并做恢复演练。
七、相关与延伸
数据结构与 BigKey 见 Redis 数据结构;全量同步传 RDB 见 Redis 主从复制与哨兵;集群见 Redis Cluster 槽位;缓存异常模式见 缓存穿透/击穿/雪崩。
总结
Redis 持久化 RDB 与 AOF:RDB 是紧凑二进制快照、文件小恢复快但会丢快照间隔数据,靠 BGSAVE 的 fork 子进程 + 写时复制生成,大实例 fork 会卡、COW 放大内存,需关 THP、留内存并看 latest_fork_usec;AOF 是写命令追加日志,always 最安全但慢、everysec 默认最多丢约 1 秒、no 不可控,AOF 膨胀需 BGREWRITEAOF 重写(同样 fork、新旧双写形成磁盘内存双高峰);生产推荐 AOF everysec + RDB-AOF 混合并保留 RDB 冷备,恢复时优先 AOF 否则 RDB;务必记住持久化不是备份,误操作和机器报废要靠异地快照与恢复演练。