MongoDB 文档模型、索引与分片:BSON、聚合管道与分片键
更新时间:2026-09-18。MongoDB 是最主流的文档数据库,把「行/表」换成「文档/集合」,天然适合结构多变、嵌套聚合、水平扩展的负载。它不是「JSON 大仓库」,用错(无索引、巨型文档、坏分片键)一样会慢、会膨胀。对照关系模型可看 PostgreSQL 与 MySQL 差异、JSONB 的关系派解法 PostgreSQL JSONB 与 GIN。
本文要回答的问题
- 文档、集合、BSON 是什么?schema-less 的真实代价?
- _id/ObjectId 结构与时间有序性?文档大小限制?
- 有哪些索引类型?ESR 规则和 explain 怎么用?
- 聚合管道(aggregate)能干什么?
- 副本集与分片架构?分片键选错为什么会致命?
- 什么场景该/不该选 MongoDB?
一、文档模型:BSON、集合与 schema-less
- 文档(document):一个 BSON 对象(Binary JSON,支持更多类型:日期、ObjectId、整型、浮点、二进制、Decimal128),类似一条 JSON 记录。
- 集合(collection):文档的容器,类似表,但不强制所有文档同结构。
- 数据库:多个集合的命名空间。
// users 集合中的一条订单/用户文档(嵌套、数组都自然支持)
db.users.insertOne({
  _id: ObjectId("66e9a2b0c1a2b3c4d5e6f708"),
  name: "Tom",
  tags: ["vip", "wx"],
  address: { city: "Beijing", zip: "100000" },
  created_at: new Date()
})
_id 是主键,默认 ObjectId(12 字节:4 字节时间戳 + 5 字节随机/机器/进程 + 3 计数器),大致按生成时间递增,因此按 _id 范围/排序天然近似时间有序,且索引插入多在 B-tree 右侧(与自增主键类似)。
坑一:schema-less 不是 schema-any。 没有强约束意味着脏字段、类型漂移(age 有时字符串有时数字)会悄悄进入,查询与索引因此失配。生产应:
- 用 JSON Schema Validator 给集合加校验(
collMod+validator); - 应用层/DTO 统一类型;
- 约定字段命名,避免同名字段多类型。
坑二:单个文档上限 16MB。 无限往里塞数组(如把用户所有订单内嵌)会撞上限、导致整文档读写放大、更新时整文档重写。应控制嵌套数组长度,超大列表拆集合或用分桶(bucket pattern)。
二、建模:内嵌 vs 引用
| 关系 | 选择 | 理由 |
|---|---|---|
| 一对一、一对少、强从属、总一起读 | 内嵌(embed) | 一次读取拿全,无 JOIN |
| 一对多且「多」无界、多对多、数据被多方复用 | 引用($lookup/手动引用) | 防文档无限膨胀、便于独立更新 |
// 内嵌:订单里嵌少量、强从属的条目(合理)
db.orders.insertOne({
  user_id: 1001, status: "paid",
  items: [{ sku: "a", qty: 1 }]   // 条目数可控
})
// 引用:商品详情独立集合,被很多订单引用
db.products.findOne({ _id: skuId })
文档模型的优势是「聚合根」一次取出、无 JOIN;但不要把关系库本该规范化的多对多硬塞成嵌套大文档。
三、索引:与关系库同源,但有文档特色
MongoDB 底层索引也是 B-tree,支持:
| 索引 | 用途 |
|---|---|
| 单字段 | 等值/范围/排序 |
| 复合(compound) | 多条件,遵循 ESR 顺序 |
| 多键(multikey) | 自动为数组字段每个元素建索引 |
| 文本 text | 全文检索(英文友好,中文需分词方案) |
| 2dsphere | 地理空间 |
| TTL | 过期自动删除(日志/会话) |
| 唯一/稀疏/部分索引 | 约束与减小体积 |
ESR 规则(复合索引字段顺序):Equality(等值)→ Sort(排序字段)→ Range(范围)。
// 查询:等值 user_id、status,范围 created_at,按 created_at 排序
db.orders.createIndex({ user_id: 1, status: 1, created_at: -1 })
db.orders.find({ user_id: 1001, status: "paid",
                 created_at: { $gt: ISODate("2026-09-01") } })
         .sort({ created_at: -1 })
坑三:把范围字段放排序字段前面会破坏排序下推。 范围在前会让后续排序无法纯索引有序,触发内存排序(SORT 阶段,超 100MB 直接报错,需 allowDiskUse)。按 ESR 放等值、排序、范围,并用 explain 验证。
db.orders.find({ user_id: 1001 }).explain("executionStats")
// 关注:
// stage: IXSCAN(走索引) / COLLSCAN(全集合扫描,警惕)
// totalDocsExamined vs nReturned: examined 远大于返回=回表/不匹配多
// totalKeysExamined
// SORT / SORT_MERGE:内存排序
多键索引的坑:复合索引若多个字段都是数组会报错(一个复合索引不允许跨多数组);数组基数巨大的字段多键索引体积大。
四、聚合管道 aggregate
把数据处理拆成一串阶段(stage),类似管道:
db.orders.aggregate([
  { $match: { created_at: { $gt: ISODate("2026-09-01") } } }, // 尽早过滤,用上索引
  { $group: { _id: "$user_id", cnt: { $sum: 1 }, amt: { $sum: "$amount" } } },
  { $sort: { amt: -1 } },
  { $limit: 20 }
])常用阶段:$match(过滤,尽量前置以走索引、减小中间结果)、$group、$sort、$lookup(类 JOIN)、$project、$unwind(拆数组)、$facet。
坑四:管道顺序决定性能。 不在前面 $match 收敛,会对全集合做 group/unwind,内存与时间爆炸;大聚合走专用分析节点/数仓更合适,OLTP 主节点上跑重聚合会影响线上延迟。
五、副本集:高可用
MongoDB 副本集 = 1 主多从(primary/secondary),主写、通过 oplog(幂等的操作日志,类似 binlog 的作用但在 local 库)异步复制到从。
- 主宕机由多数派 secondary 投票选主(需多数派存活,类似哨兵/raft 思想)。
- 写关注
w: "majority"可等多数派确认才返回(防主切换丢数据);j: true等 journal 落盘。 - 读偏好 primary/primaryPreferred/secondary/nearest:从库读有复制延迟,只用于可接受旧数据的场景。
// 安全写:等多数派 + journal
db.orders.insertOne(doc, { writeConcern: { w: "majority", j: true, wtimeout: 5000 } })
六、分片:水平扩展与分片键
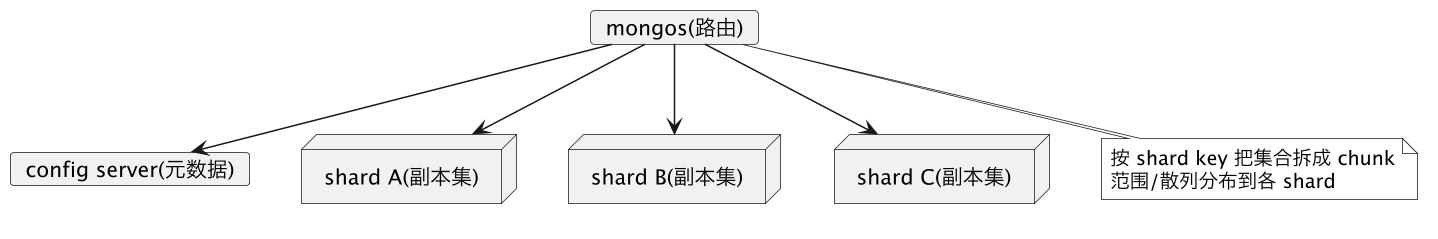
数据按 shard key(分片键) 切成若干 chunk,由 mongos 依 config 元数据路由:
- 范围分片(range):按键区间切,范围查询高效;分片键单调递增(如 ObjectId 时间)则写入集中到最后一个 chunk → 写热点。
- 散列分片(hashed):哈希打散、写均匀;但范围查询要**广播到所有分片(scatter-gather)**再归并。
| 查询是否带分片键 | 路由 |
|---|---|
| 含分片键等值/可定位区间 | 直达目标分片(targeted) |
| 不带分片键 | scatter-gather 广播,代价高 |
坑五:分片键基本是一锤定音的决策。 好分片键:① 基数足够高;② 写分布均匀(避免单调递增);③ 高频查询都能带它(减少广播);④ 与排序/聚合亲和。常见折中是高基数字段范围分片接受一定热点,或 hashed 追求写均匀另辟范围查询路径。
坑六:jumbo chunk。 分片键基数不足(只几个取值)时,某 chunk 超尺寸也无法再切,永久停在一个分片造成容量/流量倾斜——分片键基数必须远大于分片数。
七、适用与不适用
| 适合 MongoDB | 不适合 |
|---|---|
| 文档结构多变、字段频繁增删 | 强跨文档事务/复杂多表 JOIN 的规整关系数据 |
| 嵌套聚合根、一次读全 | 强范式化、多对多关系为核心 |
| 水平扩展、海量按键分布数据 | 任意 SQL 即席分析(OLAP 另选列存) |
| 日志/事件/内容/画像、快速迭代 | 只因「NoSQL 听起来快」就迁移关系系统 |
4.0+ 支持多文档 ACID 事务,但应当例外:好的文档建模让多数操作落在单文档内(单文档操作天然原子)。
八、相关与延伸
关系派半结构化方案见 PostgreSQL JSONB 与 GIN;选型对照见 PostgreSQL 与 MySQL 差异;与缓存配合见 缓存一致性;哈希槽分片对照见 Redis Cluster 槽位;异步复制与多数派见 Redis 主从与哨兵。
总结
MongoDB 文档模型、索引与分片:以 BSON 文档/集合替代行/表,schema 灵活但要用校验器防类型漂移、控制单文档 ≤16MB、强从属少内嵌、无界一对多和多对多用引用;_id 的 ObjectId 大致时间有序,索引为 B-tree,复合索引遵守 ESR(等值→排序→范围)顺序,用 explain 的 IXSCAN/COLLSCAN 与 docsExamined 判断,数组自动多键、TTL 管过期;聚合管道尽早 $match 收敛;副本集靠 oplog 与多数派选举、w:majority 防切换丢数据;分片经 mongos/config 按 shard key 切 chunk,范围分片利于范围查但单调键会写热点,hashed 写均匀但范围查询广播,好分片键要高基数、写均匀且高频查询都能带它,低基数会产生无法迁移的 jumbo chunk;适合结构多变、嵌套聚合根与水平扩展业务,强关系复杂 JOIN 仍应选关系数据库。