短连接建连成本实测:TIME_WAIT 怎样把临时端口耗尽
「短连接把端口打满了」是性能排查里的高频判断,但在测试环境亲手复现一次就会发现,这件事比一句口号复杂得多:同样是每秒上万条短连接,有时候 ss 里 TIME_WAIT 只有几百个、应用零失败,有时候 1500 个端口真的一条不剩、connect() 直接返回 99 号错误。TIME_WAIT 的协议语义在 TCP TIME_WAIT 原理、影响与处理方法里已经讲透,本篇只回答工程问题:端口耗尽在什么条件下才会发生,内核的两道自我保护怎样把它挡在应用层之外,tcp_tw_reuse 的救场能力边界又在哪里。监听队列方向的邻居话题见 listen 队列与半连接/全连接内核机制,参数全景见 Linux 内核网络参数调优。
本文要回答的问题
- 为什么用 nginx 加 ab 在 loopback 上猛打短连接,临时端口怎么都耗不尽?
- TIME_WAIT 落在客户端还是服务端,由谁主动关闭决定,这对端口压力意味着什么?
tcp_max_tw_buckets的溢出回收具体表现为什么现象,怎么观测?- 把端口段压到 1500 个并真正打出 EADDRNOTAVAIL,需要什么实验条件?
tcp_tw_reuse=1能不能完全救场,什么情况下它只能救回四分之一的连接?
一、排查漏斗:从建连失败到端口四元组
把「短连接报错」收敛到「临时端口耗尽」需要逐层排除,先固定排查路径。
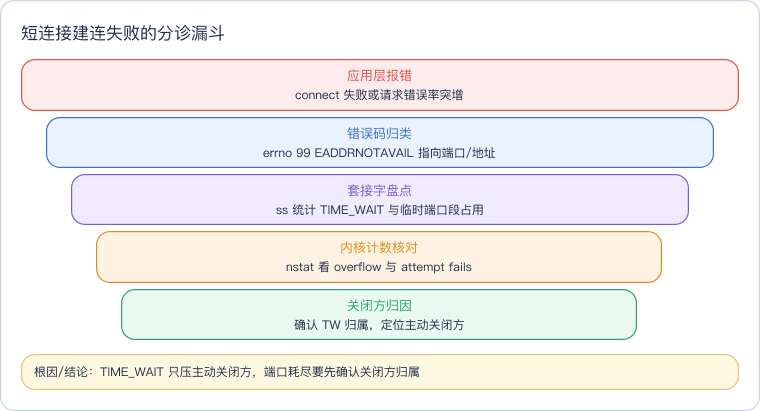
漏斗最容易漏掉的是最后一层。很多排查止步于「TIME_WAIT 很多」,但 TIME_WAIT 挂在谁的四元组上,决定了它消耗的是哪一端的资源。实验的第一件事就是把这层关系显式化。
二、先厘清归属:TIME_WAIT 消耗的是主动关闭方的端口
TCP 四次挥手后,主动关闭方在发出最后一个 ACK 时进入 TIME_WAIT,停留固定 60 秒。对短连接客户而言,这个套接字的四元组是「本机临时端口 + 对端监听端口」,它占用的是本机的临时端口号;对端服务侧的 TIME_WAIT 四元组反过来,本地端口永远是监听端口 80,不消耗临时端口。
红色路径才是端口耗尽的充分条件:客户端主动关闭、TIME_WAIT 压在临时端口上。绿色路径下 TIME_WAIT 再多也只是监听端口上的不同四元组,临时端口随关随还。这张图解释了为什么第一个实验打不出耗尽——它的关闭方是服务端。
三、第一组实验:nginx/ab 为什么打不爆端口
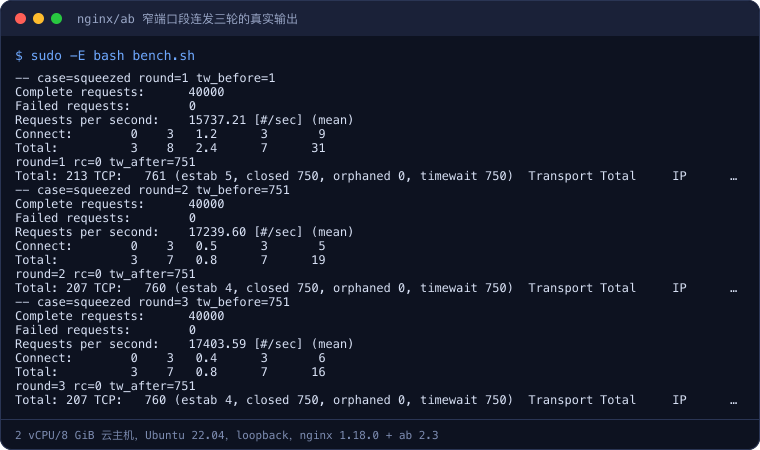
第一个实验完全按常见教程搭建:本机 nginx 1.18.0,ApacheBench 2.3 以 HTTP/1.0 无 keep-alive 打 http://127.0.0.1/,每轮 4 万请求、128 并发。先在系统默认配置下跑一个守卫用例,再把 tcp_max_tw_buckets 从 4096 抬到 200000、端口段压到 1500 个连发三轮。结果是全部用例 Failed requests: 0,窄端口段下 TIME_WAIT 稳定在 750 个左右。
应用零失败不等于内核没有代价。守卫用例前后各取一次 nstat,TcpExtTCPTimeWaitOverflow 从 152038 涨到 177234,单轮净增 25196——内核在 TIME_WAIT 数量碰到 tcp_max_tw_buckets=4096 上限时直接回收最旧的时间等待套接字,错误被内部消化,应用看到的仍是全部成功。
-- nstat[before-guard]
   TcpExtTCPTimeWaitOverflow       152038             0.0
-- nstat[after-guard]
   TcpExtTCPTimeWaitOverflow       177234             0.0
第二个原因是关闭方归属。HTTP/1.0 响应发完后 nginx 立刻关闭连接,服务端成为主动关闭方,TIME_WAIT 的本地端口是 80 而不是 ab 的临时端口。把 bucket 抬高、端口段压窄之后,ss 里的 TIME_WAIT 仍然只有约 750 个:客户端是被动关闭方,连接一结束临时端口立即释放,根本不进入 TIME_WAIT;服务端侧的 TW 本地地址固定是 80 端口,四元组随 ab 源端口快速周转而被复用,同样堆积不起来。这个实验的结论是否定性的,但很值钱:在「服务端先关」的真实 HTTP 栈上,loopback 压测复现不了临时端口耗尽,继续调小端口段只是在测试一个不会发生的场景。
四、第二组实验:C 最小对把关闭方换成客户端
要满足第二节的红色路径,需要一个回完响应后故意不立刻关闭的服务端,让客户端读完就关、成为主动关闭方。实验用两个共约 150 行的 C 程序实现:服务端线程收到请求后发完固定响应、睡眠 500 毫秒再关闭;客户端 64 线程循环 connect/send/recv/close,并按 errno 把失败精确归类为 EADDRNOTAVAIL 与其他错误。三用例统一把 bucket 抬到 200000,排除溢出回收的干扰,每用例 2 万次连接尝试。
紫色判定节点的依据是四元组唯一性:端口段 40000–41499 只有 1500 个端口,每个进入 TIME_WAIT 的套接字把对应端口锁定 60 秒,池子填满后新的 connect() 选不出可用端口。实测结果与这个模型严格吻合。
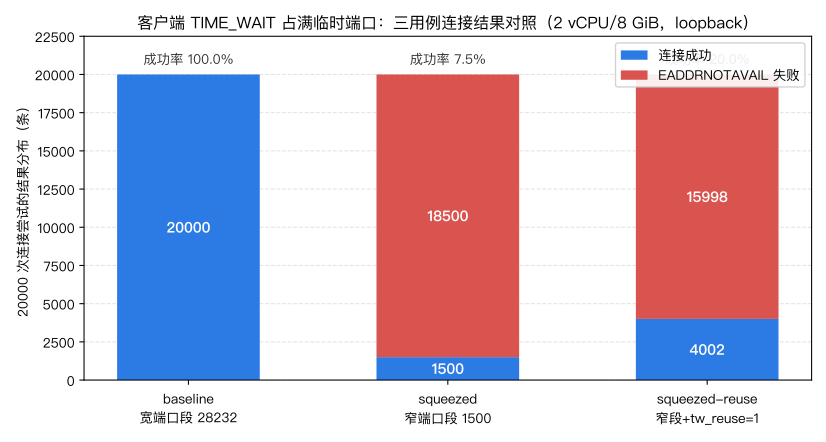
| 用例 | 端口段 | tw_reuse | 成功 | EADDRNOTAVAIL | 成功率 | 耗时 |
|---|---|---|---|---|---|---|
| baseline | 32768–60999(28232) | 0 | 20000 | 0 | 100.0% | 12.579 s |
| squeezed | 40000–41499(1500) | 0 | 1500 | 18500 | 7.5% | 1.851 s |
| squeezed-reuse | 40000–41499(1500) | 1 | 4002 | 15998 | 20.0% | 2.516 s |
squeezed 用例的成功数恰好是 1500,一个不多一个不少——端口段有多少个端口,客户端就能完成多少条连接,之后全部失败,这是端口耗尽最干净的判别特征。下面的终端记录里三个用例依次排开,baseline 留下近两万个 TIME_WAIT、squeezed 的 TW 停在 1500、reuse 例的失败计数仍然上万。
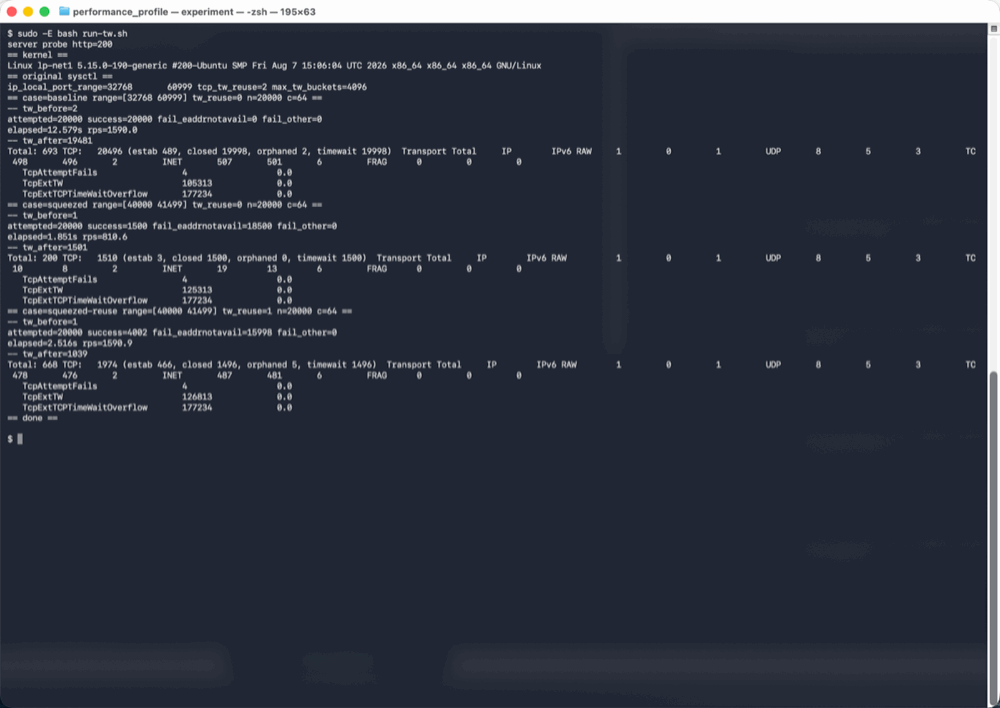
原始输出如下。
== case=squeezed range=[40000 41499] tw_reuse=0 n=20000 c=64 ==
attempted=20000 success=1500 fail_eaddrnotavail=18500 fail_other=0
elapsed=1.851s rps=810.6
-- tw_after=1501
== case=squeezed-reuse range=[40000 41499] tw_reuse=1 n=20000 c=64 ==
attempted=20000 success=4002 fail_eaddrnotavail=15998 fail_other=0
elapsed=2.516s rps=1590.9
五、tw_reuse 的真实边界:只救得回「足够老」的 TW
tw_reuse=1 的结果值得单独讲,因为它和「打开复用就不会耗尽」的直觉相反:成功率只从 7.5% 升到 20.0%,仍有 15998 次失败。内核复用 TIME_WAIT 端口有两个硬条件,一是时间戳开启且该四元组上的 TW 已存活超过重传超时度量(约 1 秒量级),二是新连接的时间戳严格递增。本实验的连接尝试在两三秒内全部打完,绝大多数 TW 还太年轻,达不到复用年龄,能被救回的只是最早进入池子的那一批。
这给出一条可迁移的工程判断:tw_reuse 对持续匀速的短连接流量有效,老 TW 随流量自然老化、端口循环周转;对秒级突发流量效果有限,池子在老化窗口到来之前就被填满。真正的根治手段按代价从低到高是:扩大 ip_local_port_range、让服务端承担主动关闭(HTTP 短连接的常见默认形态)、连接池化把短连接改长连接,最后才是在理解 PAWS 前提下调复用。还有一个需要一起评估的伴随上限:服务端每个连接要持有一个文件描述符,按实测峰值约 1590 req/s、每连接持有 500 毫秒估算,突发期并发存活连接约 800 个,已经逼近本机 1024 的 ulimit -n;本次运行没有真正触顶,但服务端代码仍为 accept 返回 EMFILE/ENFILE 预置了腾位重试分支。端口耗尽与 fd 耗尽往往在同一波短连接风暴里相邻出现,排查时两个上限要一起看。
落到生产值班场景,可以按症状直接选动作。日志里出现 EADDRNOTAVAIL 且 ss 显示客户端 TW 逼近端口段大小,先临时扩端口段止血,再推动客户端连接池改造;只有 TW 总量高但没有建连失败,先查 TCPTimeWaitOverflow,若计数在涨说明内核兜底正在工作,优先级应让给业务侧的连接复用治理,而不是急着改回收参数;跨机场景还要额外确认 NAT 网关自身的端口映射表,云上负载均衡到后端的短连接风暴里,先到上限的常常不是主机而是中间设备。把参数调整和观测计数器绑定着看,才能避免「TW 数量吓人但其实无害」与「应用已经报错却还在调内核阈值」两类误判。
六、三个 sysctl 的机理与实测角色
实验动过三个内核参数,各自的作用层级不同,放在一张表里对照,避免把「调了参数」误当成「解决了问题」。
| 参数 | 默认值(本机) | 作用层 | 实验中的角色 |
|---|---|---|---|
ip_local_port_range | 32768–60999(28232 个) | 临时端口选取范围 | 压到 40000–41499(1500 个)制造端口稀缺,直接决定池子上限 |
tcp_max_tw_buckets | 4096 | 全局 TIME_WAIT 数量闸 | 守卫用例保持默认,观察溢出回收;正式对照抬到 200000 让 TW 真正留存 |
tcp_tw_reuse | 2(仅 loopback 可复用) | 四元组复用条件 | 0 完全禁止复用,1 允许满足时间戳与年龄条件的 TW 被新连接接管 |
三者的依赖关系要分清:tcp_max_tw_buckets 是数量闸,触发时内核的处理方式是直接回收最旧的 TW,应用无感知,nstat 的 TCPTimeWaitOverflow 计数是唯一证据;ip_local_port_range 是空间闸,触发时 connect() 明确返回 EADDRNOTAVAIL,错误直接冒泡到应用;tcp_tw_reuse 不改变任何一个闸的阈值,只改变空间闸判定「这个四元组能不能提前再用」。实验脚本把三个参数的原始值都记进日志、退出时 trap 还原,就是为了保证每一轮对照只改一个变量,归因不被残留配置污染。
nginx/ab 组的速率数据也能侧面印证关闭方归属:守卫用例 4 万请求跑到 17796 req/s,窄端口段三轮仍有 15737–17404 req/s,速率没有因为端口段缩小而塌陷——如果客户端临时端口真的在积累 TIME_WAIT,速率会在建连阶段就断崖式下跌。速率平稳加 ss 里 TIME_WAIT 恒定在 750 左右,两条证据共同指向「TW 不在客户端侧累积」。
七、建连本身的成本:ab 百分位曲线说了什么
端口账之外,短连接的另一项代价是每条连接都要重走一遍 TCP 三次握手。ab 的 -e 选项输出每个百分位上的完整请求耗时(含建连、请求、响应与关闭),取 nginx/ab 组第一轮对照:宽端口段 baseline 的 p50 是 7.320 ms、p99 是 9.468 ms、最大值 15.222 ms;窄端口段 squeezed 的 p50 是 7.454 ms、p99 抬到 16.528 ms、最大值 30.686 ms。
| 指标 | baseline(28232 端口) | squeezed(1500 端口,未耗尽) |
|---|---|---|
| p50 | 7.320 ms | 7.454 ms |
| p90 | 7.817 ms | 11.270 ms |
| p99 | 9.468 ms | 16.528 ms |
| 最大值 | 15.222 ms | 30.686 ms |
两条曲线的中位数几乎重合,说明 loopback 上单次握手的固定成本稳定在 7 毫秒量级;差距全部集中在尾部,squeezed 的 p99 慢了 75%,因为内核在缩小的端口段里找可用四元组要遍历更多占用项,TIME_WAIT 哈希桶的冲突概率也随之上升。这组数字解释了生产环境的一个常见现象:短连接服务在端口真正耗尽之前,尾延迟会先劣化,监控上先看到 p99 抬升、后看到连接错误。把短连接换成连接池后,握手成本从「每条请求一次」摊薄到「每条池连接一次」,这正是长尾收敛的主要来源。
八、复现要点与适用范围
两组实验都在同一台 2 vCPU/8 GiB 云主机的 loopback 上完成,选择 loopback 是为了排除丢包、拥塞控制与网卡中断的干扰,让关闭方归属和端口账单独暴露。代价是结论不能直接外推到跨机长肥网络:真实链路里 RTT、NAT 网关的端口映射、对端主机的 tw 回收策略都会改变建连速率,但「主动关闭方承担 TW、四元组唯一性决定端口上限」这两条内核机制不变。复现时注意脚本会临时修改三个 sysctl 并在退出时 trap 还原,实验机器不要同时跑其他依赖这些参数的服务。
第二个上限的联动同样要纳入检查清单:服务端每个连接要持有文件描述符到 500 毫秒延迟关闭结束,按峰值速率估算突发期并发存活连接约 800 个,距本机 1024 的 ulimit -n 只剩约 20% 余量;本次实测没有触顶,EMFILE 只作为代码里的防御分支存在,但在更高并发或更小 ulimit 的环境里它会先于端口耗尽爆发。这说明端口耗尽很少孤立出现,临时端口、文件描述符、连接跟踪表(conntrack)三类资源会在同一波短连接风暴里同时逼近上限。落地排查时可以按固定顺序核对:先 ss -ant state time-wait | wc -l 看 TW 总量,再对照 sysctl ip_local_port_range 算出端口空间,然后 nstat -az | grep -i overflow 确认内核有没有静默回收,最后 ulimit -n 与 ss -s 的 estab 数核对 fd 余量。四步走完,资源瓶颈落在哪一层就没有歧义。
这一篇在知识体系里的位置
协议机制承接 TCP TIME_WAIT 原理、影响与处理方法,建连在内核里的排队路径见 listen 队列与半连接/全连接内核机制,全部网络参数的调优入口汇总在 Linux 内核网络参数调优,高并发下的服务端形态见高并发服务器模型。
实验环境
- 机器/系统:腾讯云 2 vCPU / 8 GiB 竞价实例,Ubuntu 22.04.5 LTS,内核 5.15.0-190-generic,loopback
- 工具版本:nginx 1.18.0、ApacheBench 2.3、gcc 11.4.0;nstat 取自 iproute2 工具集
- 日期:2026-11-17
- 完整命令序列:
sudo -E bash bench.sh      # nginx/ab 四用例,含守卫与 nstat 快照
sudo -E bash run-tw.sh # C 最小 client/server 三用例,客户端主动关闭代码获取:两组实验的完整脚本、C 源码与原始日志见公开仓库 derekzhuo/geek-doc.cn 的 experiments/linux-tcp-connect-cost-timewait/。克隆后 sudo -E bash bench.sh 与 sudo -E bash run-tw.sh 可分别复现,百分位 CSV 与全量输出在 results/ 目录。
总结
TIME_WAIT 只消耗主动关闭方的端口资源,nginx/ab 栈里服务端先关,加上 tcp_max_tw_buckets 的溢出回收(实测单轮静默销毁 25196 个 TW),应用层始终零失败;把关闭方换成客户端、抬高 bucket 并把端口段压到 1500 后,成功数恰好停在 1500、其余全部 EADDRNOTAVAIL,而 tw_reuse=1 因 TW 年龄限制只把成功率从 7.5% 救到 20.0%,匀速流量有效、秒级突发不够用。