RPS RFS XPS 软中断分流:单队列网卡靠内核软件能救回多少
虚拟机里最常见的网卡形态是这样的:ethtool -l 看到 combined 队列上限只有 2,甚至只有 1,硬件 RSS 多队列:RPS/RFS/XPS 的硬件对应物想开也开不出来。于是收包硬中断、NAPI 轮询、协议栈软中断全部挤在 CPU0 上,mpstat 里一个核 %soft 飙到七成以上,另一个核全程围观。RPS、RFS、XPS 是内核为这种场景准备的软件分流手段——网卡硬件不支持多队列没关系,内核在协议栈入口自己做一次分发。它们的配置入口与 Linux 内核网络参数调优里的 RSS/offload 参数并列,报文从网卡到套接字的完整路径则可以对照套接字在内核中的收包机制阅读。本篇用一台 2 vCPU 云主机上的四组实测回答:软件分流到底能救回多少软中断瓶颈,代价又是什么。
本文要回答的问题
- 单队列网卡的软中断瓶颈在收包路径的哪一环,为什么 CPU1 完全帮不上忙?
- RPS、RFS、XPS 三个名字只差一个字母,各自改动了路径上的哪一段?
- 把
rps_cpus指向 CPU1 之后,硬中断和软中断的归属分别发生什么变化? /proc/net/softnet_stat在 5.15 内核上有 13 个字段,确认软件分流生效该看哪一列?- 软件分流是免费的提速手段吗,什么情况下它反而让吞吐下降?
一、单队列瓶颈:硬中断不排队,排队的是软中断
先把单队列收包路径走一遍。网卡只有一个 RX 队列、一个中断向量,所有入向报文的硬中断都投递到同一个 CPU(默认 CPU0)。硬中断本身只做最轻的动作:确认中断、调度 NAPI。真正的重活——从 virtio 环形缓冲取包、走协议栈、送到套接字接收队列——全部发生在硬中断退出后的 NET_RX 软中断里。单队列模式下这一步也在 CPU0 上执行,CPU1 自始至终没有任何网络软中断可处理。
读这张图抓住一个分界:红色节点是单核瓶颈所在,但瓶颈不在硬中断——硬中断很短,真正吃掉 CPU 的是后面的 NET_RX 软中断。灰色的 CPU1 不是不想帮忙,而是单队列路径里根本没有通向它的边。软件分流要造的,正是这样一条边。
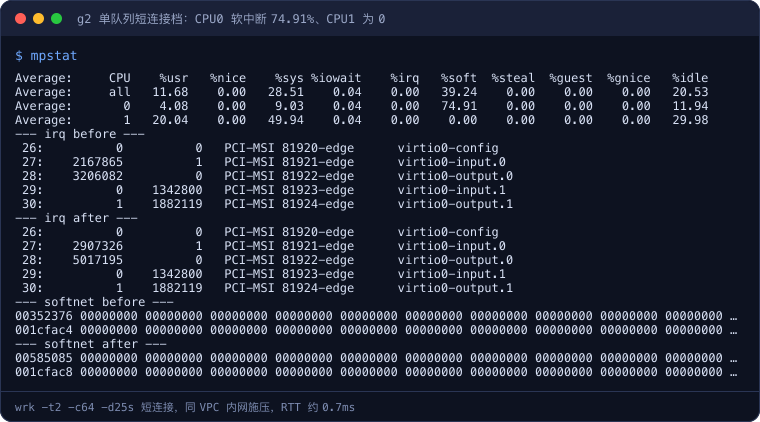
短连接压测下这个形态的数据非常刺眼。单队列不分流组(后文 g2)跑 25 秒 wrk -c64 -H "Connection: close",mpstat 均值里 CPU0 的 %soft 是 74.91%,CPU1 是 0.00%;同时 /proc/interrupts 里 virtio0-input.0 在 CPU0 上净增 739461 次,CPU1 一列原地不动。注意这一轮没有任何丢包,应用层 60 万请求全部成功——瓶颈的表现先是单核饱和风险,而不是立刻报错。
二、RPS、RFS、XPS 各自动了路径上的哪一环
三个机制都靠 sysfs/sysctl 配置,但作用位置完全不同,先给一张总览,再逐个拆。
| 机制 | 全称与方向 | 配置入口 | 动了路径的哪一段 |
|---|---|---|---|
| RPS | Receive Packet Steering,收方向 | rx-N/rps_cpus(CPU 位图) | NAPI 取包后、进入协议栈前,按报文哈希把 skb 投递到目标 CPU 的 backlog |
| RFS | Receive Flow Steering,收方向 | net.core.rps_sock_flow_entries + rx-N/rps_flow_cnt | 在 RPS 之上按流表把报文导向消费该套接字的应用所在 CPU,改善缓存局部性 |
| XPS | Transmit Packet Steering,发方向 | tx-N/xps_cpus(CPU 位图) | 规定哪些 CPU 可以向指定发送队列入队,减少 TX 环形锁争用 |
RPS 的机制是理解后两者的基础。CPU0 的 NAPI 轮询取出报文后,不再就地交给本机软中断,而是对四元组做哈希选出目标 CPU,把 skb 挂到目标 CPU 的 per-CPU backlog 队列,再发一个处理器间中断(IPI)唤醒对端的 NET_RX 软中断。于是协议栈处理被搬到了目标 CPU 上。
这张流程图的关键是红色留痕节点:RPS 是纯软件机制,网卡硬件一无所知,所以硬中断归属纹丝不动,被搬走的只有软中断。蓝色是本机动作,紫色是选核判定,橙色的跨核入队加 IPI 就是软件分流的固定成本来源,绿色节点才是被解放出来的第二个核。
RFS 解决的是 RPS 的一个副作用:哈希只保证同一条流总去同一个 CPU,却不保证那个 CPU 上正好跑着消费套接字的应用线程。应用在 CPU0 收包、软中断在 CPU1 处理,数据刚热起来的缓存又要跨核搬一次。RFS 维护两张表:全局的 rps_sock_flow_entries 记录应用在 recvmsg/sendmsg 时声明的期望 CPU,每队列的 rps_flow_cnt 记录每条流当前被导向的 CPU;报文到达时先查流表,命中就送往应用所在核,未命中再退回 RPS 哈希。XPS 则是发送侧的对称设计,只影响哪个 CPU 能向 TX 队列入队,不收包、不动软中断,本篇实验保持驱动默认值,不作为变量。
三、实验设计:四组配置只改一个变量
实验机是一台 2 vCPU/8 GiB 的 KVM 云主机,Intel Xeon Platinum 8374C,Ubuntu 22.04,内核 5.15.0-190,virtio-net 的 combined 队列上限恰好为 2。同 VPC 内网的第二台机器跑 wrk 施压,内网 RTT 约 0.7ms,本机 nginx 1.18.0 在 8080 端口返回一个 225 字节的小文件。四组配置通过同一个 group.sh 切换,每组跑两种负载:keep-alive(wrk -t2 -c128 -d25s)与短连接(-t2 -c64 -d25s -H "Connection: close"),单队列两组再加 c256/c128 的高压复核,共 12 轮,每轮 25 秒。
| 组别 | 队列配置 | RPS/RFS 参数 | 想验证的问题 |
|---|---|---|---|
| g1-rss2 | combined=2 硬件双队列 | 全 0 | 硬件 RSS 基线,软中断天然均摊 |
| g2-single | combined=1 单队列 | 全 0 | 不分流时单核瓶颈的真实形态 |
| g3-rps | combined=1 单队列 | rps_cpus=2(位图指向 CPU1) | 纯 RPS 能摊走多少软中断 |
| g4-rfs | combined=1 单队列 | g3 基础上加 rps_sock_flow_entries=32768、rps_flow_cnt=4096 | RFS 流表导向的增量价值 |
配置切换动作在每轮压测前执行并留痕,下面的终端记录是 g3 组的配置快照:单队列、rps_cpus 为 2、流表关闭,变量边界一目了然。
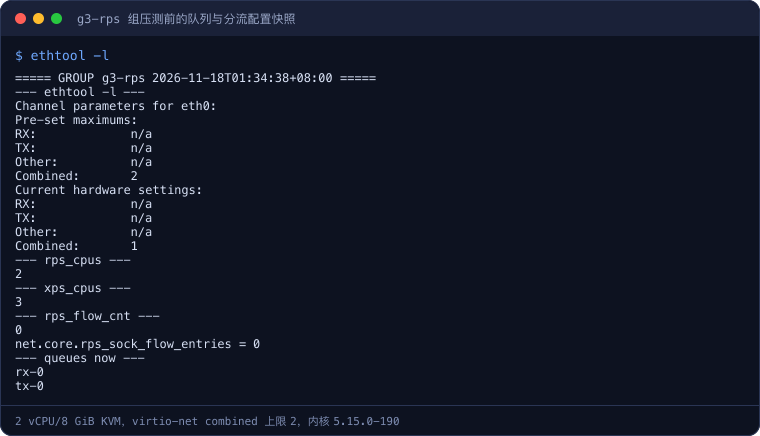
每轮压测期间,采样脚本同时记录四份证据:mpstat 25 秒逐秒均值与汇总、/proc/interrupts 前后快照、/proc/net/softnet_stat 前后快照、ss -s 套接字盘点。wrk 输出单独落盘。这样每个结论都有两类以上独立计数器交叉印证,而不是只看一个吞吐数字。
四、实测:74.91% 的单核软中断怎样被摊开
先看最有冲击力的对照——同样是短连接压力,关闭与打开 RPS 时两个核的处境。
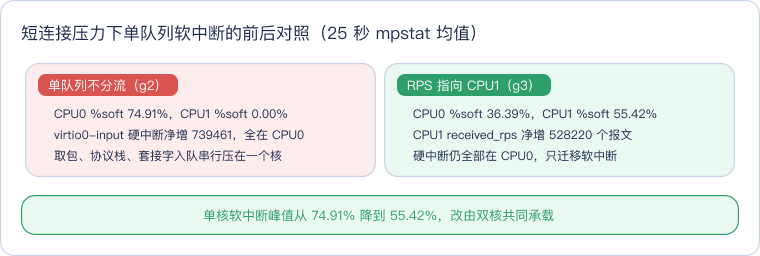
卡片里的数字全部来自原始采样。g2 组的完整记录如下,注意 mpstat 均值行与中断快照的对应关系。
四组 12 轮的汇总数据画在下面。左图是短连接档两个核各自的 %soft,右图是两种负载下的 wrk 吞吐,柱顶数字是 25 秒稳态均值。
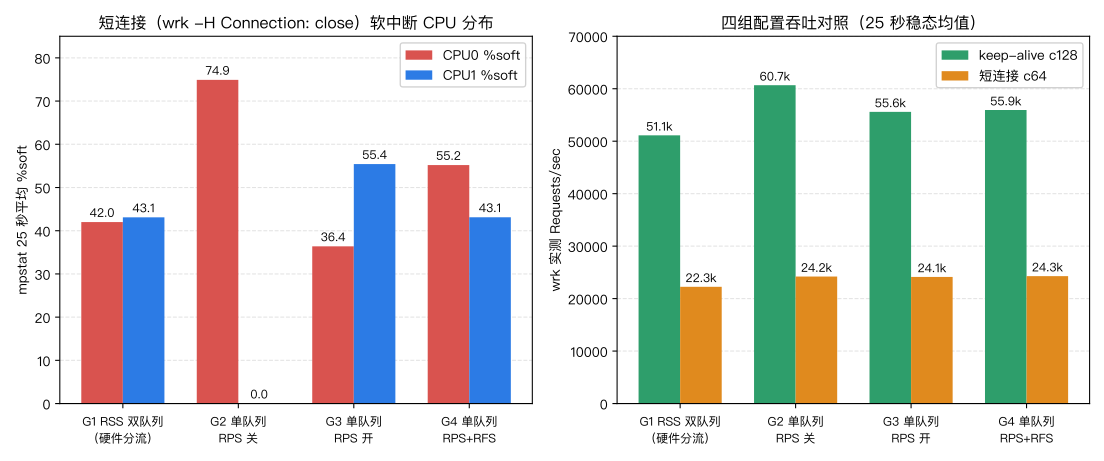
读这张图分左右看。左图中 g2 的红柱顶到 74.91%、蓝柱为 0,是典型的单核形态;g3 两根柱变成 36.39% 与 55.42,g4 变成 55.20 与 43.12,软中断确实被摊到了两个核。右图则给出反直觉的部分:短连接四组吞吐都在 24k RPS 上下,几乎没有区别;keep-alive 档 g2 反而最高(60668 RPS),g3、g4 只有 55588、55942 RPS。软件分流不是免费午餐,下一节专门算这笔账。
| 组别/负载 | RPS | p99 延迟 | CPU0 %soft | CPU1 %soft | softnet 丢包 |
|---|---|---|---|---|---|
| g1-rss2 / keep-alive | 51125 | 14.09 ms | 17.91 | 18.46 | 0 |
| g1-rss2 / 短连接 | 22258 | 4.66 ms | 42.00 | 43.09 | 0 |
| g2-single / keep-alive | 60668 | 4.82 ms | 35.28 | 0.00 | 0 |
| g2-single / 短连接 | 24205 | 4.65 ms | 74.91 | 0.00 | 0 |
| g3-rps / keep-alive | 55588 | 4.78 ms | 29.53 | 18.77 | 0 |
| g3-rps / 短连接 | 24138 | 4.22 ms | 36.39 | 55.42 | 0 |
| g4-rfs / keep-alive | 55942 | 4.52 ms | 34.91 | 13.79 | 0 |
| g4-rfs / 短连接 | 24290 | 4.16 ms | 55.20 | 43.12 | 0 |
12 轮的完整汇总同时呈现在终端总览里,包含每组 RPS、p99、双核软中断占比、硬中断增量与丢包结论。
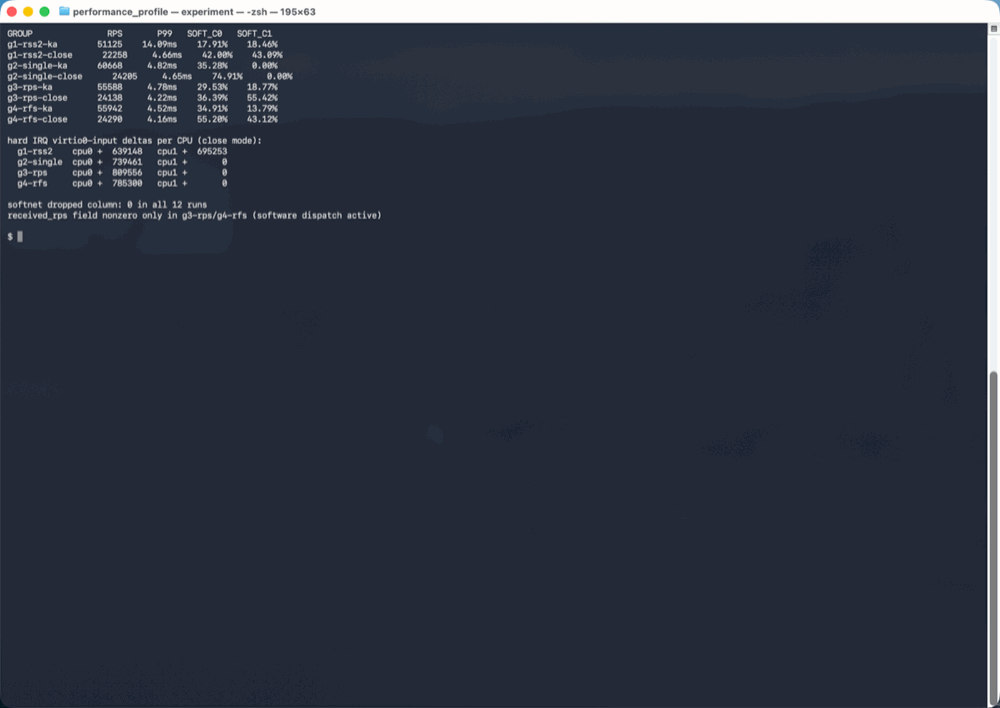
图中 hard IRQ 一段值得单独强调:g2/g3/g4 三个单队列组的 virtio0-input 增量全部挂在 CPU0 一列(739461、809556、785300),CPU1 恒为 0;只有 g1 硬件双队列组才出现 CPU0 与 CPU1 各约 64 万、70 万的对称分布。这正是第二节那张流程图的实测证据——RPS 改变软中断归属,改变不了硬中断归属。
五、softnet_stat 的字段陷阱:13 列里认哪两列
确认 RPS 生效不能只靠 mpstat,最直接的证据在 /proc/net/softnet_stat。这个文件每个 CPU 一行,每行是一串十六进制计数,但字段数随内核版本变化:老内核常见 9 列,本机 5.15 是 13 列,网上很多教程的列号已经对不上。本次实测反复用到的是两列:第 2 列是该 CPU 的 backlog 丢包数(dropped),第 10 列(索引 9)是经 RPS 分发到该 CPU 的报文数(received_rps)。
| 列号(5.15,共 13 列) | 含义 | 本实验中的读法 |
|---|---|---|
| 第 1 列 | 该 CPU 处理的网络报文总数 | 随负载单调增长,两组差值对照处理量 |
| 第 2 列 | backlog 满导致的丢包 | 12 轮全程为 0,是「未触发丢包」的硬证据 |
| 第 3 列 | time_squeeze,预算用尽让出次数 | 辅助判断软中断预算压力 |
| 第 10 列 | received_rps,软件分流来的报文 | g3/g4 非零且只在目标 CPU 上增长 |
| 其余列 | backlog 长度、flow limit 等扩展计数 | 版本间布局差异最大,不要按老教程数列号 |
g3 短连接档 CPU1 行的前后快照如下,第 10 列从 000d16d2 涨到 0015262e。
--- softnet before (g3-rps close, CPU1 行) ---
00331249 00000000 00000000 00000000 00000000 00000000 00000000 00000000 00000000 000d16d2 00000000 00000000 00000001
--- softnet after  (g3-rps close, CPU1 行) ---
0055b2a8 00000000 00000000 00000000 00000000 00000000 00000000 00000000 00000000 0015262e 00000000 00000001 00000001
两个十六进制数的差是 0x80f5c,换算成十进制正好 528220,与汇总表里 CPU1 的 received_rps 净增完全一致。g4 组同样位置从 002022bc 涨到 0028e106,差值 573002。而 g1、g2 两组该列全程为 0——硬件 RSS 不走软件分流,单队列关闭 RPS 也没有跨核投递,计数器诚实地标记了机制是否真的在工作。排查时的判定顺序因此很清晰:先看第 2 列有没有丢包,再看目标 CPU 的第 10 列有没有增长,两列都是 0 而 %soft 仍然倾斜,说明配置根本没生效,而不是机制失效。
六、代价与边界:约 8% 的固定成本与选型决策
现在算右图那笔反直觉的账。keep-alive 档 g2 跑到 60668 RPS,g3 是 55588 RPS,g4 是 55942 RPS,软件分流两组比单队列低了 7.8% 到 8.4%,固定成本约 8%。成本构成在第二节的流程图里已经画明:每个被分流的报文都要多一次远端 backlog 入队、一次 IPI 以及一次跨核缓存迁移。长连接模式下报文量最大、单条流生命周期最长,这笔每报文固定开销被放大得最明显;短连接模式下建连与关闭本身占了大头,四组吞吐都收敛在 24k RPS 左右,差异被淹没。
高压复核进一步确认了这个判断。把 keep-alive 并发提到 c256 后,g2 仍有 60294 RPS,但 p99 从 4.82ms 恶化到 70.91ms;g3 为 55045 RPS、p99 80.75ms。短连接 c128 下 g2 的 CPU0 %soft 为 72.78%、g3 摊成 34.52% 与 52.05%,两组依旧零丢包。这说明两件事:其一,本机这档负载还没压到单队列的天花板,g2 的 CPU0 虽忙但仍有余量,所以分流只体现成本、体现不出收益;其二,RPS 的价值是抬高软中断天花板——把单核七成以上的占用压到最高 55% 量级,为流量继续增长留出余量,而不是在非饱和流量下免费提速。
RFS 的增量在本实验里同样温和:g4 相比 g3,短连接吞吐 24138 到 24290 RPS、keep-alive 55588 到 55942 RPS,差异在测量波动范围内,软中断分布反而更偏向 CPU0(55.20% 对 43.12%),因为流表把报文导向了应用线程实际所在的核。RFS 的缓存局部性收益要在应用线程做了 CPU 亲和绑定、套接字数量多且缓存敏感的大规格机器上才显著,2 vCPU 的小虚拟机上看不出差距是符合预期的。
由此可以给出选型顺序。能用硬件 RSS 就优先用硬件——它在网卡侧分流,不付 IPI 成本,但本次 g1 基线吞吐偏低(51125 RPS)、p99 偏高(14.09ms),说明在极小规格 virtio 环境里双队列的额外中断也有成本,物理网卡与大机器上的结论通常相反,不要把这台小机器的数字外推。硬件队列开不出来(队列上限 1、驱动不支持、虚拟网卡)才考虑 RPS,它是消除单核软中断瓶颈的标准软件手段;RFS 在 RPS 生效且应用做了绑核时再叠加;XPS 只解决发送侧锁争用,对收包软中断不均没有帮助,不要指望它解决本篇的问题。最后必须写明边界:本次 12 轮 softnet 丢包列全程为 0、wrk 零非 2xx 与零 socket error,证明的是「该负载下不分流也不丢包」,不能外推出「单队列永远不会丢包」——backlog 被打满时第 2 列计数会先涨起来,那才是天花板真正触顶的信号。
这一篇在知识体系里的位置
硬件分流的完整机制(哈希、间接表、MSI-X 中断向量以及与 RPS/RFS/XPS 的全线对比)见 RSS 网卡硬件多队列收包与流分发,中断投递与亲和性的底层原理见中断亲和性:把设备中断绑定到指定 CPU,日常排查 %soft 倾斜的工具用法见 mpstat 详解,全部网络参数的调优入口汇总在 Linux 内核网络参数调优,高并发下应用线程与软中断如何协同见高并发服务器模型。
实验环境
- 机器/系统:2 vCPU / 8 GiB KVM 云主机,Intel Xeon Platinum 8374C @ 2.70GHz,Ubuntu 22.04,内核 5.15.0-190-generic,virtio-net combined 队列上限 2;同 VPC 内网第二台竞价机运行 wrk 4.1.0,内网 RTT 约 0.7ms
- 工具版本:nginx 1.18.0(8080 端口,225 字节静态文件)、wrk 4.1.0、sysstat 12.5.2(mpstat)、iproute2(ss)
- 日期:2026-11-18
- 完整命令序列:
sudo bash group.sh g1-rss2      # 四组配置切换:g1-rss2 / g2-single / g3-rps / g4-rfs
bash run-all.sh                 # 每组 keep-alive 与短连接各 25 秒,共 8 轮
bash run-stress.sh # g2/g3 的 c256/c128 高压复核,共 4 轮代码获取:四组配置脚本、采样脚本与全部原始日志见公开仓库 derekzhuo/geek-doc.cn 的 experiments/linux-rps-rfs-xps-softirq/。克隆后先 sudo bash group.sh g3-rps 切到对应配置,再 bash run-all.sh 即可复现四组 25 秒对照,bash run-stress.sh 复现高压复核,12 轮汇总在 results.csv。
总结
单队列网卡的瓶颈是 NET_RX 软中断被硬中断归属锁死在 CPU0:短连接实测单核 %soft 达 74.91%、另一核为 0。RPS 在 NAPI 取包后用哈希加 backlog 入队把软中断搬到目标 CPU,实测摊成 36.39%/55.42%,softnet 第 10 列 received_rps 净增 528220 与计数器差值精确吻合,但硬中断仍 100% 留在 CPU0;RFS 再按流表导向应用所在核,XPS 只管发送侧。软件分流的代价是每报文一次 IPI 与跨核入队,keep-alive 吞吐下降约 8%,所以它的价值是抬高软中断天花板、消除单核瓶颈,而非非饱和流量下的免费提速;12 轮零丢包只说明本负载未触顶,backlog 丢包列开始增长才是真正的极限信号。