OpenCode 中文教程:从零安装到接入国产模型完成一次真实改码
OpenCode 是一个开源的终端式 AI 编程助手,形态上和 Claude Code、Codex CLI 是同一类东西:在项目目录里启动,带读写文件、执行命令的工具循环,可以交互式对话,也可以用 opencode run 一条命令跑完整个任务。它的一个现实特点是 provider 完全可配置——不绑定任何一家账号,任何兼容 OpenAI 或 Anthropic 协议的端点都能接进来。这意味着国内开发者不必折腾网络环境,用火山方舟 Coding Plan 这类国产模型服务就能驱动它。关于 Coding Plan 本身的开通和计费口径,可以先看火山引擎 Coding Plan 怎么用:5 分钟接入 Claude Code/Cline,套餐计费别踩坑。
这篇 OpenCode 中文教程按一次真实操作的顺序展开:安装、配置国产模型 provider、在一个带真实缺陷的 C 项目上用 headless 模式完成修 bug 加测试,最后做独立验证。整条路径的四个阶段先给一张总览卡,后面每一步都对应一节展开。
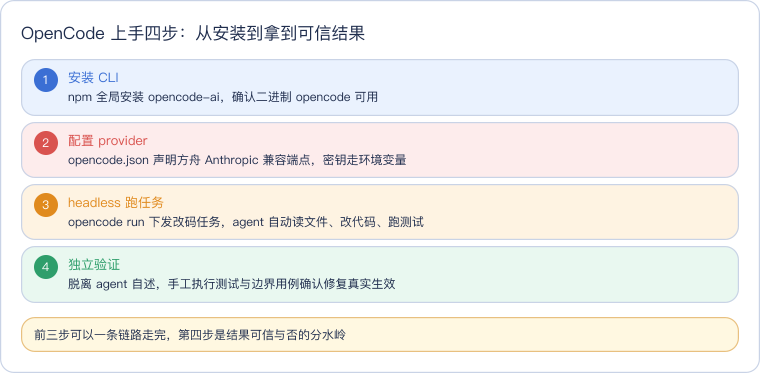
读这张卡注意第四步和前三步的性质差别:安装、配置、跑任务都是「让 agent 动起来」,独立验证则是「确认它真的做对了」。agent 自述「测试全部通过」不等于测试真的通过,这一点后文用实测输出展开。
本文要回答的问题
- OpenCode 的 npm 包名和二进制名为什么不一样,安装后命令找不到怎么办?
- 怎样用
opencode.json把火山方舟 Coding Plan 接成自定义 provider,baseURL 的/v1漏写会怎样? - 不进交互界面,怎样用
opencode run在 headless 模式下完成一次完整改码? - agent 自己跑的测试能不能直接信,独立验证应该怎么做?
- OpenCode 适合什么场景,和交互式编码助手相比边界在哪?
一、安装:包名、二进制名与 postinstall 两个坑
OpenCode 在 npm 上的包名是 opencode-ai,安装后落到系统里的二进制命令叫 opencode。这两个名字不一致是第一个坑:凭直觉执行 npm i opencode 会直接收到 E404,因为 npm 仓库里并没有 opencode 这个包。正确的安装命令是:
npm install -g opencode-ai
opencode --version
本文实测环境装出的版本是 1.19.5,opencode --version 原样打印版本号即说明二进制已经在 PATH 上。
第二个坑出在安装脚本。opencode-ai 的 npm 包带一个 postinstall 脚本,负责补齐平台相关的运行文件;如果你的 npm 全局配置忽略了安装脚本(不少人为了安全开过 ignore-scripts),安装过程本身不报错,但首次运行 opencode 时只会提示 postinstall script was not run。补救方式是进入包目录手动补跑一次,不用重新安装:
cd "$(npm root -g)/opencode-ai" && node postinstall.mjs补跑之后再执行 opencode --version,能正常出版本号就说明安装链路完整了。把这两个坑和后面的端点坑合在一起,文末有一张完整的对照表。
安装完先不急着启动。OpenCode 启动时会从当前项目目录读取 opencode.json,provider、模型、密钥引用都在这个文件里声明,所以下一步先把配置准备好。
二、配置 provider:把火山方舟接成 Anthropic 兼容端点
OpenCode 的 provider 抽象基于 AI SDK:一个 provider 声明由 npm 适配包、连接选项和模型列表三部分组成。火山方舟 Coding Plan 提供 Anthropic 兼容端点,因此适配包选 @ai-sdk/anthropic,OpenCode 会在首次使用时自动拉取这个包。整条请求路径和每个配置项的注入位置如下图。
读这张图抓住一条主线:opencode 进程本身不理解任何厂商协议,它只负责读取 opencode.json,把 baseURL 和密钥交给 @ai-sdk/anthropic 适配包,由适配包按 Anthropic Messages 协议发包;方舟端点收到请求后再按模型名路由到实际模型。客户端这一层对「后面是谁家的模型」完全透明,这也是为什么配置错的时候报错往往来自服务端而不是客户端。
下面是本次实测使用的完整配置,也是公开实验包里 demo/opencode.json 的原样内容:
{
  "$schema": "https://opencode.ai/config.json",
  "provider": {
    "ark": {
      "npm": "@ai-sdk/anthropic",
      "name": "火山方舟 Coding Plan",
      "options": {
        "baseURL": "https://ark.cn-beijing.volces.com/api/coding/v1",
        "apiKey": "{env:ARK_CODING_KEY}"
      },
      "models": {
        "ark-code-latest": {
          "name": "ark-code-latest"
        }
      }
    }
  },
  "model": "ark/ark-code-latest"
}三个字段值得单独说。npm 指向协议适配包,接 Anthropic 兼容端点就填 @ai-sdk/anthropic,接 OpenAI 兼容端点则换对应的 OpenAI 适配包。model 的写法是「provider 名/模型名」两级结构,这里的 ark/ark-code-latest 对应上面声明块的 key 和 models 里的模型 ID,会话顶部打印的 build · ark-code-latest 就是这个选择生效的证据。
最容易翻车的是 baseURL。Anthropic 适配包会在 baseURL 后面直接拼 /messages,所以 baseURL 必须完整带到 /v1:正确值是 https://ark.cn-beijing.volces.com/api/coding/v1。如果只填到 /api/coding,请求会打到一个不存在消息接口的路径上,网关可能返回 401 Unauthorized 或 404 Not Found 一类鉴权/路径错误(具体状态码以服务商网关实现为准)——表面看像鉴权失败,实际根因是路径少了一段,对着密钥排查只会越走越远。这和 Codex 自定义模型提供方:config.toml 接第三方与国产兼容端点的完整配置拓扑 里「404 查 base_url 是否少 /v1」是同一类问题,协议适配层的拼接规则各家 CLI 基本一致。
密钥这一行用的是 {env:ARK_CODING_KEY} 占位语法:OpenCode 运行时从环境变量 ARK_CODING_KEY 取值,密钥本体不写进配置文件。这样 opencode.json 可以放心进 git,机器上只需要 export 一次:
export ARK_CODING_KEY=你的方舟 Coding Plan API Key把密钥排除在版本库之外不是洁癖,而是底线——配置文件经常会随着 dotfiles、项目模板四处复制,环境变量注入让「可公开的配置」和「必须保密的凭据」天然分层。
三、任务准备:一个带两个真实缺陷的 C 程序
配置就绪后,需要一个任务来检验整条链路。本次用的是一个刻意保留缺陷的最小 C 项目 stats.c:从标准输入读整数,遇到 -1 结束,输出序列平均值。代码短到可以完整贴在这里:
#include <stdio.h>
#include <stdlib.h>

/* 读取一行整数,返回平均值;遇到 -1 结束(-1 不计入) */
double average_until_minus_one(void) {
    int x, sum = 0, n = 0;
    while (scanf("%d", &x) == 1) {
        if (x == -1)
            break;
        sum += x;
        n++;
    }
    return sum / n;
}

int main(void) {
    printf("avg=%.2f\n", average_until_minus_one());
    return 0;
}
两个缺陷都藏在最后一行 return sum / n; 上。第一,空序列场景下第一个输入就是 -1,循环一次都不执行,n 保持 0,整数除零是未定义行为,程序可能崩溃也可能吐出垃圾值。第二,sum 和 n 都是 int,整数除法会先截断再隐式转 double,输入 1 2 -1 时期望平均值 1.50,实际打印 1.00,和 %.2f 的两位小数承诺不符。此外项目没有任何测试,修复后是否正确全靠肉眼。
选这个任务是有意的:缺陷小而确定,修复方案唯一,适合用来检验 agent 的工具链是否通畅;但它又不是改个错别字——需要理解输入协议、识别未定义行为、区分整数除法和浮点除法,还要自己设计测试覆盖边界。任务说明写在同目录的 README 里,连同有缺陷的源码和配置模板一起交给 agent,不做额外口头提示。
四、headless 模式:一条命令跑完读码、改码与测试
OpenCode 的非交互入口是 opencode run "任务描述"。和交互式 TUI 相比,run 模式把整个 agent 循环——读文件、编辑、执行命令——在一次进程内跑完,把过程流式打印到标准输出,任务结束进程退出,退出码反映成败。这种形态适合挂到脚本和 CI 里,和 Codex headless 非交互:exec 模式、JSON 输出与 CI 集成实战 讲的 exec 模式定位相同;agent 内部「思考—调工具—观察结果」的循环机制,可以对照 Agent Loop 解剖:从 ReAct 到现代 coding agent 的消息生命周期。
本次下发的命令是:
opencode run "修复 stats.c 的两个缺陷并补测试"agent 的实际动作顺序在会话记录里很清楚:先读目录和 stats.c、README,定位到除法那一行;然后直接编辑源码,加空序列守卫并把除法改成浮点除法;接着新建 test.sh、加可执行权限并亲自跑了一遍。下面这张终端卡摘的是它执行测试和小数验证的关键段落。
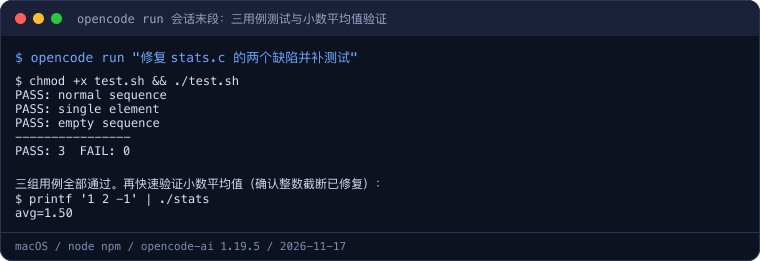
这张卡里有两组证据要分开看。PASS: normal sequence、PASS: single element、PASS: empty sequence 加上汇总行 PASS: 3 FAIL: 0,说明 agent 自己编写的三组用例——正常序列、单元素、空序列——全部通过,空序列除零缺陷已被守卫拦住;下面 printf '1 2 -1' | ./stats 输出 avg=1.50,说明整数截断也修好了。它对源码的实际改动是两行:循环后先判断 if (n == 0) return 0.0;,返回值改为 (double)sum / n,强制按浮点除法求值。
同一次会话在终端窗口里的完整面貌如下,上半部分是它读文件和编辑 stats.c 的 diff,下半部分是新建测试脚本与执行结果,整个进程以 EXIT=0 收尾。
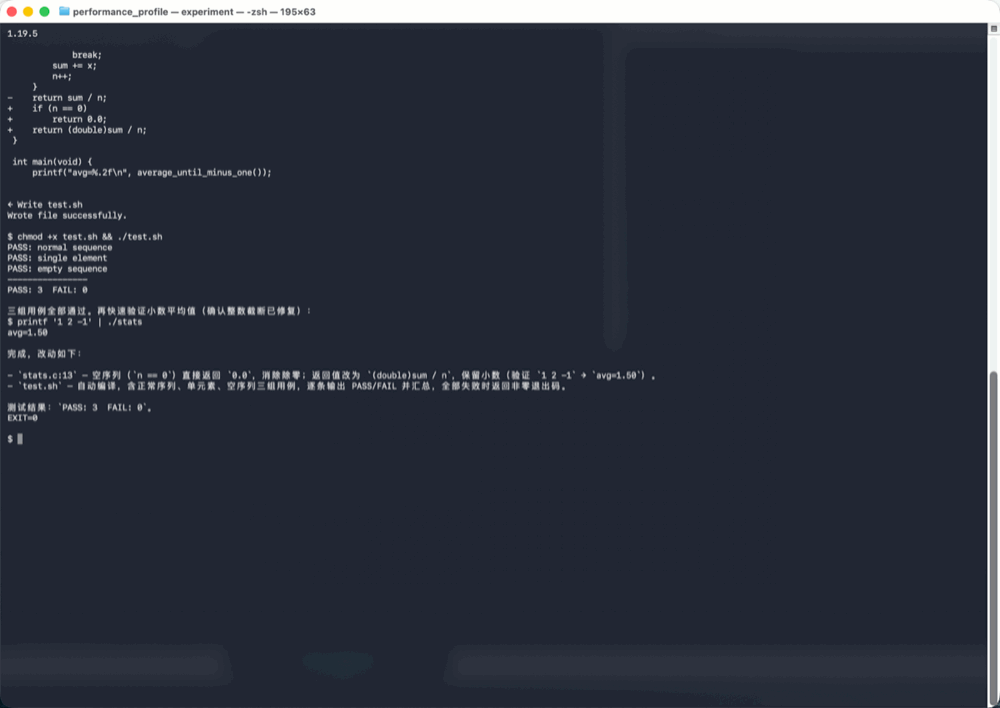
看这张图时重点对照 diff 和测试的因果关系:diff 里的 n == 0 守卫对应 empty sequence 用例,(double) 强制转换对应 avg=1.50 的小数验证——每一处改动都有测试承接,没有为了凑绿灯写无效断言。agent 新建的 test.sh 还约定了退出码语义:三组用例全过才返回 0,任何一条 FAIL 都会让脚本以非零码退出,这使它可以直接被外部脚本或 CI 当作判据使用。
五、独立验证:为什么不能只信 agent 自述
会话记录里 agent 自己已经跑过测试,为什么还要再验证一遍?因为 agent 报告结果和结果真实成立之间,隔着好几层可能失真的环节:它可能误读了命令输出,测试本身可能断言写错(测的是错误行为也会全绿),它展示的输出和磁盘上的最终文件也可能不一致。agent 的工具系统本身是可靠的机制,但单次会话的结论必须由会话外的证据兜底,工具调用的回流机制可以参考 function calling 工具系统:从 JSON Schema 校验到并发与错误回流。
本次的独立验证完全在 agent 进程之外做,在全新 shell 里手工执行三条边界命令,再跑一次 agent 写的测试脚本:
printf '1 2 -1' | ./stats        # 期望 avg=1.50
printf -- '-1' | ./stats         # 期望 avg=0.00
printf '10 20 30 40 -1' | ./stats  # 期望 avg=25.00
./test.sh                        # 期望 PASS: 3  FAIL: 0,退出码 0
第一条针对整数截断:两个整数平均值 1.5,如果截断缺陷还在会打印 1.00,实测输出 avg=1.50。第二条针对除零:输入只有结束标记,计数为 0,旧程序在此处是未定义行为,修复版按守卫约定返回 0.0,实测输出 avg=0.00。第三条用四个整数核对浮点求和路径没有引入新的精度问题,实测输出 avg=25.00。最后单独执行 ./test.sh,确认退出码为 0 且汇总行仍是 PASS: 3 FAIL: 0。四组证据和会话内输出一致,才算这次改码真正成立。
这轮复测在全新 shell、脱离 opencode 进程的目录里执行,完整原始记录如下(含编译器版本、test.sh 退出码与三个边界用例,额外补了一组四元素平均值核对浮点求和):
== independent verification of agent-produced fix ==
date: 2026-11-17 02:34:38 CST
host: Darwin 25.5.0 x86_64
Apple clang version 21.0.0 (clang-2100.1.1.101)

--- step1: run agent-written test.sh in a fresh shell ---
PASS: normal sequence
PASS: single element
PASS: empty sequence
----------------
PASS: 3  FAIL: 0
test.sh exit=0

--- step2: out-of-process boundary checks (not part of agent session) ---
avg=1.50
rc=0
avg=0.00
rc=0
avg=25.00
rc=0这里有个细节值得学:printf -- '-1' 里的 -- 不是可有可无的。部分 shell 内置的 printf 会把以 - 开头的参数当成选项,-- 用来明确告知选项结束,参数从这里开始。agent 写出的测试脚本里统一用 printf '%s' 规避了这个问题,手工验证时则靠 -- 兜底——两种写法都是为了让「-1」被老老实实当作数据。
把这套验证纪律一般化,判断 agent 干活是否可信有三个层次:最低层是听它复述(不可信),中间层是看它会话内的命令输出(基本可信但要防自证循环),最高层是在进程外用独立设计的用例复测。本次两个手工用例故意和 test.sh 的输入错开(test.sh 用 1 2 3 -1 和 5 -1,手工用 1 2 -1 和纯 -1),就是为了避免「用同一批数据证明同一批数据」。
六、适用边界:OpenCode 适合什么,不适合什么
经过这一轮实测,可以给 OpenCode 画一条比较清晰的适用边界。
它的强项首先是 provider 中立。opencode.json 一个文件就能把请求指到任意 Anthropic 或 OpenAI 兼容端点,密钥走环境变量,换模型只改配置不动工作流;对国内团队来说,直接接火山方舟这类国产端点意味着没有网络门槛,成本走国内套餐计费,数据链路也在境内。其次是 headless 形态完整:opencode run 一条命令带退出码,天然适合塞进 CI 做定时修 issue、批量重构、依赖升级这类无人值守任务,需要 MCP 扩展工具面时也有标准配置位,MCP 本身解决什么问题可先读 MCP 协议:Agent 怎么跟外部工具打交道,具体接法可对照 Codex MCP 支持:接入 MCP server 的配置与工具暴露全解 理解同类设计。
边界同样明确。第一,项目级配置文件和 AI SDK 适配包的引入,让它比零配置工具多一层前期概念,第一次上手必须理解 provider、适配包、baseURL 拼接这三件事,否则三个坑(包名、postinstall、/v1)一个都躲不过。第二,headless 模式没有人工审批环节,agent 在任务目录里的编辑和命令执行是连续发生的,生产仓库使用时要靠目录隔离、git 快照和分支机制兜底,不能在主工作区裸跑。第三,模型能力完全由你接的端点决定,OpenCode 只提供代理骨架——接到小模型上,工具调用稳定性和长任务规划能力会明显下降,这不是客户端配置能弥补的。
最后把全程踩过和预判到的坑汇成一张表,排错时按症状对号入座。
| 症状 | 根因 | 处理 |
|---|---|---|
npm i opencode 报 E404 | npm 包名是 opencode-ai,opencode 只是二进制名 | 改用 npm install -g opencode-ai |
| 运行提示 postinstall script was not run | npm 全局忽略安装脚本,平台文件未补齐 | 进包目录手动 node postinstall.mjs |
| 请求返回 401/404 一类鉴权或路径错误 | baseURL 只填到 /api/coding,适配包拼出错误路径(状态码随网关实现) | baseURL 完整写到 /api/coding/v1 |
| 密钥随配置泄露进仓库 | 把密钥明文写进了 opencode.json | 改用 {env:ARK_CODING_KEY} 环境变量注入 |
| 会话里模型名不对或找不到模型 | model 的两级名与 provider 声明块对不上 | 核对 model 与 provider key、models 下的 ID 完全一致 |
| agent 自述通过但复测失败 | 自证循环或测试断言本身写错 | 进程外用错开的独立用例复测,以退出码为准 |
实验环境
- 机器/系统:Mac(Intel x86_64)/ macOS 25(Darwin 25.5.0),复测编译器 Apple clang 21.0.0
- 工具版本:opencode-ai 1.19.5(二进制
opencode),node/npm 全局安装 - 模型端点:火山方舟 Coding Plan,Anthropic 兼容端点,模型 ark-code-latest
- 日期:2026-11-17
- 完整命令序列:
npm install -g opencode-ai
opencode --version
mkdir oc-demo && cd oc-demo
cp 实验包/demo/buggy-stats.c stats.c
cp 实验包/demo/README.md .
cp 实验包/demo/opencode.json .
export ARK_CODING_KEY=你的方舟 Coding Plan API Key
opencode run "修复 stats.c 的两个缺陷并补测试"
# 进程外独立复测(新建目录,把修复版存为 stats.c)
bash ./test.sh
printf '1 2 -1' | ./stats
printf -- '-1' | ./stats代码获取:带缺陷的示例程序、provider 配置模板与 agent 实际产出的修复版和测试见公开仓库 derekzhuo/geek-doc.cn 的 experiments/opencode-getting-started/。按 README 即可复现整轮会话。
这一篇在知识体系里的位置
这篇属于「编码代理上手与横评」线,解决的是一个具体工具从零到跑通真实任务的完整路径。往上走,代理为什么能自己读文件、改代码、跑命令,机制层在 Agent Loop 解剖:从 ReAct 到现代 coding agent 的消息生命周期 和 function calling 工具系统:从 JSON Schema 校验到并发与错误回流;横向看,headless 非交互模式的 CI 玩法在 Codex headless 非交互:exec 模式、JSON 输出与 CI 集成实战,第三方端点接入的通用拓扑在 Codex 自定义模型提供方:config.toml 接第三方与国产兼容端点的完整配置拓扑,国产模型套餐本身的开通与计费在 火山引擎 Coding Plan 怎么用:5 分钟接入 Claude Code/Cline,套餐计费别踩坑。读完这篇再看上述文章,工具差异之下的共同骨架会清晰很多。
总结
这条 OpenCode 中文教程路线可以压缩成四句话:安装认准 npm 包名 opencode-ai,postinstall 被跳过就手动补跑;provider 在 opencode.json 里声明,接火山方舟用 @ai-sdk/anthropic 适配包,baseURL 必须带 /v1、密钥用 {env:ARK_CODING_KEY} 走环境变量;改码任务用 opencode run 一条命令 headless 完成,过程留痕、退出码可判;结果可信性靠进程外的独立用例复测兜底,agent 自述只能当线索不能当结论。本次实测中,含除零与整数截断两个缺陷的 stats.c 被修复为带空序列守卫的浮点除法实现,三用例测试 PASS: 3 FAIL: 0,边界手工验证 avg=1.50 与 avg=0.00 均符合预期。