G1 收集器:Region 与回收过程
更新时间:2026-09-18。G1(Garbage-First)是 JDK 9 起的默认收集器,面向多核、大堆、对停顿有要求的服务端应用。前置知识:JVM 运行时内存与堆分代。
一、核心思想:Region 化 + 收益优先
传统收集器里新生代、老年代是物理上连续的两大块;G1 把整个堆划分为约 2048 个(1~32MB)大小相等的 Region,每个 Region 同一时刻扮演一种角色,且角色可随回收动态改变:
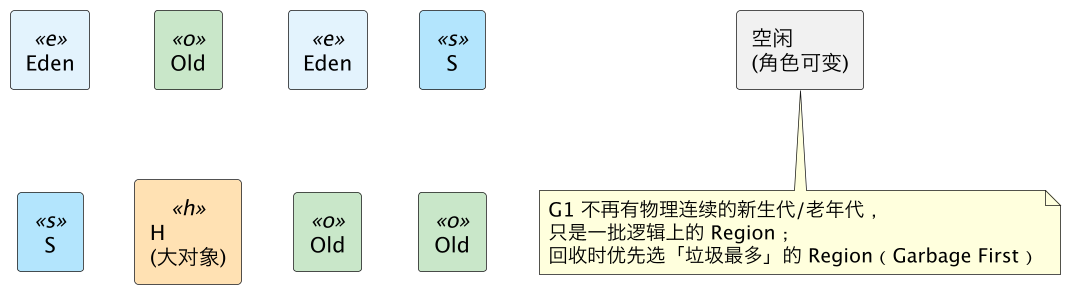
- Garbage-First:每次回收都优先选择垃圾占比最高、回收收益最大的 Region,在限定停顿预算内回收最多空间。
- Humongous(超大对象):大小超过 Region 一半的对象视为巨型对象,独占一个或多个连续 Region(标记 H),专门管理以避免大对象在新生代反复复制。
二、关键数据结构:RSet 与 CSet
| 结构 | 作用 |
|---|---|
| Remembered Set(RSet) | 每个 Region 一个,记录「谁引用了我」(point-into)。回收某 Region 时不必全堆扫描引用,只查它的 RSet,代价是占用额外内存(典型 ≤5% 堆)。 |
| Collection Set(CSet) | 本次 GC 要回收的 Region 集合。Young GC 只放新生代 Region;Mixed GC 再加上部分高收益老年代 Region。 |
| Card Table | 辅助维护跨代/跨 Region 引用的脏卡,是 RSet 的底层更新依据。 |
三、回收过程:Young GC 与 Mixed GC
3.1 Young GC(全程 STW,多线程复制)
1. 选定若干 Eden + Survivor Region 组成 CSet
2. 借助各 Region 的 RSet 找出指向 CSet 的根/引用
3. 把 CSet 中存活对象复制到空 Region(成为新 Survivor,年龄够则晋升 Old)
4. 原 Eden Region 整体清空归还
G1 的新生代大小不是固定的,它会根据停顿目标动态调整 Eden/Survivor 的 Region 数量——这是它和传统分代很不一样的地方。
3.2 并发标记周期 + Mixed GC
当老年代占用超过 -XX:InitiatingHeapOccupancyPercent(IHOP,默认 45%)时,启动并发标记:
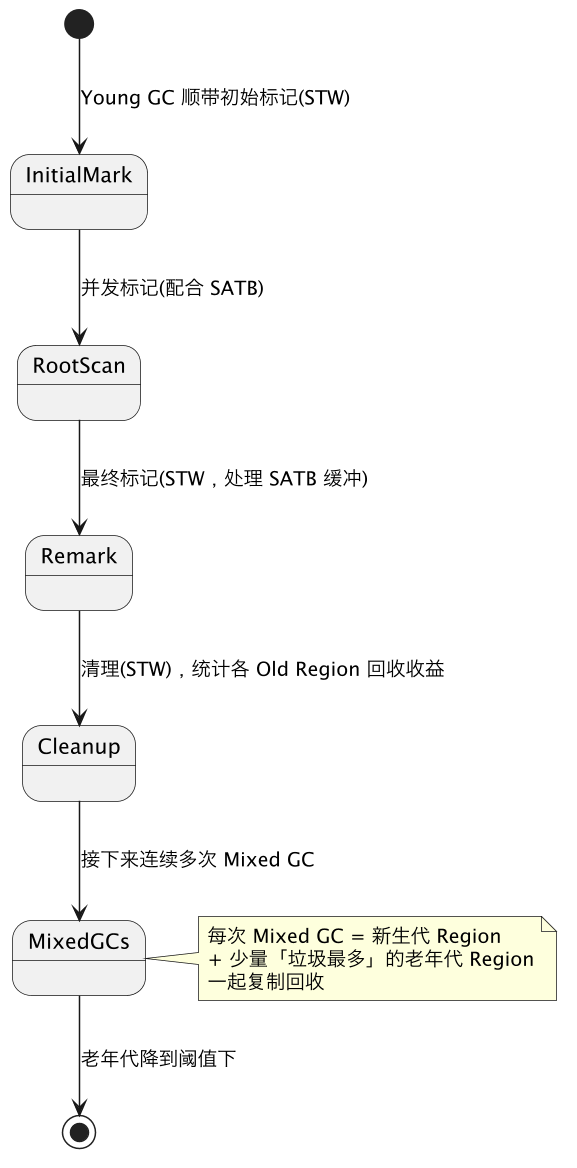
- SATB(Snapshot-At-The-Beginning):并发标记期间用「原始快照」保证不漏标,写屏障记录被覆盖的引用;可能产生少量「浮动垃圾」,留到下次回收。
- Mixed GC:并发标记后,G1 连续进行多次 Mixed GC,每次在停顿预算内回收新生代 + 一部分(
G1MixedGCLiveThresholdPercent控制的)高收益老年代 Region,把老年代逐步「挤」下去。
四、可预测停顿模型及其代价
-XX:MaxGCPauseMillis=200 是 G1 的核心目标:它根据每个 Region 的历史回收耗时和存活数据,建一个「回收收益—耗时」模型,在目标停顿内挑尽量多的高收益 Region。
代价与边界:
- 它是「尽量满足」的目标,不是硬保证;Region 太大、存活对象太多时仍可能超。
- 设得过小(如 20ms)→ 每次回收的 Region 少,老年代回收速度跟不上分配速度,可能退化成 Full GC(单线程、非常慢)。
- 官方建议 G1 适用堆 6GB 以上、停顿目标 200ms 上下;很小的堆用 Parallel/其他收集器反而更省。
五、常用参数与建议
-XX:+UseG1GC
-XX:MaxGCPauseMillis=200          # 停顿目标,别盲目调小
-XX:G1HeapRegionSize=16m          # Region 大小(1~32MB,2 的幂),一般让 JVM 自动算
-XX:InitiatingHeapOccupancyPercent=45   # 老年代占用触发并发标记
-XX:ConcGCThreads=4 -XX:ParallelGCThreads=16
官方对 JDK 8u40 之后的 G1 的首要建议是:先不要手工调新生代大小(-Xmn、NewRatio),否则会破坏 G1 基于停顿目标的自适应;只调堆大小和停顿目标,出问题再看 GC 日志精细调。
六、常见坑
- 堆很小还硬上 G1:Region 数量不足、RSet 占比高,吞吐反而不如 Parallel GC;小堆别追时髦。
- 把停顿目标调到 10~20ms:回收速度 < 分配速度,老年代涨满触发兜底 Full GC(G1 的 Full GC 是单线程标记-整理,停顿极长)。
- 手工固定
-Xmn:锁死新生代后 G1 无法按收益动态选 Region,可预测停顿优势失效。 - Humongous 分配频繁:超大数组/缓存对象可能直接触发并发标记甚至碎片问题;应排查业务里的巨型对象,或适当调大 Region,使对象不超过 Region 一半。
- 只看 GC 频率不看 GC 日志阶段:要分清是 Young GC 变慢(存活对象多)、Mixed GC 回收不足,还是升级成 Full GC,再对症调 IHOP / 存活率阈值。
与上一代低停顿收集器 CMS 的逐点对比见 G1 与 CMS 的区别;分代基础见 JVM 运行时内存与堆分代;更低延迟的 ZGC/Shenandoah 见站点 JVM 内存主题。
总结
G1 把堆切成大量等大、角色(Eden/Survivor/Old/Humongous)可动态变化的 Region,用 RSet 记录跨 Region 引用来避免全堆扫描、用 CSet 圈定每次回收范围;Young GC 全程 STW 复制回收新生代,老年代占用过 IHOP 后走「初始标记—并发标记(SATB)—Remark—Cleanup」并紧跟多次 Mixed GC,每次在 MaxGCPauseMillis 预算内优先回收垃圾最多的 Region,从而实现可预测停顿;关键是别在小堆上用、别把停顿目标设太小(否则退化为单线程 Full GC)、一般不要手工固定新生代大小,并警惕 Humongous 大对象。