HashMap 底层原理与扩容/红黑树
更新时间:2026-09-18。HashMap 是 Java 最高频的集合考点,核心是理解它如何用「数组 + 链表/红黑树」在 O(1) 与冲突之间平衡。
一、整体结构
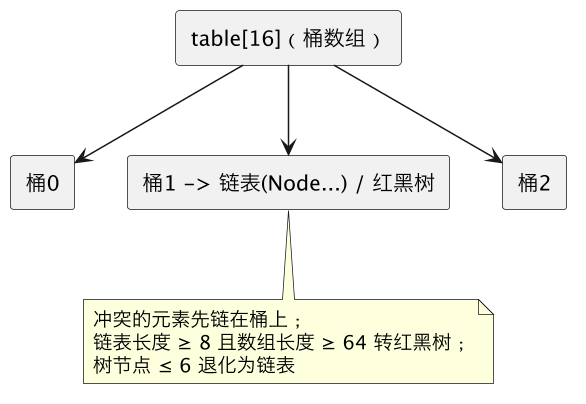
JDK 8 的 HashMap 是 数组(桶)+ 链表 + 红黑树:
- 默认初始容量
16,负载因子0.75,阈值 = 容量 × 负载因子。 - 容量总是 2 的幂,为的是用位运算
(n-1) & hash代替取模定位下标。
二、put 全流程
bash
1. 对 key 算 hashCode,再做扰动:h ^= h >>> 16(高低位混合,减少碰撞)
2. 下标 i = (n - 1) & h
3. 桶为空 → 直接放入
4. 桶非空:
   - 首个 key 相等(hash + equals)→ 覆盖 value
   - 是树节点 → 走红黑树插入
   - 否则遍历链表:相等则覆盖;走到尾部插入,并判断长度 ≥ 8 则树化
5. 元素数 > 阈值 → resize() 扩容为 2 倍
为什么链表树化要同时要求数组长度 ≥64?长度小时优先扩容(让桶更分散)而不是树化,兼顾性能。
三、扩容机制
- 容量翻倍(16→32),元素重分布。
- 2 倍扩容的优化:扩容后下标只可能是「原下标」或「原下标 + 旧容量」,由 hash 新增的那一位决定,无需每个元素重新取模。
- 扩容是 HashMap 最大的一次性开销,已知元素数量时预设容量可避免多次扩容。
java
// 预估要放 N 个元素,容量设为 N/0.75 向上取 2 的幂;或用 Guava
Map<String,Integer> m = new HashMap<>(expectedSize / 3 * 4 + 1);
四、线程安全与常见坑
| 坑 | 说明 |
|---|---|
| 多线程下用 HashMap | put/扩容并发会丢数据、结构错乱(JDK7 头插法扩容还可能形成环形链表导致 get 死循环)。并发用 ConcurrentHashMap |
| 用可变对象当 key | 放入后字段变化导致 hash 改变、再也 get 不到;用不可变类型(String/包装类) |
| 不重写 equals/hashCode | 自定义 key 必须保证二者一致(相同对象相同 hash) |
| 不预设容量 | 大数据量反复扩容,性能抖动 |
| 负载因子乱调 | 调小→冲突少但更占空间、扩容频繁;调大→省空间但冲突多变慢,一般保持 0.75 |
五、相关结构选型
- 需要线程安全:
ConcurrentHashMap(分段/CAS+synchronized,不允许 null)。 - 需要有序/遍历按插入序:
LinkedHashMap(还可实现 LRU)。 - 需要排序:
TreeMap(红黑树,按 key 可比/比较器)。
总结
JDK8 HashMap 用容量为 2 的幂的桶数组加链表加红黑树实现:key 经高低位扰动后用 (n-1)&hash 定位,冲突先挂链表、链表长度到 8 且数组长度到 64 转红黑树、节点降到 6 退化,元素超过容量×0.75 时翻倍扩容并利用新增高位把元素分到原位或原位加旧容量;多线程下它不安全(JDK7 甚至扩容成环致死循环),并发要用 ConcurrentHashMap,使用上要给已知数据量预设容量避免频繁扩容、用不可变 key 并正确重写 equals/hashCode、负载因子保持 0.75,需要有序或排序改用 LinkedHashMap/TreeMap。