G1 与 CMS 的区别
更新时间:2026-09-18。CMS 是 G1 之前的低停顿老年代收集器,JDK 9 被标记废弃、JDK 14 正式移除。理解两者差异,既为读懂老系统的 GC 日志,也为做升级决策。前置:G1 收集器 Region 与回收过程、JVM 堆分代。
一、CMS 是怎么工作的
CMS(Concurrent Mark Sweep)只回收老年代,目标是降低停顿,四个阶段:
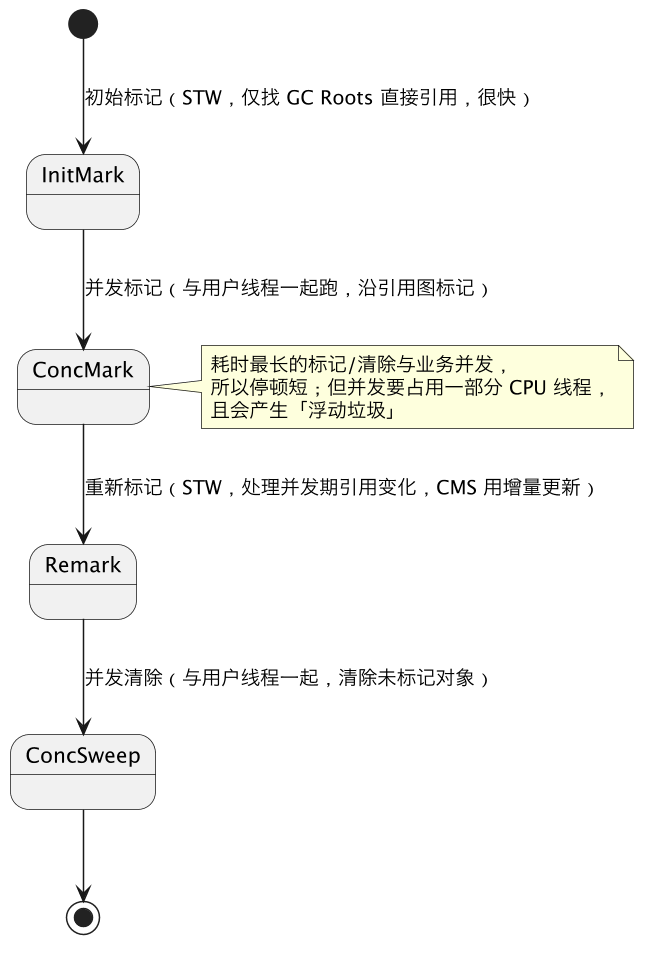
因为用标记-清除算法(不整理、不移动存活对象),它有三个绕不开的问题:
- 内存碎片:清除后留下零散空洞,长期运行出现「总空闲够、但没有连续空间放对象」。
- 浮动垃圾:并发清除阶段新产生的垃圾本次收不掉,要等下一轮。
- Concurrent Mode Failure:因为清除是并发的,必须在老年代还没满时就启动(受
CMSWaitDuration/占用阈值控制);若回收速度跟不上分配、老年代提前填满,发生并发失败,退化成 Serial Old 单线程标记-整理,触发一次超长 Full GC。
二、逐项对比
| 维度 | CMS | G1 |
|---|---|---|
| 回收范围 | 只回收老年代(新生代配 ParNew) | 新生代 + 老年代统一管理 |
| 内存布局 | 物理连续的新生代/老年代 | 约 2048 个等大 Region,角色动态 |
| 回收算法 | 标记-清除(不移动) | 新生代复制、老年代整体标记-整理(Region 间复制) |
| 内存碎片 | 有,长期运行碎片化严重 | 基本无(复制即压缩) |
| 停顿控制 | 只尽量短,不可预测 | -XX:MaxGCPauseMillis 可预测停顿模型 |
| 浮动垃圾 | 增量更新方案,浮动垃圾较多 | SATB 原始快照,仍有浮动垃圾但回收更可控 |
| 并发失败兜底 | Concurrent Mode Failure → Serial Old 单线程 Full GC | 分配失败也会 Full GC(标记-整理),但自适应触发 Mixed GC 尽量规避 |
| 内存开销 | 较小(Card Table) | 较大:每个 Region 有 RSet,典型占堆 ≤5%~10% |
| CPU 开销 | 并发阶段占线程 | 维护 RSet(写后屏障)开销更高 |
| 大对象 | 直接进老年代,加剧碎片 | Humongous Region 专门管理 |
| 调参 | 参数多、依赖经验调阈值 | 主要调堆和停顿目标,自适应程度高 |
| JDK 状态 | JDK 9 废弃,JDK 14 移除 | JDK 9+ 默认,持续增强 |
三、停顿与碎片的权衡(最本质区别)
- CMS 用「不移动对象」换并发低停顿,代价是碎片——碎片 + 浮动垃圾积累到临界点,一次 Concurrent Mode Failure 带来的 Serial Old 长停顿,往往就是压垮老系统的直接原因(表现为隔几小时/几天一次的 RT 尖刺)。
- G1 用 Region 间复制存活对象的方式在回收时顺带做了局部压缩,从根本上避免碎片;代价是复制开销和 RSet 的内存/CPU 成本。它不追求单次最短,而追求「在目标停顿时间内回收收益最大」。
四、选型建议
| 场景 | 建议 |
|---|---|
| JDK 8、堆 4~6GB 以下、追求吞吐 | Parallel GC 或维持 CMS,未必需要 G1 |
| JDK 8、堆 6GB+、要求低停顿且被 CMS 碎片/并发失败困扰 | 迁移 G1 |
| JDK 9+ 新系统 | 默认 G1,一般无需指定 |
| 超大堆(几十 GB)、要求亚毫秒~个位数毫秒停顿 | 评估 ZGC / Shenandoah,而非只在 CMS/G1 间选 |
| 遗留 JDK 8 + CMS 老系统 | 重点监控老年代碎片与 Concurrent Mode Failure,规划升级 |
五、从 CMS 迁到 G1 的常见坑
- 以为参数能直接照搬:
UseConcMarkSweepGC、NewRatio、UseParNewGC等 CMS 参数对 G1 无效;迁移时应先删掉大部分手工调参,只保留堆大小和停顿目标,让 G1 自适应,再依据 GC 日志微调。 - 沿用固定新生代
-Xmn:会锁死 G1 的 Region 动态选择,使其退化成「类似分代收集器」,丧失可预测停顿优势。 - 堆太小:G1 的 RSet 需要内存,堆 < 4~6GB 时收益不明显,小堆迁移要先压测。
- 停顿目标照抄期望:直接填 20~50ms 易导致回收速度跟不上、退化为 Full GC;建议从默认/200ms 起步,结合日志逐步收紧。
- 只比平均停顿,不比 P99 和故障停顿:CMS 平时短但偶发 Serial Old 长停顿,G1 更平稳;评估要看 P99/P999 和定时尖刺,而不是平均值。
G1 的 Region、SATB、Mixed GC 细节见 G1 收集器 Region 与回收过程;分代与 Full GC 概念见 JVM 运行时内存与堆分代。
总结
CMS 是只回收老年代、用标记-清除追求并发低停顿的收集器,代价是内存碎片、浮动垃圾和回收跟不上时退化成单线程 Serial Old 的 Concurrent Mode Failure;G1 用等大可动态变角色的 Region 统一管理新老年代、用复制/标记-整理在回收时压缩碎片,并靠 RSet 和可预测停顿模型在 MaxGCPauseMillis 预算内优先回收垃圾最多的 Region,代价是更高的内存(RSet)和写屏障开销;选型上 JDK9+ 默认且 6GB 以上大堆选 G1、小堆追吞吐可留 Parallel、超大堆追超低延迟再看 ZGC/Shenandoah,从 CMS 迁移要删旧参数、别固定新生代、停顿目标从 200ms 起步并以 P99 而非平均值评估。