QEMU tap 桥接:用 Linux bridge 与 dnsmasq 给客户机做二层联网
前面两篇网络文章都建立在 QEMU 默认的 SLIRP 用户网络上:QEMU SLIRP 用户网络:一条 -netdev user 跑通上网 讲客户机怎么靠 QEMU 进程内的 NAT 出网,QEMU hostfwd 端口转发:SLIRP 网络下把主机端口映射进客户机 讲主机怎么把端口转发进 NAT 后面的客户机。这套方案零配置、不要 root,但客户机永远只有 10.0.2.15 这个进程内地址,主机和局域网无法直接路由到它,所有流量还要在用户态协议栈里绕一圈。本篇换一条轨道:用 QEMU tap 桥接,让客户机通过真实的虚拟网卡接入 Linux bridge,像一台物理机一样走 DHCP、拿地址、经主机转发上网。
实验在一台 RISC-V virt 虚拟平台上完成,但 tap 与 bridge 是 Linux 内核网络栈的能力,与客户机 CPU 架构无关,x86 客户机的组网命令完全相同。如果你对虚拟机、镜像这些基础概念还陌生,可以先读 认识 QEMU:从零看懂虚拟机、镜像与快照。
本文要回答的问题
- SLIRP 用户网络用得好好的,什么场景下必须换成 tap 桥接,两者的性能与可达性差在哪?
- br0、tap0、dnsmasq、MASQUERADE 四个部件各自负责什么,缺了其中一个客户机会表现成什么样?
- 为什么 NAT 规则配好了,客户机却只能 ping 通网关、访问公网百分百丢包?
- dnsmasq 日志里的 DHCP 四次交换 DISCOVER、OFFER、REQUEST、ACK 分别携带了什么信息?
- 客户机网卡一直 DOWN、根本不发 DHCP 请求,问题出在主机还是客户机自己?
一、SLIRP 的边界:什么时候必须上桥接
SLIRP 的本质是 QEMU 在用户态进程里模拟一整套网络栈:客户机看到的网卡连到进程内的虚拟交换机,出口流量由进程做源地址转换后借用主机套接字发出。它带来两个结构性限制。第一是地址不可路由:10.0.2.0/24 只存在于 QEMU 进程内部,主机路由表里没有这个网段,外部想访问客户机只能靠 hostfwd 一条条端口映射,开一台客户机就要维护一份转发清单。第二是用户态搬运开销:每个包都要在客户机虚拟网卡、QEMU 用户态栈、主机内核栈之间多次拷贝与上下文切换,跑吞吐型负载时损耗明显。
tap 桥接把这两个限制一起解开。tap 是内核提供的三层虚拟网卡:一端是内核里的网络接口,另一端以文件描述符形式交给 QEMU 进程,客户机发出的以太网帧直接写进内核,不再经过用户态协议栈翻译。把 tap 接口挂到 Linux bridge 上,客户机就等同于把网线插进了一台真实交换机的端口,可以广播、可以跑 DHCP、可以被同网桥的其他接口直接二层寻址。再由主机承担路由器角色:网桥接口当网关,dnsmasq 发地址,iptables 负责转发与源地址转换。代价是配置需要 root、部件更多,而且每一处漏配都有截然不同的症状——这正是本篇用两轮对照实验要钉牢的部分。
| 对比维度 | SLIRP 用户网络 | tap 桥接网络 |
|---|---|---|
| 客户机地址 | 固定 10.0.2.15,进程内可见 | DHCP 分配的真实网段地址,主机可直达 |
| 外部访问客户机 | 只能 hostfwd 端口映射 | 同二层直接寻址,跨网段靠主机路由 |
| 数据通路 | 用户态协议栈翻译,多次拷贝 | 内核 tap 直入 bridge,无用户态翻译 |
| 权限要求 | 普通用户即可 | 建网桥、配 NAT 需要 root |
| 配套部件 | QEMU 自带,零外部依赖 | bridge-utils/ip、dnsmasq、iptables |
| 适用场景 | 快速验证、单机临时上网 | 多机互联、服务对外、性能与长期实验 |
二、四件套拓扑:一台虚拟交换机加一台虚拟路由器
本篇实验台的地址规划是固定的:实验网段 10.88.0.0/24,网桥接口 br0 占据网关地址 10.88.0.1/24,dnsmasq 的分配池是 10.88.0.50 到 10.88.0.150,租期 12 小时。主机的物理出口网卡 eth0 不挂进网桥——网桥只连接 tap 侧,客户机出公网走三层转发加源地址转换,这样实验网段与主机所在的上游网络完全隔离,不会向上游广播伪造 DHCP。
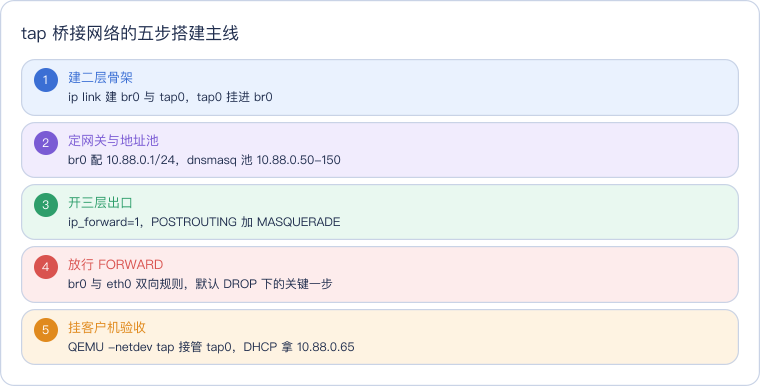
这张流程卡是全篇的主线,建议先记住第四步的位置:它在多数教程里被一句「开启转发」带过,却是本次实验第一轮失败的根因。下面的拓扑图把五个步骤落到具体部件上,读图时沿着客户机帧的流向走。
图中蓝色是流量起点客户机,灰色的 tap0 与公网是纯通道角色,紫色 br0 是二层核心兼网关,绿色 dnsmasq 只处理 DHCP 与 DNS,橙色 netfilter 决定跨网段报文的生死与地址转换。注意 dnsmasq 与 br0 之间是同网段查询,不经过转发链;而客户机访问公网的报文必须离开网桥、进入主机协议栈,因此要同时过 FORWARD 链与 POSTROUTING 链两道关。这两条路径的区分,是理解后面两轮实验的钥匙。
三、主机侧搭建:网桥、tap、NAT 与独立 dnsmasq
搭建动作全部在主机侧完成,脚本的顺序与流程卡一一对应。先建 br0 与 tap0,tap0 的属主设为运行 QEMU 的普通用户,这样 QEMU 可以直接以文件描述符方式接管它,启动参数里才能写 script=no,downscript=no,免去传统的 /etc/qemu-ifup 脚本。接着给 br0 配网关地址、打开 ip_forward、在 POSTROUTING 链追加针对 10.88.0.0/24 的 MASQUERADE 规则。
dnsmasq 这一部件有两个讲究。其一,Ubuntu 系统自带的 dnsmasq 服务可能处于 enabled 但未运行的状态,而 53 端口还被 systemd-resolved 占着 127.0.0.53,直接起系统服务会冲突;做法是用 --conf-file 指定独立配置、配合 bind-dynamic 只绑定 br0,与系统解析器井水不犯河水。其二,配置里把网关与 DNS 都通过 DHCP 选项下发为 10.88.0.1,客户机拿到地址的同时就学齐了默认路由与 DNS。下面是搭建过程的完整实录。
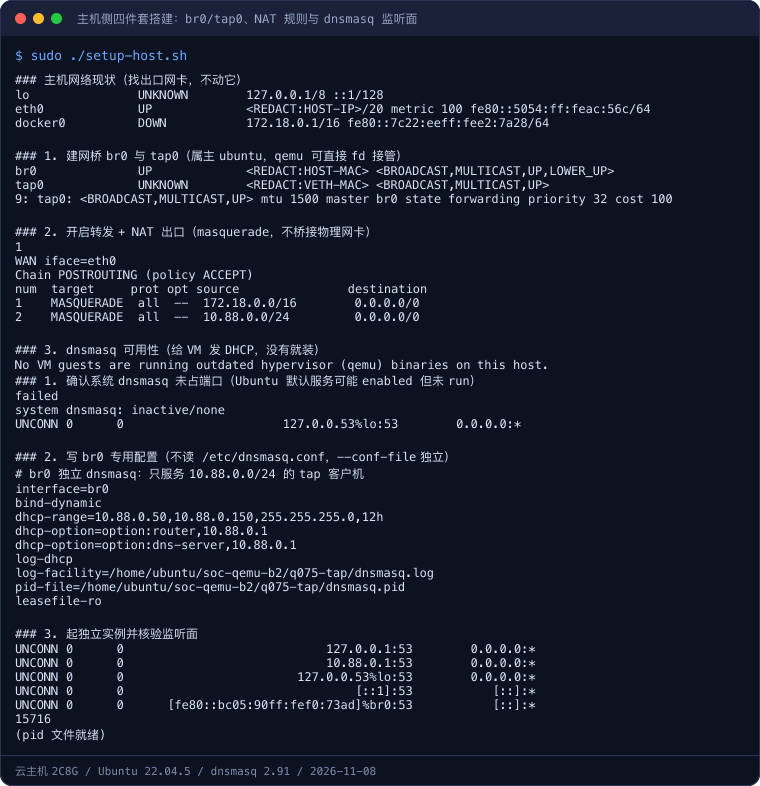
实录前三段给出主机网络现状与建桥结果:eth0 是出口网卡,全程不动它;br0 与 tap0 都进入 UP 状态,master br0 state forwarding 一行说明 tap0 已经成为网桥的转发端口。NAT 段可以看到 POSTROUTING 链里并存两条 MASQUERADE,一条是 Docker 自己的 172.18.0.0/16,另一条就是本次新增的 10.88.0.0/24,按源网段区分、互不干扰。dnsmasq 段最值得看的是末尾的监听面:127.0.0.53:53 属于 systemd-resolved 原样保留,新增的 10.88.0.1:53 与 br0 链路本地地址上的 53 才是独立实例的监听口,pid 文件就绪表示实例已经常驻。
独立实例的配置文件很短,每个字段都有明确职责,贴出来便于对照自己的环境改写。
# br0 独立 dnsmasq:只服务 10.88.0.0/24 的 tap 客户机
interface=br0
bind-dynamic
dhcp-range=10.88.0.50,10.88.0.150,255.255.255.0,12h
dhcp-option=option:router,10.88.0.1
dhcp-option=option:dns-server,10.88.0.1
log-dhcp
log-facility=/tmp/dnsmasq-br0.log
pid-file=/tmp/dnsmasq-br0.pid
leasefile-ro
interface=br0 加 bind-dynamic 把服务面锁死在网桥上,即使主机后来新增网卡也不会误发地址;leasefile-ro 让实例以只读租约模式运行,实验环境重启后重新分配,避免残留旧租约。QEMU 侧的启动参数则把网络设备从 user 模式换成 tap 模式,客户机 MAC 固定为 52:54:00:10:88:01,便于在 dnsmasq 日志里按地址追踪。
qemu-system-riscv64 \
  -machine virt -m 2048 -smp 2 -nographic \
  -bios /usr/lib/riscv64-linux-gnu/opensbi/generic/fw_jump.bin \
  -kernel vmlinuz-7.0.0-38-generic -initrd initrd.img \
  -append "root=LABEL=cloudimg-rootfs ro console=ttyS0" \
  -drive file=noble-riscv64.img,if=virtio,format=qcow2 \
  -netdev tap,id=n0,ifname=tap0,script=no,downscript=no \
  -device virtio-net-pci,netdev=n0,mac=52:54:00:10:88:01
四、DHCP 四次交换:客户机怎么拿到 10.88.0.65
客户机内核识别出 virtio 网卡并命名为 enp0s1 后,networkd 发出第一个 DHCPDISCOVER 广播。由于 br0 是真正的二层交换机,这个广播帧到达 tap0 后被洪泛给网桥所有端口,dnsmasq 在 br0 上收到它并应答。log-dhcp 把整个交换过程逐报文记录下来,这是排查「客户机拿不到地址」类问题最直接的证据源。
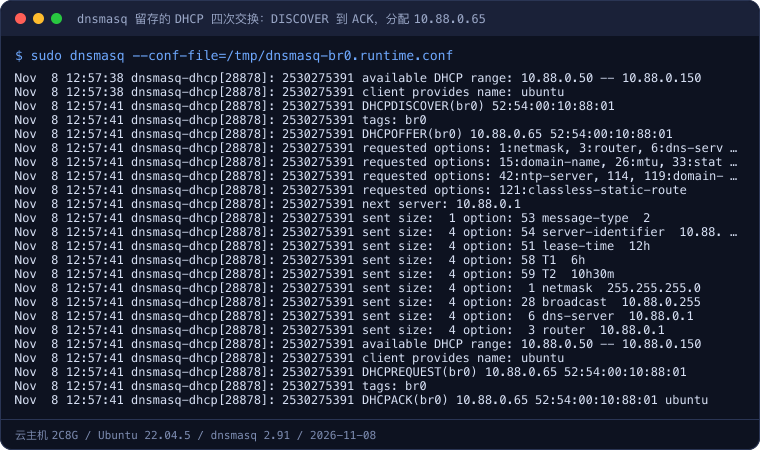
按时间顺序读这段日志。DHCPDISCOVER(br0) 52:54:00:10:88:01 是客户机的广播寻租,此时它还没有任何 IP;dnsmasq 从地址池挑出 10.88.0.65,发出 DHCPOFFER(br0) 10.88.0.65 要约,并在选项里附上子网掩码、租期 12 小时、T1/T2 续约时刻、网关与 DNS 都是 10.88.0.1。客户机确认接受后发 DHCPREQUEST(br0) 10.88.0.65,注意这一步报文已经带上了申请的地址;最后 DHCPACK(br0) 10.88.0.65 ... ubuntu 完成租约确认,日志尾部的 hostname ubuntu 是客户机在 DISCOVER 里主动提供的名字。
日志里还有一行容易被忽略的细节:客户机请求的选项清单包含 33:static-route、121:classless-static-route、42:ntp-server 等十几项,dnsmasq 只回复自己配置里有的几项。这解释了一个常见困惑——DHCP 不是「服务端发什么客户端收什么」,而是客户端先开清单、服务端按自己的能力应答。四次交换走完,客户机才会出现 default via 10.88.0.1 dev enp0s1 proto dhcp 这条默认路由,后面探针命令的输出可以验证它。
五、两轮对照实验:FORWARD 默认 DROP 卡住公网
主机搭建脚本第一次执行时刻意只做到 NAT:ip_forward 已开、MASQUERADE 已加,但没有补任何 FORWARD 规则。而这台主机的 filter 表 FORWARD 链默认策略是 DROP——云镜像与 Docker 环境普遍如此,Docker 安装时会把默认策略从 ACCEPT 改成 DROP。客户机启动、DHCP 正常拿到 10.88.0.65,然后在客户机里跑同一套网络探针:看地址路由、ping 网关、ping 公网 223.5.5.5、做一次 DNS 解析。第一轮结果如下。
PING 10.88.0.1 (10.88.0.1) 56(84) bytes of data.
64 bytes from 10.88.0.1: icmp_seq=1 ttl=64 time=1.68 ms
64 bytes from 10.88.0.1: icmp_seq=2 ttl=64 time=0.838 ms

--- 10.88.0.1 ping statistics ---
2 packets transmitted, 2 received, 0% packet loss, time 1003ms
rtt min/avg/max/mdev = 0.838/1.258/1.679/0.420 ms
---PING-WAN---
PING 223.5.5.5 (223.5.5.5) 56(84) bytes of data.

--- 223.5.5.5 ping statistics ---
2 packets transmitted, 0 received, 100% packet loss, time 1018ms
网关两发两中、零丢包,公网两发全丢、百分之百丢包。这个分裂现象恰好对应第二节拓扑里的两条路径:ping 网关是同网桥内的二层直达,报文不出 br0、不进 FORWARD 链,DROP 策略管不着;ping 公网要跨网段,报文离开 br0 进入协议栈后第一关就是 FORWARD 链,链上没有任何 ACCEPT 规则,默认 DROP 直接丢弃。MASQUERADE 挂在 POSTROUTING,报文根本走不到那一步。同理,DNS 解析之所以还能出结果,是因为探针里的 getent hosts archive.ubuntu.com 走到了 IPv6 与本地存根解析的路径,并不证明 IPv4 外网已通——判断连通性要以 WAN ping 为准,不能被一次成功的名字查询误导。
修复动作是在 FORWARD 链插入两条规则:出站方向放行 br0 到 eth0 的一切,入站方向只放行属于已有连接的回程报文,由 conntrack 关联。
# 出站:允许实验网段主动发起的转发
iptables -I FORWARD -i br0 -o eth0 -j ACCEPT
# 入站:只放回程,不允许外部主动发起新连接
iptables -I FORWARD -i eth0 -o br0 -m conntrack --ctstate RELATED,ESTABLISHED -j ACCEPT
两条规则的不对称是有意的:实验台只要求客户机主动出网,不对外暴露入站入口,因此入站方向限定 RELATED,ESTABLISHED。规则生效后重启客户机、跑完全相同的探针,第二轮结果如下。
PING 223.5.5.5 (223.5.5.5) 56(84) bytes of data.
64 bytes from 223.5.5.5: icmp_seq=1 ttl=250 time=8.38 ms
64 bytes from 223.5.5.5: icmp_seq=2 ttl=64 time=8.51 ms

--- 223.5.5.5 ping statistics ---
2 packets transmitted, 2 received, 0% packet loss, time 1003ms
rtt min/avg/max/mdev = 8.375/8.442/8.509/0.067 ms
同一个目标、同样两个包,从百分之百丢包变成零丢包,往返时延 8.4 毫秒左右、两次抖动不到 0.1 毫秒。收尾时的主机规则快照把最终状态固定下来:filter 表 -P FORWARD DROP 没变,靠的是两条显式 ACCEPT 兜底;nat 表的 MASQUERADE 限定 -o eth0,不会误伤网桥内部流量。
上面的终端实录把三个环节串在一起:上半段是主机侧 br0、tap0 与 dnsmasq 监听面的搭建输出,中段是 dnsmasq 日志里 DISCOVER、OFFER、REQUEST、ACK 四次交换以及分配出的 10.88.0.65,下半段左右并列两轮探针——左侧网关零丢包而公网百分之百丢包,右侧补上 FORWARD 规则后公网同样零丢包、回程 RTT 稳定在 8 毫秒量级。看这段对照时盯住一个对比:两轮之间 DHCP 地址、默认路由、网关连通性完全没有变化,唯一变量就是 FORWARD 链上的两条规则,这把「转发策略」与「地址配置」两类问题干净地切开了。
六、真实坑:cloud-init 失败时网卡根本不发 DISCOVER
FORWARD 的问题修好之前,还踩过一个位置更靠前的坑。第一次用下载的 Ubuntu cloud 镜像启动时,客户机里 enp0s1 一直处于 DOWN,探针输出里 ip -br addr 只看到 lo,ping 任何地址都直接报 Network is unreachable,主机 dnsmasq 日志里连一条 DISCOVER 都没有。桥是好的、tap 是好的、dnsmasq 也在监听,但客户端压根没开口,二层上一片寂静。
根因在客户机内部:cloud 镜像把网络配置全权交给 cloud-init,由它在首次启动时生成 /etc/netplan/ 下的配置;而本次直接用 -kernel 加 -initrd 引导、没有走 cloud-init 期望的元数据服务,cloud-init 失败后 netplan 目录保持为空,networkd 没有任何配置可应用,网卡自然永远 DOWN。修复不在主机侧,而是在镜像开机前预置一份最小 DHCP 配置,让 networkd 无条件管理所有 en 开头的网卡。
network:
  version: 2
  ethernets:
    all-eth:
      match:
        name: "en*"
      dhcp4: true
      optional: true
把这段内容写进镜像的 /etc/netplan/01-dhcp.yaml 并收紧权限到 600 后再次启动,enp0s1 立刻 UP,dnsmasq 日志随即出现完整的四次交换。optional: true 一并解决了另一个连带问题:默认配置下 systemd-networkd-wait-online 会因为等不到「全网卡在线」而卡住启动两分钟,标记可选后启动不再等待。这个坑的判定信号非常明确——dnsmasq 日志零 DISCOVER 且客户机网卡 DOWN,问题一定在客户机配置;日志里有 DISCOVER 但无 OFFER,才轮到主机侧查 dnsmasq 与网桥。
七、排错清单:按症状定位漏配的部件
四件套架构的好处是每个部件失效都有独特症状,顺着下表从二层往三层查,基本不会走弯路。
| 症状 | 失效部件 | 判定证据 | 处理 |
|---|---|---|---|
| 客户机网卡 DOWN,无 DISCOVER | 客户机 netplan/cloud-init | dnsmasq 日志零报文,ip link 显示 DOWN | 预置 01-dhcp.yaml,确认 networkd 运行 |
| 有 DISCOVER 无 OFFER | dnsmasq 或网桥 | dnsmasq 日志只见 DISCOVER;ss 查不到 br0:53 | 检查 interface=br0 与 bind-dynamic,重启实例 |
| 拿到地址但 ping 不通网关 | 网桥/tap 接线 | tap0 无 master br0,或状态非 forwarding | ip link set tap0 master br0,查 bridge link |
| 网关通、公网 100% 丢包 | FORWARD 链 DROP | iptables -S FORWARD 无 br0 出站 ACCEPT | 补双向 ACCEPT,回程限 RELATED,ESTABLISHED |
| 公网 IP 通、域名解析失败 | DNS 下发或解析路径 | resolvectl 状态异常,getent 无结果 | 确认 dhcp-option dns-server 指向 10.88.0.1 |
| 多客户机地址冲突 | 地址池或静态占用 | dnsmasq 日志出现租约告警 | 收窄 dhcp-range,静态地址避开分配池 |
表中第四行就是本轮实验的第一轮失败,第三行与第四行的分界点是「网关通不通」:网关不通回到二层查网桥,网关通而公网不通直接查三层转发。另外两个运维习惯值得固定下来:改完规则用 iptables -S 与 ss -ulnp 留一份快照,实验台的最终状态就保存在 host-net-state.log 这类记录里;dnsmasq 单独跑实例并开 log-dhcp,排错时能按 MAC 地址追溯每台客户机的完整租约历史,比抓包轻量得多。
实验环境
- 机器/系统:云主机 2C8G / Ubuntu 22.04.5
- 工具版本:QEMU(qemu-system-riscv64,客户机 Ubuntu 24.04.5 RISC-V)、bridge-utils/iproute2、dnsmasq 2.91、iptables(legacy 接口)
- 实验网段:10.88.0.0/24,网关 10.88.0.1,DHCP 池 10.88.0.50-10.88.0.150
- 日期:2026-11-08
- 完整命令序列:主机侧
./setup-host.sh完成建桥、转发、NAT 与 dnsmasq 启动;客户机侧./boot-tap.exp经串口自动登录后执行地址路由查看、网关与公网 ping、DNS 解析探针,两轮实验之间仅插入 FORWARD 规则变更,输出即本篇引用的全部实录。
代码获取:本篇实验的可复现脚本见公开仓库 derekzhuo/geek-doc.cn 的
experiments/qemu-tap-bridge-network目录。克隆后先按qemu-riscv-linux-distro的说明准备云镜像(含预置 netplan 步骤),再依次执行./setup-host.sh与./boot-tap.exp,即可复现两轮探针与 dnsmasq 四次交换日志。
这一篇在知识体系里的位置
本篇是 SoC 与 QEMU 入门路线的网络进阶篇,与两篇 SLIRP 文章构成完整的网络三连片:QEMU SLIRP 用户网络 解决「零配置出网」,QEMU hostfwd 端口转发 解决「NAT 后入站」,本篇解决「真实二层接入与主机直达」。客户机的自动化登录与探针注入走的是串口控制台,三种控制台接线方式见 QEMU 串口与控制台接线:nographic、serial 与 monitor。再往后,多台客户机通过同一 br0 互通、用 tc 在网桥上注入延迟与丢包做网络故障注入,都是在这套四件套之上继续叠加。
总结
QEMU tap 桥接用 tap 设备加 Linux bridge 把客户机接进真实二层:tap0 作为桥端口承接客户机帧,br0 兼当 10.88.0.1 网关,独立 dnsmasq 经 DISCOVER、OFFER、REQUEST、ACK 四次交换分配 10.88.0.65 并下发网关与 DNS,iptables 一边在 FORWARD 链放行 br0 与 eth0 间的双向流量、一边在 POSTROUTING 做 MASQUERADE。两轮对照实验钉住最隐蔽的坑:FORWARD 默认 DROP 时客户机网关零丢包而公网百分之百丢包,补两条 ACCEPT 后公网立即零丢包;而网卡 DOWN、零 DISCOVER 的症状则要回到客户机,用预置 netplan DHCP 配置修复 cloud-init 留空的目录。与 SLIRP 相比,桥接以 root 权限和四个部件的代价,换来可路由地址、内核级数据通路与对外提供服务的能力。