qcow2 backing file:增量链原理与秒级克隆虚拟机的写隔离实测
本篇是入门路线第 05 篇。第一次接触虚拟机的读者建议从第 01 篇 认识 QEMU:从零看懂虚拟机、镜像与快照 开始,那里用生活类比解释了宿主机、客户机与镜像;本篇直接进入多文件镜像链的实验。
装一台虚拟机要多久?如果每开一台都复制一份 20GB 的系统盘,十台就是 200GB 磁盘和几分钟的等待。qcow2 的 backing file 机制把这件事压缩到一条命令、一瞬间和 196KiB 的实际占用:基础镜像只存一份,每台虚拟机各自挂一个几乎不占空间的增量层。本篇是 qcow2 镜像管理三件套的第二篇,环境准备与第一个虚拟平台的搭建见 QEMU 安装与第一个 RISC-V 虚拟平台,镜像创建、信息查看与格式互转的基础操作见 qemu-img create/info/convert 实操,快照、扩容与压缩见 qcow2 扩容、压缩与快照管理。
本文要回答的问题
- backing file 增量链到底是怎么存数据的,为什么新建一个 overlay 只有 196KiB?
- 多个 overlay 共享同一个 base 时,一台虚拟机写磁盘会不会污染另一台?
- 「读穿透」是什么意思,本层没有的数据从哪里读回来?
- base 文件被改名或挪位置后,overlay 会报什么错,为什么
qemu-img info却看起来正常? rebase -u为什么能秒修断链,它和普通rebase的代价差别在哪?
一、增量链原理:一个 base,多个薄薄的 overlay
普通 qcow2 镜像把 Guest 写下的每个簇(cluster,本篇环境里簇大小是 65536 字节)都存在自己文件内部。backing file 给 qcow2 增加了一条「向上找」的路径:创建镜像时用 -b 指定一个已存在的镜像作为 backing file(也称 base),新镜像本身成为 overlay,它的元数据里只记下 base 的文件名与格式,不复制 base 的任何数据。
于是一条 backing 链就形成了:overlay 在最上层,base 在下层,链还可以继续延伸(overlay 再当别人的 base)。读和写在这条链上的规则完全不同,这是理解整个机制的两把钥匙。
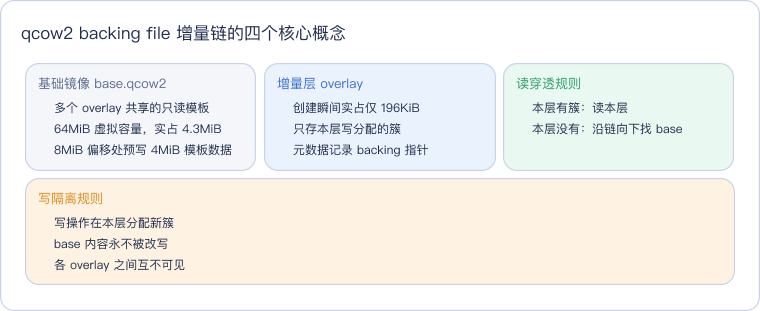
这张概念卡把全篇的实验结论提前压缩在一页里:base 是共享的只读模板,overlay 是各自独立的增量账本;读的时候从上往下找,写的时候只动自己这一层。后面的每一步实验,本质上都是在给这张卡片的某一条提供证据。
读路径与写路径的分流值得再用一张流程图看清。Guest 发起一次磁盘访问时,qcow2 驱动先查 overlay 自己的 L2 表:这个簇在本层有没有被分配过?读操作查不到就沿 backing 指针向下一层要数据,层层穿透直到链尾;写操作则根本不向下看,直接在本层分配一个新簇并落盘,之后对同一位置的读都会在本层命中,base 里的旧数据被自然「遮蔽」。
图中灰色是两个 overlay 共同指向的 base,蓝色是各自独立的增量层,绿色读路径允许向下穿透,橙色写路径则封闭在本层。这套结构直接解释了「秒级克隆」:克隆一台虚拟机不需要复制数据,只需新建一个记录 backing 指针的 overlay,耗时与磁盘开销都和镜像大小无关,只与创建元数据有关。
二、创建 overlay 与 info 查链:196KiB 的克隆
实验先构造一个带模板数据的 base:建一个 64MiB 的 qcow2 镜像,然后在 8MiB 偏移处写入 4MiB 字节模式 0x55,模拟一个预装了系统或数据的模板盘。写入后 base 的真实占用是 4.3MiB——64MiB 是 Guest 看到的虚拟容量,只有真正写过的簇才占宿主磁盘。
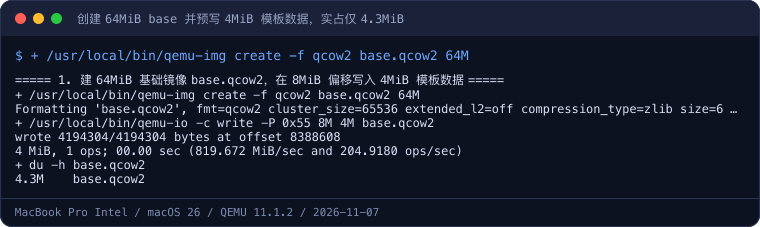
注意 create 输出里的格式参数:cluster_size=65536 说明本环境默认簇大小是 64KiB,size=67108864 正好是 64MiB。紧接着的 qemu-io -c write -P 0x55 8M 4M 在镜像内部写入,-P 指定填充字节、后面三个参数依次是偏移和长度,wrote 4194304/4194304 bytes 表示 4MiB 全部写完。
有了 base,克隆两台虚拟机就是两条 create -b 命令。-b base.qcow2 指定 backing file,-F qcow2 显式声明 base 的格式——这个 -F 不要省,省略时 QEMU 要靠探测判断 base 格式,历史上出过格式探测被恶意镜像利用的安全问题,现代工程实践一律显式写死。
qemu-img create -f qcow2 -b base.qcow2 -F qcow2 vm1.qcow2
qemu-img create -f qcow2 -b base.qcow2 -F qcow2 vm2.qcow2
qemu-img info vm1.qcow2
qemu-img info 的输出是查链的第一手段。日志里 vm1 的信息明确打印了 backing file: base.qcow2 与 backing file format: qcow2,这两行就是 overlay 元数据里的指针;同时 disk size: 196 KiB 给出了最直观的证据——一个虚拟容量 64MiB 的镜像,真实占用只有 196KiB,因为它一个数据簇都还没写过,文件里只有头部、L1/L2 表这些元数据。du 同时对比三个文件:base 4.3M,vm1 和 vm2 各 196K。两台「克隆虚拟机」加起来不到 400KiB 额外开销,这就是秒级克隆的全部成本。
这里提前交代一个后面会反复用到的工具:qemu-io。它是 QEMU 自带的块设备练习器,可以直接对 qcow2 镜像发 read/write 命令,本篇全部读写验证都靠它,而不是 qemu-img dd。原因有两个:在 macOS 上把字符设备交给 qemu-img dd 读,常常读到 0 字节就返回;更危险的是,dd 按 raw 语义重写整个文件,会把 overlay 的 qcow2 结构连同 backing 指针一起破坏掉。qemu-io -c 'write -P 字节 偏移 长度' 镜像 则始终在 qcow2 格式层内部操作,写入会正常走写分配流程,backing 链完整保留。
三、写隔离实验:写 vm1,base 和 vm2 都不动
机制讲完,用实验把四条规则逐条坐实。先在 vm1 的头部(偏移 0)写 4MiB 的 0xAB,然后分别从三个位置把数据读回来对照。
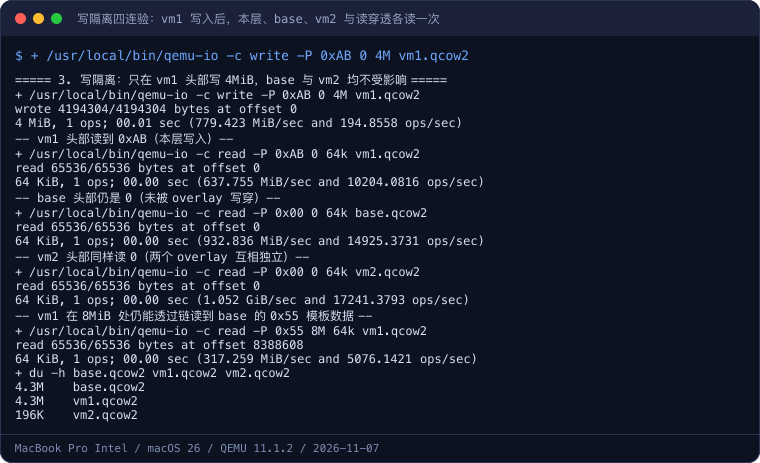
qemu-io 的 read -P 是「读并校验」模式:读出的数据必须与给定字节完全一致,否则命令报错,所以这张卡里每条 read 能正常返回 read 65536/65536 bytes 就等于断言通过。四个读数按顺序说明了四件事。
第一,vm1 头部 64KiB 读出 0xAB,与刚才的写入一致,说明本层写入立即可读。第二,直接读 base 的同一位置,校验字节是 0x00——base 头部从未被写过,仍然是 qcow2 零簇的全零状态,vm1 的写没有「穿」下去。第三,vm2 头部同样读出 0x00,证明两个 overlay 虽然指向同一个 base,但彼此的增量数据互不可见,一台机器的磁盘活动对另一台完全透明。第四,也是最能体现读穿透的一条:在 vm1 的 8MiB 偏移处读,校验值是 base 里预写的 0x55。这个位置 vm1 自己从没写过,L2 表查不到对应簇,请求沿 backing 指针穿透到 base,把模板数据原样读了回来。
最后的 du 给出了体积侧的佐证:base 仍是 4.3M,vm2 仍是 196K,只有 vm1 从 196K 涨到 4.3M——多出的约 4MiB 正好对应它在本层新分配的那些簇。三张表一起看,写隔离的账本就闭合了:增量只记在写入者自己名下,共享部分一个字节都不重复。
四、断链报错答案块:base 改名之后
backing 指针存的是文件路径字符串,这意味着它不是硬链接,base 一旦改名或挪目录,链就断了。本篇在实验里主动 mv base.qcow2 base-renamed.qcow2 制造断链,把报错现象、判据和修复完整复现一遍。
症状:info 正常,check 和读写立即失败
断链后第一个反直觉的现象是:qemu-img info vm1.qcow2 居然成功返回,退出码 0,backing file: base.qcow2 一行原样打印,只是这个路径已经指向一个不存在的文件。原因是 info 的工作方式是「只读本文件头部的元数据」,它把指针字符串展示给你,并不真的去打开 backing file。而 qemu-img check 和任何实际读写都必须沿链打开下层镜像,于是立刻失败。
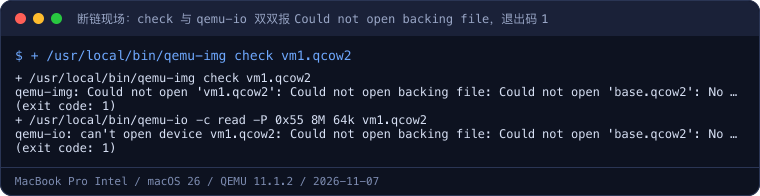
两条报错原文值得逐字记住,搜索引擎里的同类问题几乎都是这个句式:
qemu-img: Could not open 'vm1.qcow2': Could not open backing file: Could not open 'base.qcow2': No such file or directory
(exit code: 1)
qemu-io: can't open device vm1.qcow2: Could not open backing file: Could not open 'base.qcow2': No such file or directory
(exit code: 1)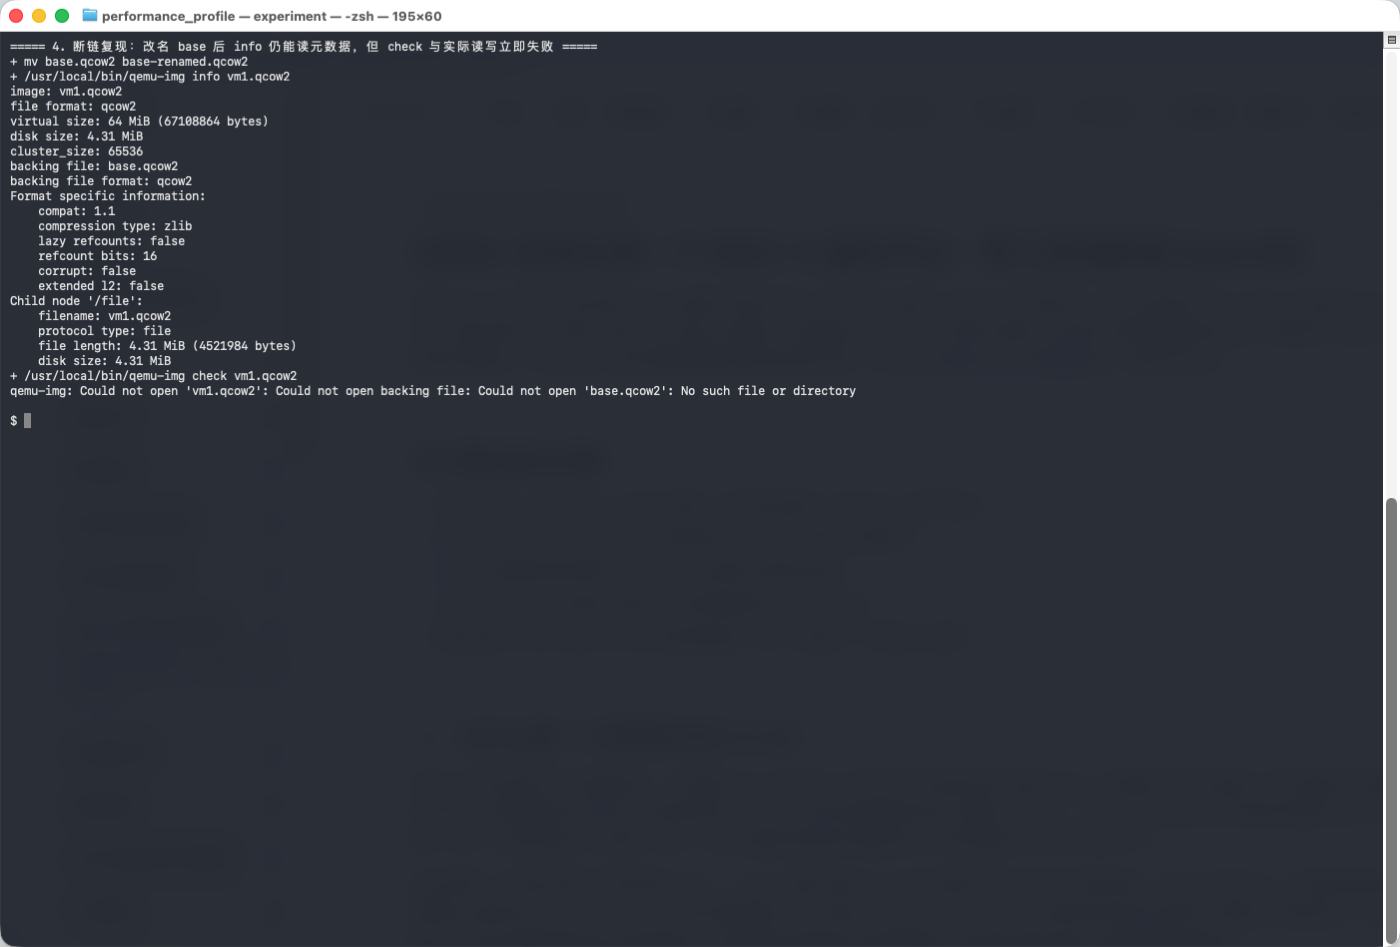
图里上下两半的反差就是断链最迷惑人的地方:上半屏 info 照常输出 backing file: base.qcow2 与全部容量字段,看上去一切正常;下半屏 check 直接抛出 Could not open backing file。元数据读取与沿链读写走的是两条路径,这张图把二者的分界画得清清楚楚。
报错是嵌套的三层结构:外层说打不开 vm1,中层点明原因是打不开 backing file,最内层给出操作系统级的事实——base.qcow2 不存在。qemu-io 的措辞略有不同(can't open device),但中后两层完全一样。看到 Could not open backing file 这个锚点,就可以直接把排查方向锁定在链路上,而不是怀疑 overlay 本身损坏。
复现与根因
复现只要两步:先确认 overlay 的 info 输出里 backing file 指向哪个路径,再到对应目录确认该路径是否还存在。本篇的根因就是一次普通的 mv:overlay 元数据里的指针仍写着旧名 base.qcow2,而磁盘上的文件已经叫 base-renamed.qcow2,字符串对不上,打开失败。真实环境里的常见诱因还包括 base 被挪到其他目录、用相对路径创建的 overlay 换了工作目录、以及备份恢复时只恢复了 overlay 没恢复 base。
修复:rebase -u 只改指针
qemu-img rebase 就是用来改 backing 指针的命令,关键参数是 -u(unsafe mode)。带上 -u 时,rebase 只重写 overlay 元数据里的文件名字符串,不读不写任何数据簇,瞬间完成;它「unsafe」的地方在于不校验新 base 的内容是否与旧 base 一致,需要操作者自己保证新 base 就是原来那个文件(或内容兼容的副本)。
qemu-img rebase -u -b base-renamed.qcow2 -F qcow2 vm1.qcow2
qemu-img rebase -u -b base-renamed.qcow2 -F qcow2 vm2.qcow2
如果不带 -u,rebase 会走安全模式:把旧 base 中所有仍被本 overlay 依赖的数据簇合并进 overlay,再切换指针。安全模式的数据一致性由工具保证,但代价是大量真实 IO,镜像越大越慢;明确知道新 base 就是旧文件改名而来的场景,-u 是正确选择。
验证:链上读取恢复
修复后先用 info 确认指针已更新,日志显示 backing file: base-renamed.qcow2,本层 disk size 仍是 4.31MiB,没有任何数据搬运的痕迹。再做一次穿透读取:
+ /usr/local/bin/qemu-io -c read -P 0x55 8M 64k vm1.qcow2
read 65536/65536 bytes at offset 8388608
64 KiB, 1 ops; 00.00 sec (393.082 MiB/sec and 6289.3082 ops/sec)
vm1 在 8MiB 处重新读到了 base 的 0x55 模板数据,说明链路已通。整个「发现断链 → 修复 → 验证」的决策路径如下。
图中红色是故障的两个面(现象与根因),蓝色是排查动作,橙色是修复,绿色是验证终点。记住「info 成功不代表链健康」这条判据,断链类问题在一分钟内就能分诊清楚。
五、运维注意事项:把链管起来
backing 链在带来极致克隆效率的同时,也把一个隐式依赖写进了元数据:每个 overlay 的可用性都攥在它链上所有下层文件手里。生产环境里有四条经过实测验证的管理纪律。
第一,base 创建后转为只读对待。模板镜像装好系统、灌完数据后去掉写权限(chmod -w base.qcow2),从机制上杜绝误写。一旦 base 内容变化,所有 overlay 的读穿透结果都会跟着变,而 overlay 里已分配的簇又遮蔽了部分旧数据,整盘数据会进入无法推理的混合状态,没有安全的回头路。
第二,迁移 base 必须带着 rebase 一起做。改名、挪目录、换存储池之后,对每个受影响的 overlay 执行 rebase -u 指向新路径;跨机迁移则要保证 overlay 与 base 的相对关系一起搬过去。优先用绝对路径还是相对路径取决于场景:绝对路径不怕工作目录变化但怕整机迁移,相对路径便于整目录搬迁但要求调用位置固定。
第三,链不宜过长。每多一层,读穿透就要多查一层 L2 表,长尾读的延迟随链长累积;任何一层文件丢失,整条链尾部全部不可用。常见做法是 base 加一层 overlay 封顶,需要扁平化时用 qemu-img convert 把整条链烤成一个独立镜像,转换的完整用法见 qemu-img create/info/convert 实操。
第四,删除 base 之前先确认没有 overlay 引用它。qemu-img info --backing-chain 可以沿链把每层信息一路打印到链尾,是盘点依赖关系的标准命令;配合 check 定期巡检,能在虚拟机启动失败之前发现断链。快照与 backing file 同样依赖 qcow2 的元数据机制,两者的区别和配合方式见 qcow2 扩容、压缩与快照管理。
这一篇在知识体系里的位置
本篇是 SoC 与 QEMU 系列中 qcow2 镜像管理簇的第二篇,专注 backing file 这一条增量链机制。向上承接环境与镜像基础:QEMU 安装与第一个 RISC-V 虚拟平台 给出了 QEMU 11.1.2 的安装环境与第一个 qcow2 镜像,qemu-img create/info/convert 实操 讲清 virtual size 与 disk size 的区别以及格式互转。横向与快照机制对照阅读:qcow2 扩容、压缩与快照管理 里的内部快照与本篇的 overlay 是同一套「元数据加增量」思想的两种产品形态。再往后,backing file 会直接用在虚拟机模板分发、差分磁盘批量开机与虚拟平台快照回滚的实战里。
代码获取:本篇五步实验(base 预写、双 overlay 克隆、写隔离四连验、断链复现、rebase 修复)的可复现脚本见公开仓库 derekzhuo/geek-doc.cn 的
experiments/qemu-qcow2-basics/目录。克隆后执行./03-backing-file-clone.sh即可在output/03/重新生成全部镜像与完整日志。
实验环境
机器/系统:MacBook Pro(Intel x86_64)/ macOS 26
工具版本:qemu-img 11.1.2、qemu-io 11.1.2(Homebrew 安装的 QEMU 工具集)
日期:2026-11-07
完整命令序列:
bashqemu-img create -f qcow2 base.qcow2 64M qemu-io -c 'write -P 0x55 8M 4M' base.qcow2 qemu-img create -f qcow2 -b base.qcow2 -F qcow2 vm1.qcow2 qemu-img create -f qcow2 -b base.qcow2 -F qcow2 vm2.qcow2 qemu-img info vm1.qcow2 qemu-io -c 'write -P 0xAB 0 4M' vm1.qcow2 qemu-io -c 'read -P 0xAB 0 64k' vm1.qcow2 qemu-io -c 'read -P 0x00 0 64k' base.qcow2 qemu-io -c 'read -P 0x00 0 64k' vm2.qcow2 qemu-io -c 'read -P 0x55 8M 64k' vm1.qcow2 mv base.qcow2 base-renamed.qcow2 qemu-img info vm1.qcow2 qemu-img check vm1.qcow2 qemu-io -c 'read -P 0x55 8M 64k' vm1.qcow2 qemu-img rebase -u -b base-renamed.qcow2 -F qcow2 vm1.qcow2 qemu-img rebase -u -b base-renamed.qcow2 -F qcow2 vm2.qcow2 qemu-img info vm1.qcow2 qemu-io -c 'read -P 0x55 8M 64k' vm1.qcow2
总结
qcow2 backing file 用「一个只读 base 加多个薄 overlay」的增量链实现秒级克隆:overlay 初始只占 196KiB,读请求在本层未命中时沿指针穿透到 base,写操作只在本层分配新簇,实测写 vm1 后 base 与 vm2 都不受影响、vm1 仍能从 8MiB 处读回 base 的 0x55 模板数据。断链时记住关键判据——qemu-img info 退出码 0 只说明本层元数据可读,check 与实际读写报 Could not open backing file(退出码 1)才暴露指针失效;确认新 base 是旧文件的等价物后,用 rebase -u 只改元数据指针即可秒修,再以一次链上穿透读取作为验证。