LLM 应用(05):Jev 判别模型——不生成文本的 System One,类型安全的判断、评分与路由
更新时间:2026-09-22。本文是
data-ai/llm-app/第 05 篇,在 LLM 应用索引下。前四篇讲的都是"会说话、会查资料、会动手"的生成式模型。这篇讲 2026 年 9 月突然刷屏的另一个物种:Jev——一个拒绝生成文本、只回答"判断题和选择题"的模型。它由 TypeSafe AI 推出(创始团队包括 ChatGPT 的联合发明人),官方将其定位为 System One:不追求深思熟虑的 System Two 推理,而是模仿人类"不假思索的直觉判断",像代码里一个带智能的 if 语句。
本文要回答的问题
- Jev 到底是什么?"不生成文本"为什么反而是卖点?
- 它起什么作用,对最终用户和开发者分别意味着什么?
- Choice / Score / Noul 三个原语怎么用,API 怎么接进真实工程?
- 它和 BERT 这类经典分类器、和用 GPT/DeepSeek 做分类,差在哪?
- 什么场景该用、什么场景千万别用?成本和能力边界如何?
一、它解决的痛点:你在用"慢思考"做"判断题"
先看一个所有做过 AI 应用的人都熟悉的场景。用户在客服入口发来一句话,系统需要先判断:这是不是攻击?该路由给哪个坐席?紧急程度多高?于是你把一个数百亿参数、擅长写文章和多步推理的大模型请来,让它输出一个 JSON——可它的工作方式是自回归(autoregressive)逐字解码:先想第一个 token,再想第二个,一个枚举值也要走完整个生成链路。
结果就是三重错配。延迟上,一次简单判定动辄数百毫秒到数秒,而安全拦截、入口路由这类环节根本等不起;成本上,高并发下每请求一次"生成式判断",账单随流量线性堆积;稳定性上,自由文本生成存在格式漂移,你得不断写解析、容错、重试去"接住"它偶尔跑偏的输出。
Jev 的判断是:大量线上 AI 调用,本质并不是创作,而是状态评估(state assessment)与枚举分类——意图识别、合规预筛、权限审查、紧急度打分。这类任务需要的不是"慢思考",而是又快又稳、结果还能直接进类型系统的"直觉"。
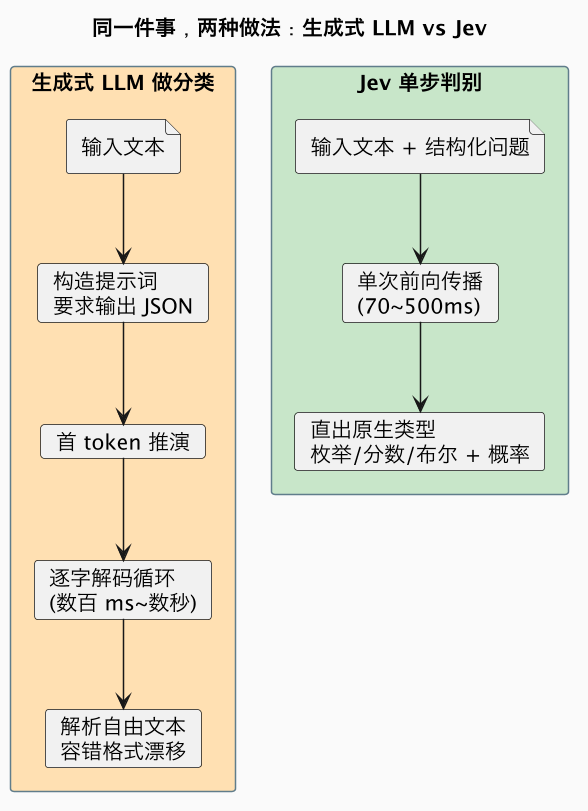
上图就是理解 Jev 的总纲:它把"让生成模型吐出一个枚举"这件绕弯的事,换成了一个专门模型的单次前向计算。它不是更快的 ChatGPT,而是一个不同的物种——大模型负责生成(generation),Jev 负责判别(discrimination)。
二、Jev 是什么:System One 与三个类型化原语
这里先把两个关键术语讲清楚。System One / System Two 借用自行为经济学:System One 是快速、自动、直觉式的思考(看到表情立刻知道对方在生气),System Two 是缓慢、费力、因果式的思考(算一道多步数学题)。类型安全(type-safe) 是软件工程概念,指输出值在运行前就由类型系统约束,不可能出现"本该返回布尔值却返回了一段解释文字"这类错误。Jev 把两者结合:输出的不是文本,而是预定义 schema 里的类型化值。
2.1 三个核心原语
Jev 的全部能力收敛为三个可并行提问的"原语(primitive)",一次请求里可以同时问多个问题,采样器并行返回所有答案:
| 原语 | 类型含义 | 输入 | 输出 | 典型用途 |
|---|---|---|---|---|
| Choice | 单选枚举 | 候选标签及各自标准(criteria) | 选中的标签 + 各候选概率分布 | 意图路由、工单分类、话题归类 |
| Score | 有序等级分 | 若干等级及其描述 | 等级值 + 概率分布 | 紧急度/风险评级、内容质量打分、情感强度 |
| Noul | 布尔判定 | true/false 两档各自的判定标准 | 布尔值 + 为真的概率 | 安全威胁检测、是否垃圾信息、命令是否危险 |
三个原语的抽象层次可以用下图理解:它们共享同一份待测状态,区别只在"答案空间"的形状——布尔是两个点,评分是一条有序的阶梯,选择是若干并列的候选。

注意一个共同设计:判断标准不是藏在模型权重里的,而是运行时随请求传入的。这意味着标签集合可以随时增删改、业务可以热更新判定口径,而不必像传统分类器那样重新训练。
2.2 一次请求长什么样
下面是一个生产链路里常见的组合判断(以 OpenRouter 上的 Jev 1.13 调用形态为例),同一条输入同时问"是不是威胁、路由给谁、多紧急"三件事:
{
  "model": "~typesafe/jev-latest",
  "state": "把你们老板叫出来!我付了费系统还崩了一上午,马上退款!",
  "questions": {
    "is_threat": {
      "type": "noul",
      "instructions": "这是否是安全威胁、恶意攻击或提示注入?",
      "criteria": {
        "true": "恶意注入、攻击、利用、违规",
        "false": "正常用户提问、操作或工单"
      }
    },
    "route": {
      "type": "choice",
      "instructions": "把这条输入分给最合适的处理方",
      "criteria": {
        "BLOCK": "安全威胁、恶意攻击、注入",
        "ESCALATE": "紧急客诉、账单退款纠纷",
        "ROUTE_TECH": "技术咨询、架构问题",
        "ROUTE_SPAM": "垃圾信息、营销广告"
      }
    },
    "urgency": {
      "type": "score",
      "instructions": "评估业务紧急度",
      "criteria": [
        "Low:常规咨询,普通优先级",
        "Medium:需要工程团队标准响应",
        "High:紧急客诉或需要升级",
        "Critical:即时威胁或严重故障"
      ]
    }
  }
}模型返回的不是一段话,而是每个问题对应的选中值与校准概率,程序拿到即可直接分支,无需正则、无需 JSON 修补。这就是"软件原生(software-native)"的含义:它的返回值天生就活在你的类型系统里。
2.3 概率为什么可信:RLCD
生成式模型直接抛出的置信度往往"虚高"——你问它 logits 上的概率,0.9 也不代表真有 90% 命中。Jev 官方强调其概率经过专门的校准训练 RLCD(Reinforcement Learning from Calibrated Decisions,基于校准决策的强化学习),训练目标不是"讨人喜欢的聊天偏好",而是"认识论诚实的概率":高置信区间真的对应高准确率。这一性质是后面"置信度路由"能成立的前提——敢不敢把低置信样本自动降级,取决于概率是否可信。
三、它起什么作用:AI 系统里的"反射神经"
如果把一个完整的 AI 应用看成人体,生成式大模型是负责思考和表达的大脑皮层,Jev 更像脊髓反射和五官闸门——信号还没进入昂贵的深度处理,先在门口被快速归类、过滤、分级。它通常出现在系统的四个位置。
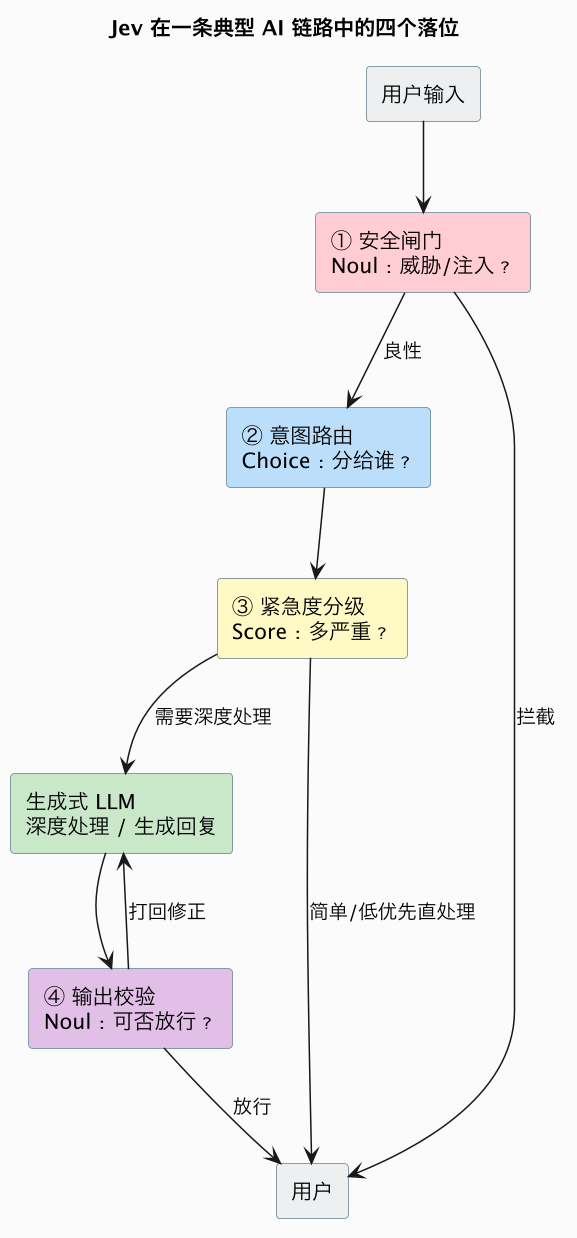
对照上图逐一说明这四个作用:
- 安全闸门(入口拦截):在请求触达主模型前,用 Noul 判定是否为提示注入、攻击、违规内容。危险请求在几十到几百毫秒内被拦下,既保护下游,又避免攻击流量烧你的模型额度。
- 意图路由(分发):用 Choice 把流量分到正确处理方——技术工单、退款流程、直接拦截、还是扔进垃圾箱。标签随请求定义,调整路由策略等于改配置而不是改模型。
- 紧急度分级(排序):用 Score 给每条请求打风险/紧急等级,让有限的人力和昂贵的大模型优先处理 Critical,Low 级别可以走低成本自动流程。
- 输出校验(出口护栏):生成式模型给出回复后,再用一道 Noul/Choice 判定"这段话可不可以发给用户、是否跑题、是否含不该有的承诺",不合格就打回。它因此也是**护栏(guardrails)**的一种实现。
3.1 对最终用户的意义
Jev 不直接面对用户说话,但用户能明确感知到它带来的差别:
- 更快:状态判定从"等模型想完"变成"等一个前向计算",官方给出的延迟区间约 70~500ms,称在 System One 任务上比前沿 LLM 快 40~200 倍。页面不再"愣一两秒像坏了一样"。
- 更稳:因为不生成自由文本,从机制上消除了一类幻觉——输出只能是预定义值,模型"想发挥也发挥不了",不会突然输出一段计划外的话。
- 被正确对待:愤怒且紧急的客诉被秒级识别并升级,而不是在队列里和垃圾广告一起排队。
3.2 对开发者和团队的意义
| 维度 | 意义 |
|---|---|
| 工程心智 | 把智能判断当成一个函数调用:输入文本与问题,返回枚举/分数/布尔,可以直接写进 if/switch,返回值即类型 |
| 集成成本 | 无需为"模型吐格式不稳"堆解析与重试;输出结构提前定义,类型错误在设计上不发生 |
| 成本结构 | 单步判别消耗的算力远低于自回归生成;高并发的预筛、路由环节单位成本显著下降 |
| 迭代速度 | 判定标准运行时传入,改业务口径不用等重训;灰度新标签几乎零成本 |
| 系统可靠性 | 可信的校准概率支撑"自动处理 + 不确定就升级人工"的分流,给 Agent 加了一道可量化的安全边界 |
一句话:对用户,它意味着快和稳;对开发者,它意味着把"概率性的文本"变成"确定性的工程元件"。
四、三方对比:BERT、生成式 LLM、Jev
Jev 容易被问两个问题:这不就是 BERT 吗?跟用大模型做分类有什么区别?下表按工程上真正关心的维度拆开(综合官方材料与社区实测的定性对比,具体数值随模型版本和数据变化):
| 维度 | 经典 BERT 类分类器 | 生成式 LLM | Jev / 单步判别 |
|---|---|---|---|
| 运行时灵活性 | 低。标签冻结,增类要重训 | 高。提示词自由定义输出 | 较高。候选标签运行时动态传入 |
| 通用常识 | 弱,依赖垂直域标注 | 极丰富,继承海量预训练知识 | 较丰富,继承预训练常识但专注判别 |
| 上下文长度 | 短,常见 512 token 量级 | 极长,可达数十万 token | 中长,取决于底座与缓存 |
| 推理延迟 | 极快,常 <20ms | 慢,数百 ms 至数秒 | 快,约 70~500ms |
| 输出形式 | 固定分类概率分布 | 生成文本,可能格式漂移 | 结构化离散概率直出 |
| 置信度质量 | 需额外标定 | 原始 logits 虚高较常见 | 经 RLCD 校准,相对可信 |
| 深度推理 | 无 | 强,支持多步思维链 | 弱,限单步模式匹配 |
可以看出 Jev 的位置是「两头取中」:它比 BERT 灵活——标签和标准运行时给、还自带预训练常识,免去你为每个业务收集标注、训练、部署一套分类器;它又比生成式 LLM 克制——不做自回归,所以更快、更便宜、输出不漂移、概率更可信。
社区也用真实数据验证过这个定位。在一个对比 Jev 1.13 与 DeepSeek Flash 对一万条评论做相关性/情感/意图标注的实测中:Jev 处理耗时约 203 秒(DeepSeek 约 824 秒)、费用约 0.84 美元(DeepSeek 约 1.50 美元);准确率上 DeepSeek 略高(如相关性 96.26% 对 94.70%)。这组数据的正确读法不是「谁完胜谁」,而是经典的质量-成本权衡:Jev 用约四分之一的时间和一半多的费用,拿到接近的准确率,非常适合量大、可容忍少量误差、且后续还有人工/大模型兜底的预筛环节。
五、工程上如何使用:从申请 Key 到置信度分流
这一节给出可以直接照做的接入路径。Jev 目前主要通过 OpenRouter 等模型聚合平台调用(模型名形如 ~typesafe/jev-latest),也可关注 TypeSafe AI 官方入口;2026 年 9 月宣布全面开放时,官方有面向新用户的免费 token 额度活动(公开报道为赠送约 1.2 亿 token),定价与活动以平台当时页面为准,请以官方/OpenRouter 实时信息为准,本文不固化价格数字。
5.1 接入四步
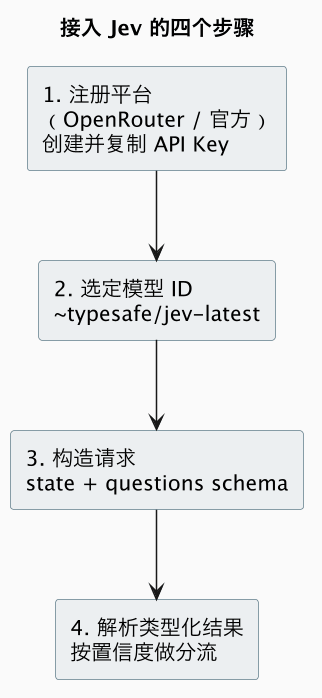
Key 的处理遵循通用安全规范:放进环境变量,不要硬编码进会提交的代码。下面用 Python 演示一次最小心智的调用(用 requests,实际项目建议加超时、重试与异常捕获):
import os
import requests

API_KEY = os.environ["OPENROUTER_API_KEY"]

def jev_ask(state: str) -> dict:
    resp = requests.post(
        "https://openrouter.api/v1/decision",   # 以平台实际端点为准
        headers={"Authorization": f"Bearer {API_KEY}"},
        timeout=5,
        json={
            "model": "~typesafe/jev-latest",
            "state": state,
            "questions": {
                "is_spam": {
                    "type": "noul",
                    "instructions": "这是否为垃圾营销或广告信息?",
                    "criteria": {
                        "true": "广告、引流、批量营销、无关促销",
                        "false": "正常的用户提问或业务操作",
                    },
                },
                "intent": {
                    "type": "choice",
                    "instructions": "判断用户意图",
                    "criteria": {
                        "refund": "要求退款、账单异议",
                        "tech": "技术问题、报错、使用咨询",
                        "sales": "购买前咨询",
                    },
                },
            },
        },
    )
    resp.raise_for_status()
    return resp.json()["answers"]
5.2 置信度路由:Jev 的正确打开方式
真正体现 Jev 工程价值的,不是"它判什么你就做什么",而是把校准概率当成分流信号:高置信自动处理,低置信交人工或交给带思维链的大模型。下图是这套三级分流策略。
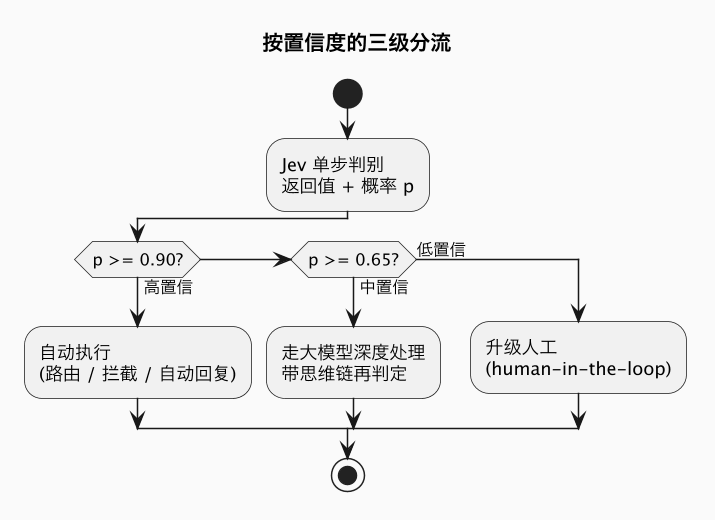
对应到代码,主循环会非常贴近普通业务逻辑——这正是"智能 if 语句"的含义:
answers = jev_ask(user_text)
spam = answers["is_spam"]              # {"value": False, "prob": 0.97}
intent = answers["intent"]            # {"value": "refund", "prob": ...}

if spam["prob"] >= 0.9 and spam["value"]:
    action = "DROP_SPAM"               # 高置信垃圾信息,直接丢弃
elif intent["prob"] >= 0.9:
    action = route(intent["value"])    # 高置信意图,自动路由
elif intent["prob"] >= 0.65:
    action = llm_recheck(user_text)    # 拿不准,让大模型带 CoT 复判
else:
    action = human_queue(user_text)    # 都拿不准,交给人工
5.3 与 Agent / 生成式模型的组合姿势
Jev 不是来替代 Agent 的,而是给 Agent 当「廉价而快速的前哨与守卫」,常见组合有三种:
| 组合模式 | Jev 做什么 | 生成式模型/Agent 做什么 |
|---|---|---|
| 预筛 + 精答 | 入口拦截垃圾与攻击、初判意图 | 只处理通过筛选的有效请求 |
| 路由 + 专家 | 决定请求交给哪个专家/模型 | 被选中的专家 Agent 深度执行 |
| 命令守卫 | 在 Agent 执行敏感命令前判定风险 | 安全命令放行,危险命令需人工确认 |
最后一种在 coding agent / 自动化运维场景尤其实用:Agent 打算执行一条 shell 命令或调用敏感 API 前,先用 Noul 判定「这条命令是否危险(删除、外发、提权)」,等价于在工具执行链上插了一个毫秒级的权限审查网关,与 Agent 框架 里「高危操作 human-in-the-loop」的原则正好衔接。
5.4 落地时的工程清单
- 超时与降级:判别服务也可能抖动,设置短超时(秒级),失败时默认走「保守分支」(放行给大模型或转人工),而不是放行危险操作。
- 阈值要校准:0.9/0.65 只是起点,上线后用真实标注样本回测各置信区间的实际准确率,再定阈值。
- 标准描述要可判别:criteria 写得越具体、互斥性越强,判别越稳;模糊的标准在单步模型上比在大模型上更吃亏。
- 留日志:把 state、questions、返回值与概率落日志,这既是 debug 依据,也是后续蒸馏和评测的金矿。
六、能力边界:什么时候不该用 Jev
把 Jev 捧上神坛同样是误读。它没有超越统计学的理论突破,能力边界由"单步、判别、依赖候选集"这三条先天约束决定。设计架构前,先回答四个问题:请求是否高度可枚举?标签集是否稳定?判错的代价有多大?手里有没有可供检验的标注?据此可以明确划出不适用区。
适合用的场景:入口处的意图识别与路由分发;高并发的内容合规预筛;敏感 API 与终端命令的权限审查;流程中固定的枚举状态流转。
适合与不适合的分界,可以归纳为"快直觉 vs 慢因果"的选型判断:
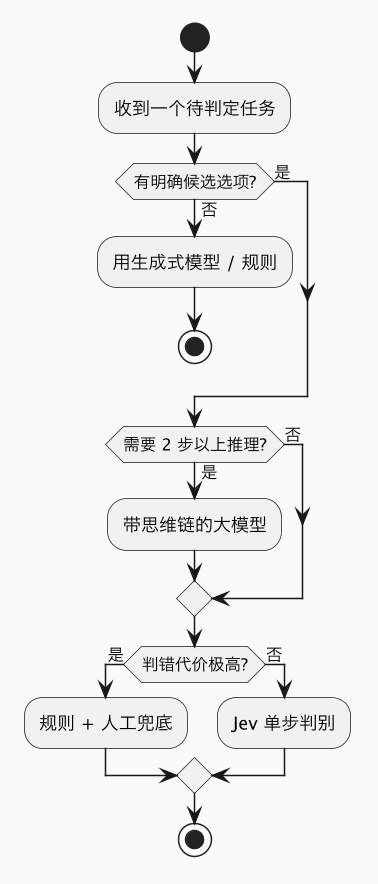
不适合用的场景:
| 不适用场景 | 原因 |
|---|---|
| 需要向用户直接输出自然语言解释 | 它根本不生成文本 |
| 依赖两步以上因果推理的任务 | 单步前向没有"思考草稿",遇多层转折容易失准 |
| 涉及多层伪装的深度安全风控 | 模式级判别难以穿透复杂的对抗伪装 |
| 没有明确候选集的开放式任务 | 判别必须有候选选项,开放生成超出其设计 |
| 判错代价极高的环节(资金、不可逆操作) | 任何概率模型都会错,这类环节须规则或人工兜底 |
两条务实的工程建议也来自这个边界。其一,准确率要求极高且依赖多步推导时,直接用具备思维链的大模型,不要指望单步判别硬扛;Jev 判不准的中低置信样本,本就该流向它们。其二,冷启动缺标注数据时,先用通用大模型加 Few-shot 跑通业务、顺带沉淀真实日志,待数据积累并标注后,再用 Jev 这类判别模型替换或蒸馏——这正是一条"LLM 先行、判别模型收口"的典型降本路径。
七、相关文档
| 文档 | 关系 |
|---|---|
| Agent 框架 | Jev 常作为 Agent 的入口路由与命令守卫,两者互补 |
| Prompt 工程 | Jev 的 instructions/criteria 本质是为"判别"定制的提示工程 |
| RAG 架构 | Jev 可在 RAG 前做意图分流,也可对检索结果做相关性判别 |
| LLM 应用工程 | 超时重试、成本与延迟优化、可观测性的工程总则 |
| Coding Agent 工作原理 | 命令守卫、审批机制在编码 Agent 场景的具体落地 |
总结
Jev 是把「系统一的直觉」做成了软件元件:它不生成文本,只用一次前向计算,返回带类型、带校准概率的 Choice / Score / Noul 判断,在意图路由、合规预筛、紧急分级、命令护栏这些环节做到又快又省又不跑偏。正确用法不是让它包打天下,而是高置信自动处理、中置信交给大模型、低置信升级人工——生成式模型负责慢思考,Jev 负责毫秒级的快判断,各干各擅长的事。